IC WORLD 2026 · BEIJING · 北京微电子国际研讨会

驭智拓芯途
强芯铸新篇

AI 赋能集成电路全链条 · 3D IC 与异质异构集成 · 器件领域全链条发展态势

以大会七场论坛、40 余场演讲与 46 幅实拍为一手素材,结合 WSTS / IEEE HIR / JEDEC / Nature·JSSC·TED 文献重构叙事:两条主线——3D IC × 异质异构集成AI 赋能全链条——交汇于器件可靠性

$0万亿全球半导体 2026E(WSTS Q2 修正后口径)
0µm量产混合键合间距 · 向 3µm 进发
0×AI 驱动芯片验证提速(Synopsys 2026)
106×可靠性寿命预测代理模型加速比
汇报时间 2026 年 9 月 · 北京原 PPT 66 页 → 重构为单页动态演示
◈ 光标移至芯片 · 立体拆分

半导体第一次不再只被制程定义——它被互连密度系统协同人工智能重新定义。先进封装把「 More than Moore 」从口号变成主战场,AI 把设计、制造、测试的方法学整体重写,而器件可靠性正在成为两条主线交汇处的最大蓝海。

01
$0.70万亿$1.65万亿

+108% 存储超级周期(Memory +305%),万亿时代提前四年。

见第一章
02
50µm6µm

互连密度提升约两个数量级,封装取代缩微成为带宽决定层。

见第二章
03
5 周<1 天

ChipStack L5 智能体把 RTL 验证循环压到一天内;EDA 滑向卖自主工作流

见第三章
04
TCAD 2.3h0.8ms

代理模型让退化预测进入毫秒级——可靠性变为设计时可算、运行时可测

见第四章
05
1/158192 条

单芯片算力差 15 倍,系统级互联可实现总量反超——差距在单点,机会在系统。

见第五章
格局 · LANDSCAPE

万亿美元超级周期:
存储狂奔、政策升格、三链融合

三个事实钉定产业坐标:市场以 +108% 冲破 1.6 万亿美元;集成电路升格「新兴支柱产业」;中国 70 年三链融合进入「新赛道」阶段。

1.1 市场 · 数字里的周期位置

存储 +305%:这不是普通上行,是 AI 需求对产能的重新定义

WSTS 春测 2026 市场 $1.51 万亿Q2 实际值上修至 $1.65 万亿(+108%)——存储 +305%、逻辑 +45%。HBM 与智算中心是本轮单一主引擎。

图 1 全球半导体市场规模与结构(2024–2027E,十亿美元)WSTS 2026 春测 + Q2 修正
柱内堆叠:存储 / 逻辑 / 其他。2026、2027 按 Q2 修正口径($1.65T / $2.1T)。数据源:WSTS FC-Release 2026-05、WSTS Q2 Release 2026-08
北京坐标
2500亿元

北京 IC 产业规模同比 +25%;亦庄 1300 亿、+71%,已集聚 400+ 家 IC 企业,前 8 月电子制造业 +38.5%、IC 制造增 1.1 倍。

结构信号
27%

北京 IC 产业年均复合增速;全国日均 Token 消耗量 2024→2026 增长约 1000 倍,「Token 工厂」成为晶圆需求的新底层变量。

周期判断
量价齐升的代价

存储涨价已挤压终端 BOM:需求集中于 AI 智算与 HPC,消费端被「挤出」。本轮周期对非 AI 链条并不普惠——读数时须分链条。

1.2 政策 · 三级框架

从「战略性新兴产业」到「新兴支柱产业」:一词之差,资源再配置

国家定调
集成电路 = 新兴支柱产业
2026 年政府工作报告,产业地位再升格
规划要求
「十五五」全链条攻关
电子信息制造业规划:关键核心技术攻关取得决定性突破
区域行动
北京 AI4Chip 20 条
≥30 亿基金 · 5000P 智算 · 2028 培育 3–5 家领军企业
图 1b 产业支撑逻辑:4C → 4I 切换大会政策解读
支撑体系由「应用牵引」切换为「智能牵引」,政策资源向 AI×IC 融合倾斜来源:大会主论坛
支撑逻辑升级

支撑体系从 4C(消费·通信·计算机·汽车)切换为 4I(智能·集成·交叉·创新):政策资源向 AI×IC 倾斜,智算基础设施提供确定性需求。

1.3 历程 · 70 年三链融合

从「四项紧急措施」到「新赛道 · 新生态」

1956 四项紧急措施 → 109 厂 → 908/909 工程 → 2000 中芯国际 → 2008 重大专项 → 三链融合新生态。来源:叶甜春院士大会报告 · 微电子所
技术积累
17

微电子所器件技术代际研发历程;FinFET 领域 2000+ 专利布局,2018 年中美专利交叉许可首开先河。

当前命题
摆脱路径依赖

先进制程受限的现实约束下,命题变为:开辟新赛道(先进封装/Chiplet/架构创新)· 打造新生态(设备-材料-零部件-EDA 协同)

深层瓶颈
定义权缺失

叶院士判断:先进封装技术路线图话语权缺失是国产化深层瓶颈——标准制定权 = 产业话语权,这正是第二章主线的出发点。

主线 A · 3D IC × HETEROGENEOUS INTEGRATION

异质异构集成:
当互连密度取代晶体管密度成为第一变量

3nm 之后,晶体管缩微对集成度的贡献降至约 50%,另一半由 DTCO 与封装接管。IEEE HIR 2025 把「异质集成」定义为将分别制造的部件集成为更高层级的组装体——本章按「机制 → 技术 → 市场 → 中国路径」拆解这场范式迁移。

2.1 机制 · 为什么是「异构」

三墙合围:数据搬运的成本已经超过了计算本身

算力墙 · 功耗墙 · 互连墙三面夹击。大会数据:AI 训练内存访问耗时超 60%、通信占 30–50%。破局的物理本质只有一个——把数据搬得更近

机制 ①
距离即能耗

片外 DRAM 访问能耗是片上 SRAM 的约 10–100 倍;互连距离每缩短一个量级,能耗与延迟同步下降——3D 堆叠把「片外」变「片间」。

机制 ②
密度按间距平方增长

互连密度 ∝ 1/pitch²:微凸点 ~50µm 间距 ≈ 400 互连/mm²,混合键合 ~10µm ≈ 10,000/mm²,亚微米级再增两个量级——物理上给「垂直方向」让出了带宽空间。

机制 ③
异构各取所长

逻辑用先进节点、SRAM/模拟/电源用成熟节点、光 I/O 用 III-V/硅光——不同工艺在封装内分工,摆脱单芯片工艺约束与良率惩罚(大 die 良率 ∝ 面积指数衰减)。

机制 ④
芯粒 = 可调度资源

Chiplet 把芯片从「固定整体」变为可拆、可合、可重构的物理资源池:多模型实时共存、弹性调度,Token 速度即生产效率(原力半导体大会报告)。

2.2 技术演进 · 互连密度三级跳(滚动查看)

STAGE 0 · 微凸点 Micro Bump

焊料时代的密度天花板
~40–50µm

传统 2.5D/倒装依赖 SnAg 焊料凸点,受桥连与寄生限制,间距停在 40µm 量级,互连密度约 400/mm²。HBM4 因 JEDEC 放宽堆叠高度而继续沿用微凸点——混合键合进入存储推迟到 HBM4E/HBM5。

STAGE 1 · 混合键合 Hybrid Bonding

Cu-Cu 直连 + 介质融合,量产 6–9µm
6–9µm

消除焊料、铜垫直接键合 + 无机介质界面融合:寄生电阻与电容显著下降,密度跃升至 ~10⁴/mm²。AMD 3D V-Cache(9µm)、台积电 SoIC(6µm HVM)、Intel Foveros Direct(9µm,Clearwater Forest 已量产)三线并进。

STAGE 2 · 面对面堆叠 F2F

信号路径最短化
→ 4.5/3µm

第一代 SoIC 仅支持 face-to-back;二代 SoIC 与 Foveros Direct 引入 face-to-face——两层 die 的有源面直接对接,TSV 需求减半。路线图:台积电 2029 → 4.5µm(A14-on-A14);Intel 二代 → 3µm

STAGE 3 · 亚微米与单片化

互连即布线
<1µm

大会披露的国产路线:混合键合 pitch <300nm、TSV CD <2µm 已在攻关线;当键合间距进入 BEOL 布线量级,「封装互连」与「片上互连」的边界消失——3D-SoC / 顺序式 3D(sequential 3D)成为终局形态。

DIE-TO-DIE INTERFACE间距 ~50µm · ~400 互连/mm²
图 2 量产混合键合间距路线图(µm,越小越密)Tom's Hardware / Intel Foundry / 大会披露
SoIC:9µm(2023)→6µm(2025 HVM)→4.5µm(2029E);Foveros Direct:9µm(2026 量产)→3µm(Gen2);国产攻关线:<0.3µm。虚线为路线图目标。注:JEDEC 放宽 HBM 堆高 → HBM4 沿用微凸点,存储 HB 推迟至 HBM4E/HBM5
2.3 技术栈 · 五个正在定型的构件

从 Die 到系统的完整工具箱

图 2b 3D IC 真实器件结构解剖(等轴测渲染 · 按 SoIC/HBM 公开剖面绘制)结构可交互视图
自顶向下:顶部 Die(逻辑/存储阵列+BEOL)→ 混合键合界面(Cu–Cu pad + SiCN 介质)→ 底部 Die/中介层(TSV Φ~5µm + 顶部 RDL)→ µBump/C4(~40µm)→ 封装基板(ABF build-up,金手指)→ PCB 载板。结构依据:TSMC SoIC 公开剖面(ECTC 2019/2023)、HBM 叠层结构(IEEE TED 2020)
构件
机制与 2026 前沿
关键参数 / 玩家
2.5D 中介层
硅/有机/RDL 中介层横向互连逻辑与 HBM;当前 AI 封装绝对主力(CoWoS / EMIB / I-Cube)
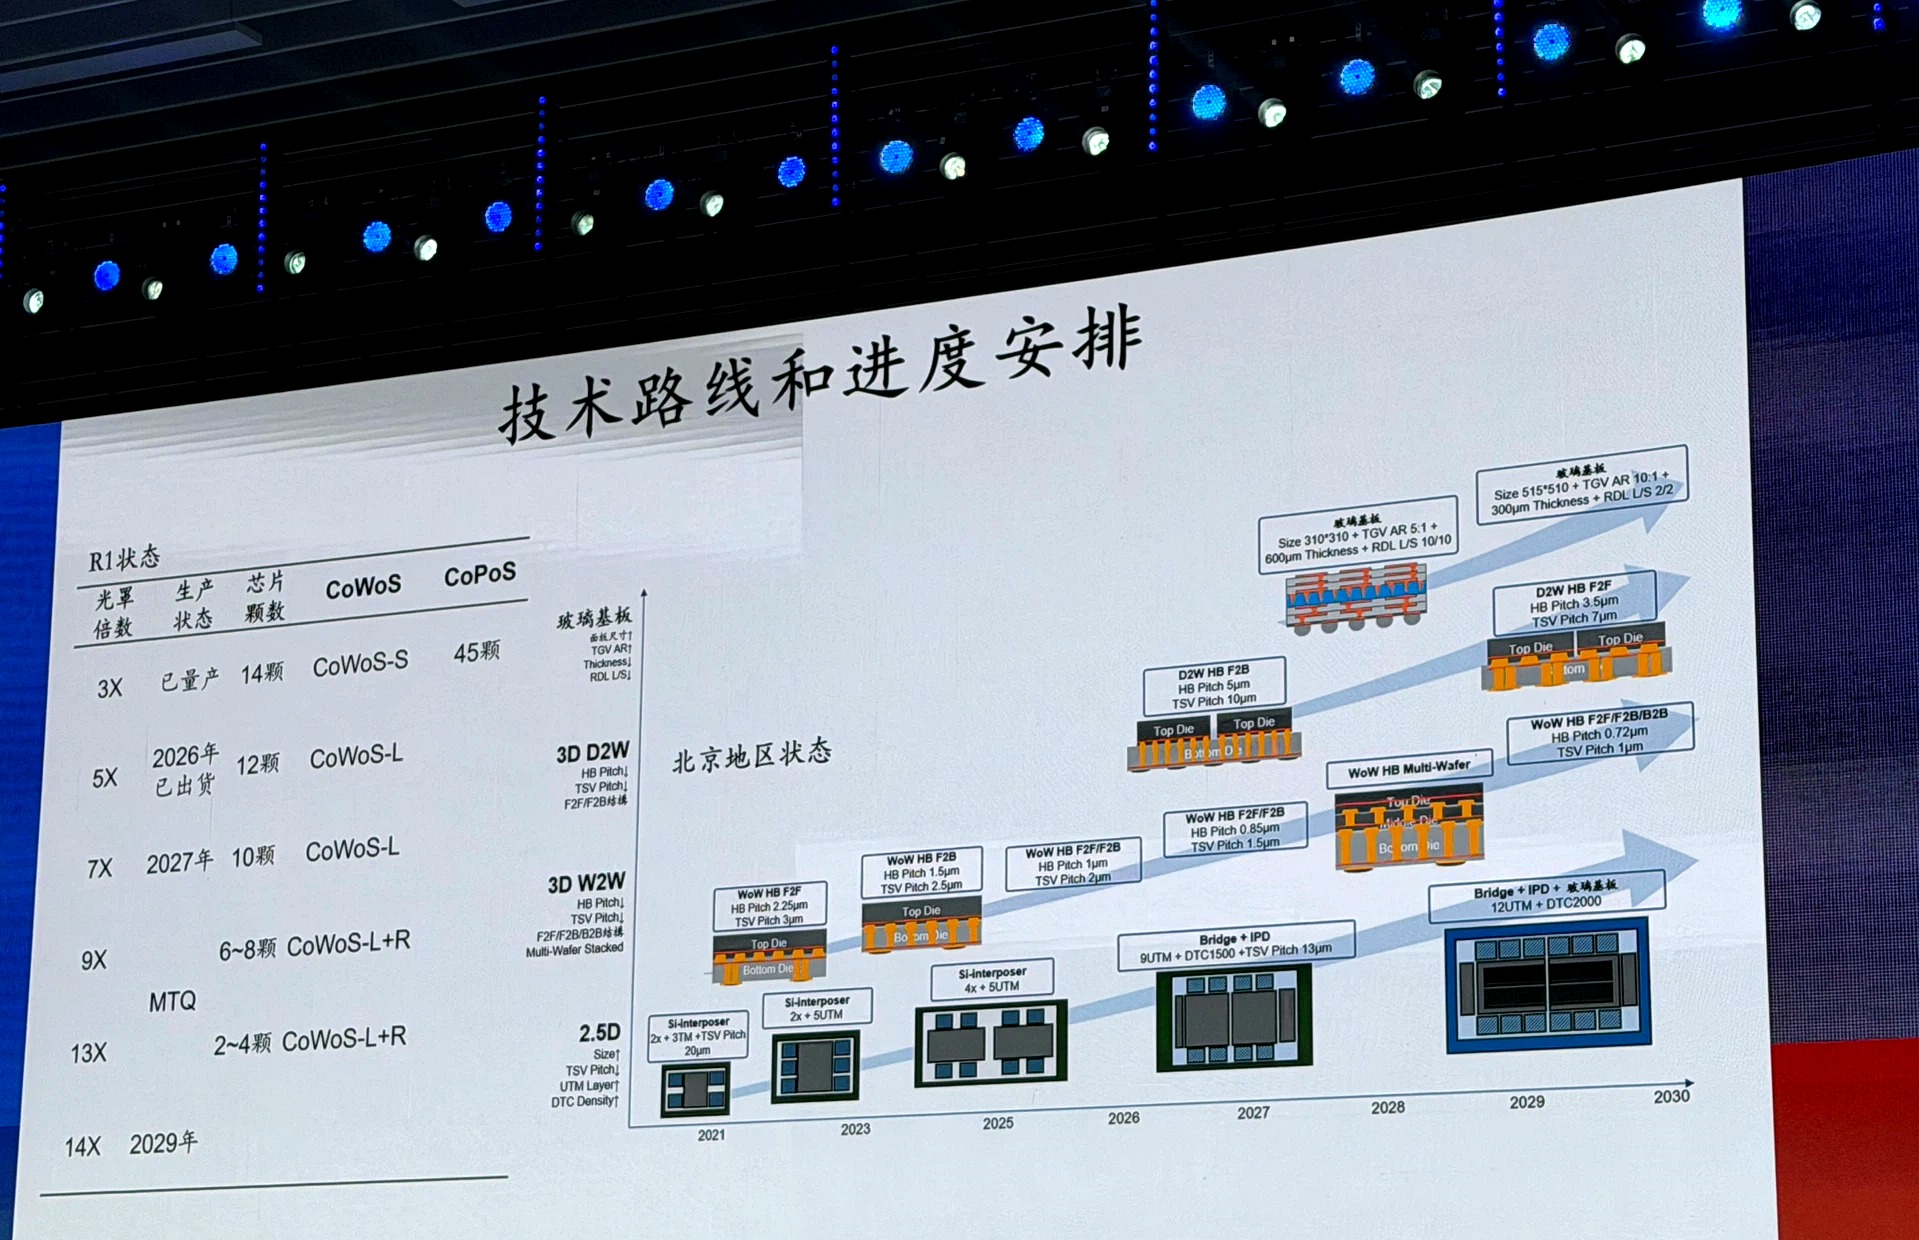
CoWoS 产能缺口约 23%(2025 需求 ~14.6 万片/月等效 12 吋);CoPoS 面板化 310×310mm 验证中,MP 预计 2028H2
3D 堆叠
(SoIC / Foveros Direct)
混合键合垂直堆叠逻辑/缓存;F2B → F2F;EMIB×Foveros = 3.5D 组合工艺
SoIC 6µm HVM→4.5µm(2029);FD 9µm→3µm;AMD 3D V-Cache 二代 9µm 面背堆叠 7nm SRAM,带宽 10×
Chiplet × UCIe
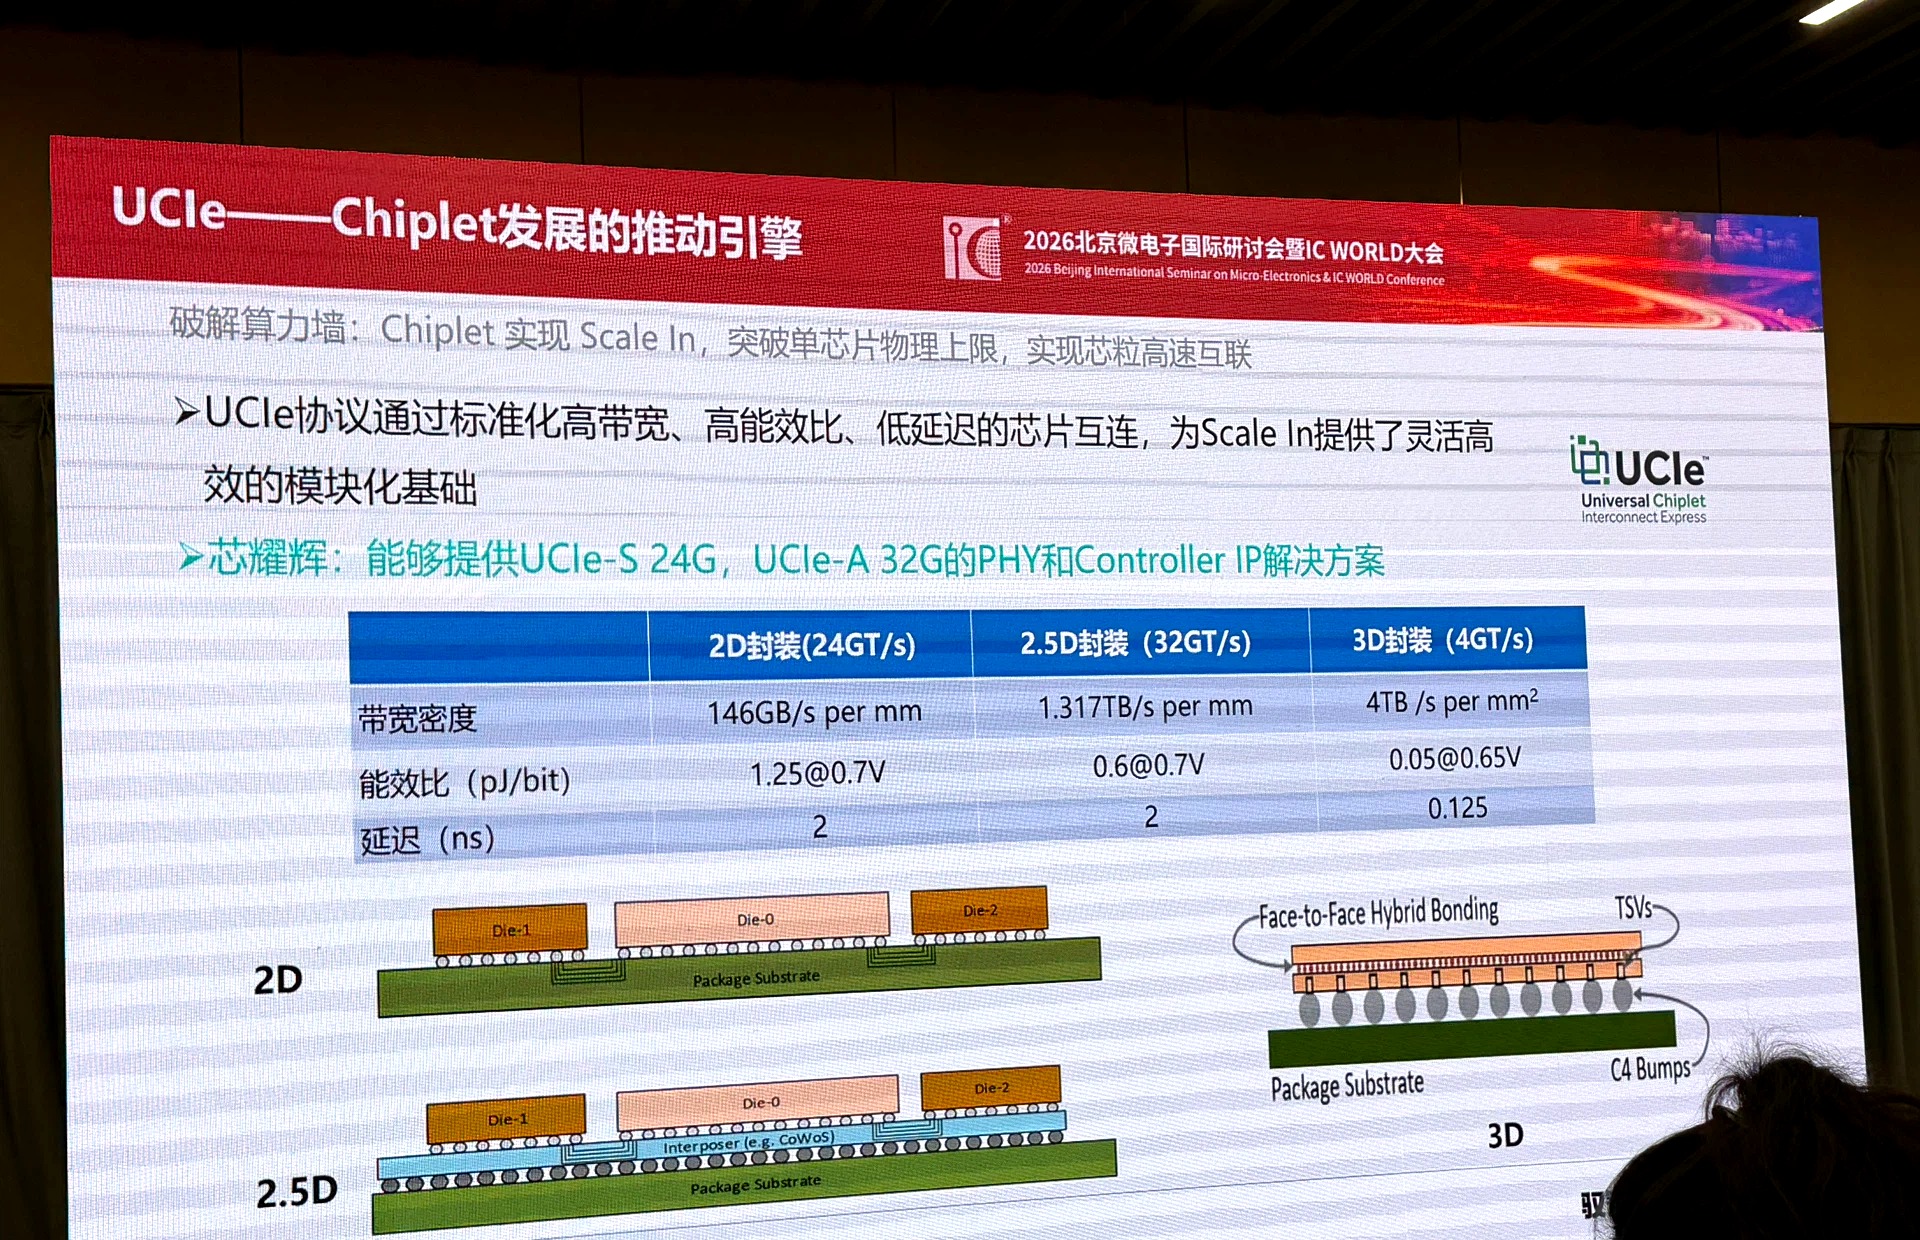
开放 die-to-die 标准,封装内芯粒互操作;3.0 版面向 3D 封装与 Hybrid Bonding 互连
UCIe 3.0(2025.8):48/64 GT/s(较 2.0 翻倍)、sideband 延伸至 100mm、MTP 早期固件下载、Fast Throttle、运行时重校准省电
存储墙:HBM4 / HBF
HBM4 位宽翻倍至 2048bit、Base Die 转逻辑代工;HBF 用 NAND 介质填补 HBM 与 SSD 之间空白,走 UCIe 接口
HBM4:2TB/s/栈、32Gb die、16Hi、64GB(三星已商用 11.7Gbps);HBF:8/16Hi、≤512GB、0.4–3.0TB/s、容量为 HBM 8–16×(OCP 首份规范 2026.8,Google/Tenstorrent 入盟)
玻璃基板 × TGV
有机基板在 80×80→140×140mm 演进中逼近翘曲极限;玻璃 CTE 可调、平整度高、适合超大封装与光互连
京东方 ¥9.93 亿板级中试线全自动通线(510×515mm、TGV 深径比 20:1、百万级孔零漏孔、20 层+增层);Intel×蓝思 TGV 合作;三星 GlaSSEM 延至 2028;Absolics 终验中
机制判断

HIR 2025 明确:封装已成为决定带宽、延迟、功耗、散热与可靠性的系统级技术——互连密度按 pitch² 增长、晶体管密度增速降至 ~5%/年,系统性能决定层已从 FEOL 移到封装。

2.4 市场 · 谁在为 3D 付费

先进封装超越传统封装,成为封装业主赛道

图 3 先进封装与细分市场(十亿美元)Yole / QYResearch / Sigmaintell视图细分增速视图 · 点击条形看详解
名词详解 · 调研注解
先进封装 $55B(2025)→$120B+(2031);Sigmaintell 口径 2026 $58.7B(+97%);Chiplet 多芯片异构 $15.8B(2025)→$43.9B(2032,CAGR14.8%);3D 堆叠+混合键合细分 CAGR 24.8% 为最快赛道。大会口径:3D 堆叠细分 2026 $90 亿 → 2027 $270 亿
光互连 CPO
$139B

CPO/NPO 市场 2025→2030;英伟达 Spectrum-X 硅光 CPO 交换机 2026.8 全面量产(200G/lane);高盛预测光模块 2026 $67.7B → 2028 $148.5B。

算力扩展三层
Scale in / up / out

Scale in:Chiplet×UCIe×2.5D/3D;Scale up:NVLink/UALink 1.0(2025.4,200G/lane,≤1024 加速器/域);Scale out:超节点水平扩展。互联优化把有效算力从 <30% 拉到 ~70%。

产能瓶颈
23%

2025 年 2.5D/3D 封装供需缺口;订单排期超一年。产能 CAGR 2025–27 达 77%——封装产能本身成为 AI 算力的约束条件。

2.5 中国路径 · 系统补偿单点

「成熟工艺 + 3D 堆叠 + Chiplet」= 等效先进制程的系统整包

先进制程受限下,用异构集成拼系统级等效性能已是国产算力主路径。大会警示:先进封装路线图话语权缺失是深层瓶颈——自主路线与标准制定权须同步建立。

案例 · 东方算芯
软件定义芯片破三墙

可重构单元 + 3D 堆叠(间距数十µm→几µm、带宽 +5–10×)+ 3.5D 封装;14nm+HB 散热优于 Micro Bump,二代走向存算一体。

案例 · 芯耀辉
接口 IP 全栈自研

SerDes / UCIe / DDR / HBM 四大接口域全覆盖;DDR 方案使推理服务器成本 -40~60%、能效 +2–3×。

案例 · 拓荆键科 × 北大
键合装备国产化

D2W 套刻精度 1618nm→283nm(-82%)+ RSS 统计预测模型;互连 pitch 1mm→40nm 的装备路线图支撑 3D-SIP→3D-IC 演进。

主线 B · AI × FULL CHAIN

AI 赋能全链条:
从「辅助工具」到「自主工程师」

大会七场论坛拼出一幅完整图景:AI 不再是 EDA 的一个功能点,而是沿「设计 → EDA → 制造 → 测试 → DTCO」五链同步重构方法学。判据很直白——AI 是否拥有决策权。2026 年的分水岭是:智能体(Agent)开始承接「长任务」。

3.1 设计 · 壁垒是方法学,不是模型

北大 4 人 3–4 个月完成应用芯片流片:效率跃迁已经发生

北大多智能体流片案例(3 个月交付 GDS)的判断:核心不是堆叠大模型,而是对设计流程做 AI 原生重构;壁垒在方法学积淀,而非单点工具。

层级
代表工作(可溯源)
实证效果
RL 布局布线
Google AlphaChip(Nature 2021 + 2024 Addendum):边图卷积 + 强化学习,开源 circuit_training
<6 小时生成优于/可比人类专家的 floorplan;已用于三代 TPU 及 Alphabet 内外多款芯片
自主设计空间探索
Synopsys DSO.ai(2020 首发,业界首个自主设计应用);Cadence Cerebrus
DSO.ai:三星 3nm +300MHz、功耗 -10%;Cerebrus 累计 1000+ 设计、PPA +7–12%、生产力 7–10×
LLM 多智能体 RTL
VerilogCoder(NVIDIA);MAGE 开源多智能体;ChatEDA/AutoMage(CUHK,RTL→GDSII 自主代理)
VerilogEval-Human v2:VerilogCoder 94.2%(+33.9pt vs SOTA)、MAGE 95.7%(超 Claude-3.5 达 23.3pt)
端侧与新品类
原力半导体:对话式交互 → 7×24 常驻智能体芯片;端侧 AI SoC 四平台(端边缘/云端/光互联/3D SoC)
新需求:长任务承载>峰值算力、低功耗长驻留;端侧 AI 市场 2029 达 ¥1.22 万亿(CAGR ~40%)
图 3b AI × EDA 实测收益对比log 轴 · 厂商披露值
西门子/概伦/华大九天数据源自大会实拍投屏(详见第六章实录),国际大厂为官方披露口径:加速/吞吐倍数
3.2 EDA · 自主等级阶梯

L1→L5:2026 年全行业进入「自主等级」叙事

图 4 EDA 自主等级阶梯与各阵营 2026 坐标大会 EDA 论坛 + Synopsys/Cadence 官方发布
L1 脚本 → L2 AI 辅助 → L3 单任务端到端 → L4 多智能体编排 → L5 全自主。Synopsys AgentEngineer 于 Converge 2026 演示业界首个 L4 编排式多智能体设计验证工作流;Cadence ChipStack AI Super Agent 于 Computex 2026 宣布 L5。商业模式同步迁移:卖工具 → 卖「设计成果」
Cadence · L5
40×

ChipStack AI Super Agent + NVIDIA OpenShell:RTL 验证周期 5 周 → <1 天,每位工程师可调度数百个动态仿真(Computex 2026)。

Synopsys · L4/自治工作流
50×

全自动设计验证 agent:time-to-validated-RTL 提速 50×、覆盖率 +20%;自动 debug 闭环周期 -25~40%(DAC 2026,AMD/Microsoft 协作)。

创业生态
制造 EDA 全链国产替代

芯盟科技四大模块(计算光刻/良率控制/工艺仿真/DTFC)全部实现国产替代,规划半导体大模型智能中台;华大九天转向「生态链智能体底座」;Agent 公司已部署 80 家领先半导体企业。

大会现场 · 八厂商实效(实拍图 39)
从单点案例到行业常态

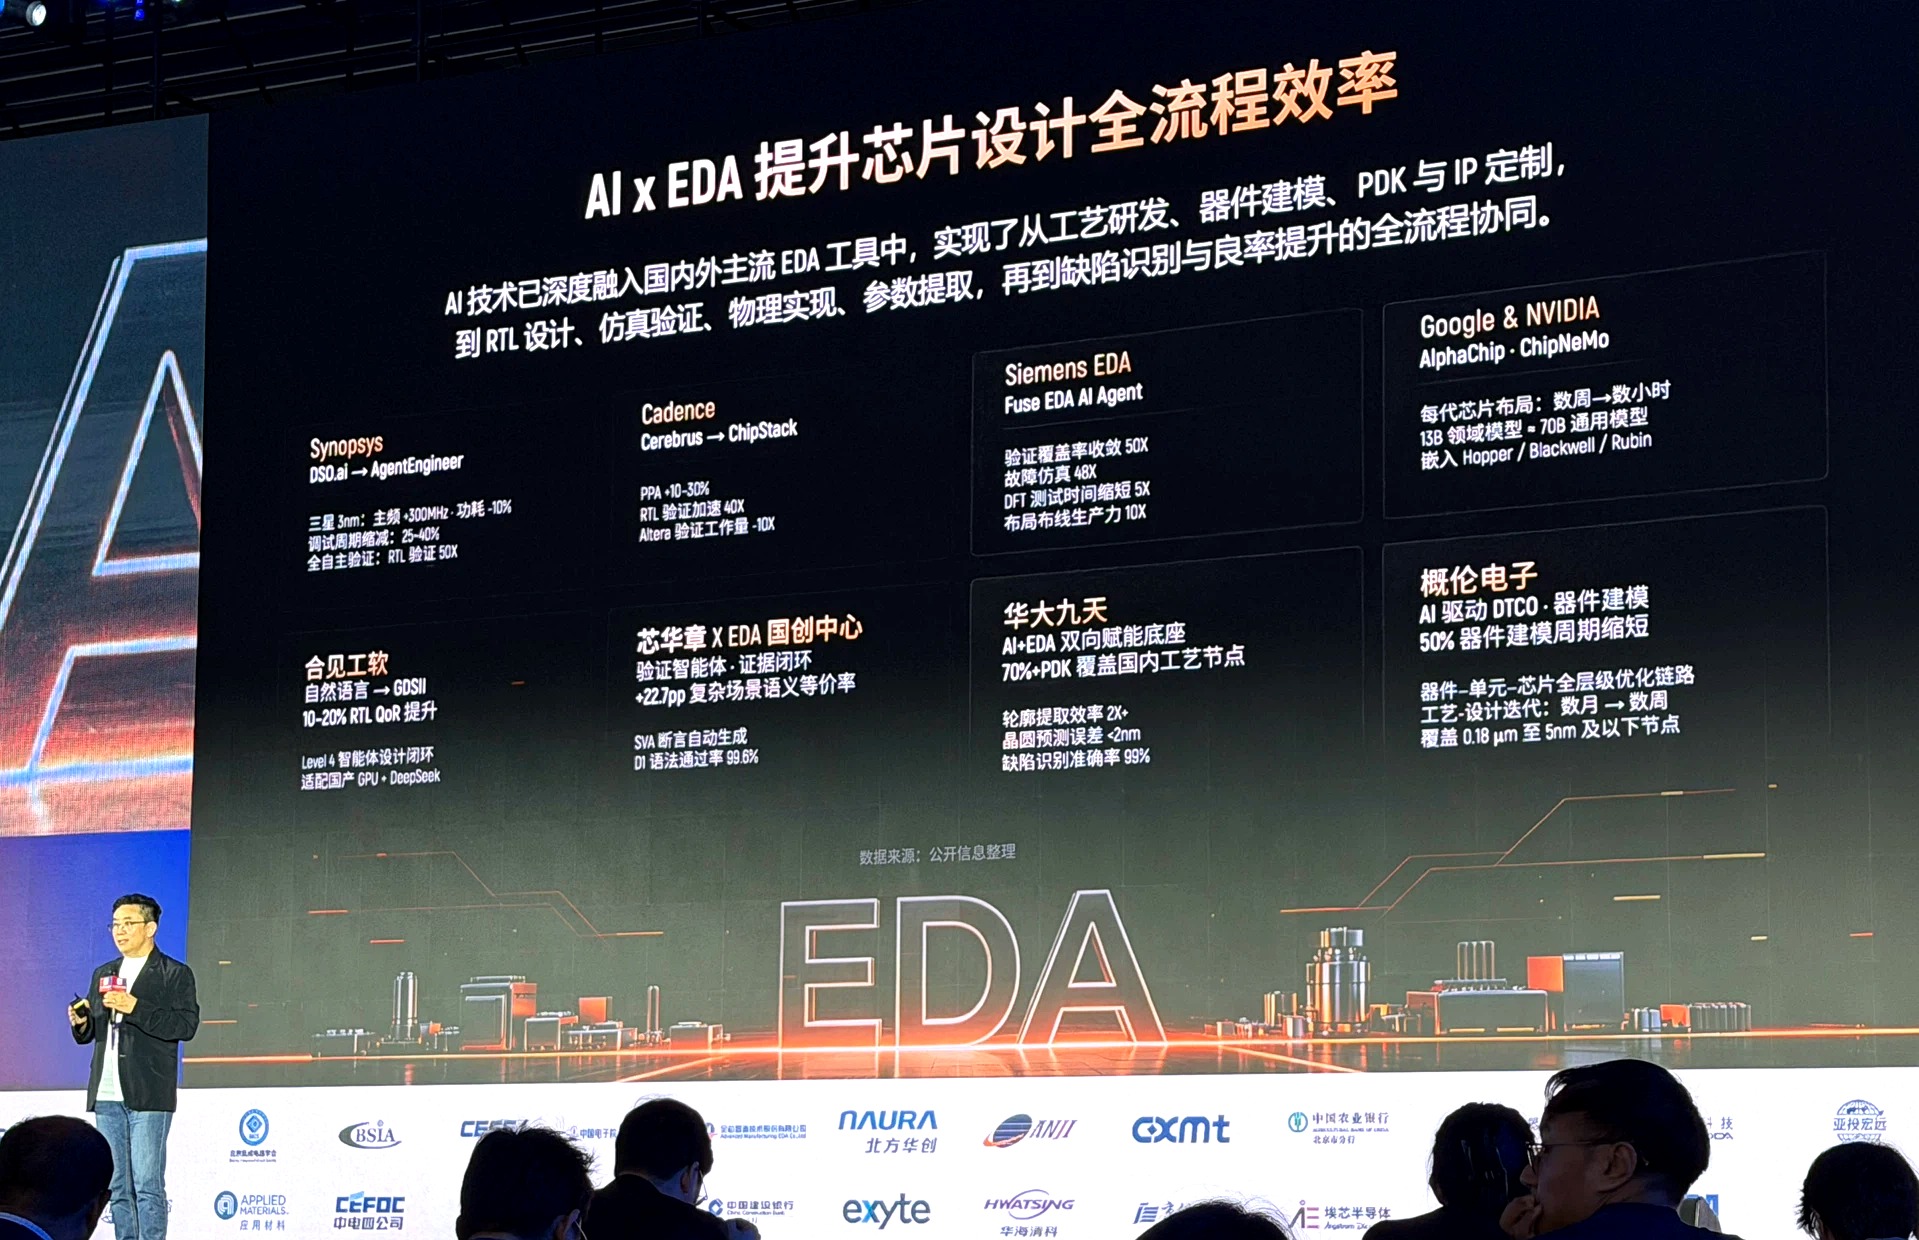
西门子 Fuse Agent:覆盖率收敛 50×、故障仿真 48×、DFT -5×;AlphaChip·ChipNeMo:布局数周→数小时、13B 领域模型≈70B 通用;国产侧——概伦 DTCO 器件建模 -50% 周期、华大九天 70%+ PDK 覆盖/<2nm 误差、芯华章证据闭环 +27.7pp、合见 NL→GDSII +10–20% QoR。

人机分工终局

工程师从「操作者」变为「问题定义者」:执行性劳动让渡给 7×24 智能体——方法学沉淀在 Flow 与数据里,不沉淀在人时里

3.3 制造 · AI FAB 已过「AlexNet 时刻」

五环节闭环:感知 → 预测 → 诊断 → 决策 → 执行

国际大厂已在排产/工艺控制/良率/量测给 AI 实际决策权:效率 +~10%、单节点工艺优化 +50%+。台积电把 NVIDIA CUDA-X/Metropolis 引入晶圆厂本体,全栈加速。

STEP 1
连接感知
高质量标准化数据采集——AI 决策的根基
STEP 2
预测
设备/工艺趋势预判(北方华创故障预测 95%)
STEP 3
诊断
根因定位(远程运维诊断率 80%)
STEP 4
决策
方案生成——AI 需有实际决策权而非建议权
STEP 5
执行 · 迭代
闭环进化,AI 渗透工厂各层级形成全局优化
主体
场景
成效(可溯源)
NVIDIA cuLitho × 台积电 × Synopsys
计算光刻
40–60× 加速:350 台 H100 系统替代 40,000 台 CPU 系统;生成式 AI 再 +2×;全芯片曲线 ILT 从理论走向量产(GTC 2024 投产)
北方华创
装备智能化
故障预测准确率 95%、远程运维诊断率 80%;AI 研究院研发人员约 6000 人;前道开发近 3 年「零失败」
芯盟科技
制造 EDA
AI 辅助 OPC 模型标定、ILT 提速约 100×;物理模型混合框架仿真,拟合精度纳米级以下
科阳科技
光刻产能
深度强化学习优化产能分配:头部 12 吋厂机台负载差别率 -47.67%
中科飞测
量测检测
AI 驱动 4D 智能感知架构,「感知-决策-执行」闭环赋能量测检测
最大瓶颈:数据孤岛

客户出于安全顾虑不愿共享数据,单客户 1000+ 条不足以驱动模型进化。破局:联邦学习、隐私计算、产业数据共同体——本质难题是数据治理,不是算法。

3.4 测试与 DTCO · 从「执行问题」到「认知问题」
测试范式之变
覆盖驱动 → 智能驱动

2.5D/3D 使芯片成为多物理场耦合系统,故障升级为跨芯粒动态隐性问题。先进体系 = 设计期嵌 DFT/传感器 + AI 因果分析/自适应测试 + 全生命周期闭环。

DTCO + AI
后摩尔时代的差异化杠杆

3nm 后缩微贡献降至 50%,另一半靠 DTCO 跨层协同。实证:7nm 版图数月→1 天、特征化吞吐数倍——DTCO×AI 是受限环境的关键杠杆。

链条收束

五链 AI 化的共同结构:高质量数据 → 代理模型 → 决策权下放 → 闭环迭代。它与第二章的物理主线在「器件可靠性」处相交——这正是第四章。

交汇点 · AI × RELIABILITY

AI × 器件可靠性:
两条主线交汇处的方法学蓝海

第二章(3D 集成)制造了前所未有的可靠性复杂度,第三章(AI)恰好提供跟上复杂度的工具。大会三个信号——失效模式、测试范式、需求侧同时迁移——与 2024–2026 年文献爆发互相印证。本章按「机理谱系 → 测试方法 → 仿真与寿命预测 → 相关性分析 → 启发」展开。

4.1 机理谱系 · 失效正在「升维」

从单器件静态失效到跨芯粒级联失效

JEDEC JEP122H 按位置分 FEOL / BEOL / 封装界面三层机理。2.5D/3D 让三层在同一封装内耦合(翘曲、热应力、CTE 失配、键合界面空洞)——单器件模型框架已不够用

图 5 3D 集成器件的失效机理地图按层切换层级
左:3D 堆叠剖面(Top die / HB 界面 / 中介层 / 基板);右:各层主导机理与加速应力。3D 场景下热-力-电三场耦合,失效可跨芯粒级联传播。机理与模型族:JEDEC JEP122H(Ea/加速因子);大会测试/封装论坛
机理
物理模型族(JEP122)
加速应力 / 关键参数
3D 时代的增量难点
HCI 热载流子
Lucky electron / 能量驱动模型,t ∝ (1/Isub)^m·exp(Ea/kT)
Vds、Isub、温度(低温更劣)、占空比
与 BTI 耦合难分;DVFS 下应力路径非平稳
BTI(N/P)
R-D 反应-扩散 / 捕获-释放双态模型,幂律 tⁿ(n≈0.16–0.25)
Vg、温度、占空比、恢复效应
长驻留低功耗场景恢复占比改变;与 HCI 耦合(PINN-LSTM 已联合建模)
TDDB 介质击穿
E 模型 / 1/E 模型 / 幂律 V 模型;EPG(电场路径生成)物理模型
Vg/Eox、温度、面积/Weibull β
混合键合界面介质与低 k 叠加新击穿路径;FEM 求解慢 → PINN 100× 替代
EM 电迁移 / SM
Black 方程 MTTF=A·j⁻ⁿ·exp(Ea/kT);Blech 短长效应;Korhonen 应力演化
电流密度 j、温度梯度、线长/几何、约束层
μbump→HB 后电流密度再上台阶;背面供电引入新热-应力失配(2029-30 电流 ~4200A 量级)
封装界面失效
Coffin-Manson / Paris 疲劳裂纹;界面断裂力学
ΔT、CTE 失配、键合强度、空洞率
HB 界面 Cu-Cu 强度/空洞演化、玻璃基板 TGV 长期可靠性——全新失效模式,模型尚未定型
4.2 测试方法 · 一条清晰的左移路线

从「加速寿命试验」到「全生命周期在线监测」

阶段 1 · 资格认证
JESD47 应力驱动鉴定
HTOL/TC/HAST 等加速应力 + 固定样本量;「过/不过」判定
阶段 2 · 知识驱动
JESD94 / 任务剖面
按应用工况分解加速因子,JEP122+SFR 折算现场寿命(TI:10 年@105°C → 降温延寿)
阶段 3 · 设计内建
测试左移 + 在片传感
设计期嵌 DFT/在片老化传感器(RO/泄漏监测,ITC/MWSCAS 2025 已落地);千万级测试记录成新常态
阶段 4 · 智能闭环
在线监测 × RUL
传感器遥测 → AI 剩余寿命预测 → 动态调频调压延寿 → 全生命周期数字孪生——「覆盖驱动」变「智能驱动」
图 6b 「智能驱动」测试的认知闭环大会 3D IC 测试专题
传感器遥测 → 多模态融合 → 因果根因 → 自适应决策 → DVFS/测试执行,回流遥测——测试从一次性判定变为持续认知循环对应阶段 4 · 智能闭环
范式判断(大会原话)

2.5D/3D 使测试从「执行问题」变为「认知问题」:需要理解故障根因(因果推理)、动态决策(实时策略)、系统推理(跨层级因果链)。全球尚无成熟方案——这是研究蓝海,也是工程蓝海

4.3 仿真与寿命预测 · AI 代理模型正在接管计算瓶颈

物理保真 × 10³–10⁶× 加速:从 TCAD 到毫秒级退化预测

旧链路「加速实验→TCAD→寿命外推」在迭代设计里算不动;新链路「混合数据→代理模型→紧凑老化→SPICE→任务剖面 RUL」。以下为 2024–2026 文献实证(全部可溯源):

图 6 已发表 AI 可靠性代理模型的加速比与误差(log 轴)文献实测值
横轴为相对物理仿真的加速比(对数)。圆点为文献报告值,误差标注见表。数据源:文献 [R1]–[R8](文末参考文献)
工作
对象 / 方法
关键结果
对我们的含义
Physics-Aware RelGAT
arXiv 2605.31092
NBTI 老化评估;器件网格→属性图 GAT,45 维物理编码(界面陷阱+电热应力)
独立测试集均误差 1.27%;较 TCAD 加速约 17,000×;双端归一化+对数损失处理跨量级电流
网格即输入→跨器件几何可迁移;DTCO 迭代里可承受
Mesh-native PI-GAT
arXiv 2609.02988
FinFET 漂移-扩散全解;四面体网格图网络 + 有限体积电流连续残差
逐网格点预测电势与准费米能级;少鳍训练→多鳍泛化,尺寸可迁移
「物理残差入损失」替代纯数据拟合——样本效率与可信度兼得
PINN-LSTM 联合失效
Microrel 2025
NBTI/HCD 耦合 ΔVth;R-D+能量驱动修正嵌入 2-D {VG,VD} 平面
ΔVth 平均相对误差 11.92%;RO 频率退化误差 8.6%;可外推至 LNA 噪声/S 参数
耦合机理必须联合建模——分离模型在叠加区系统性失真
APPD-Net
IEEE TED 2026
NBTI 老化预测;幂律结构嵌入 + 多任务 + 自注意力
20% 训练数据即优于 ANN/CNN/Transformer;自动解耦物理参数 A、n,面向 SPICE 紧凑老化模型
「模型结构=物理形式」是小样本可靠性的正解
PINN × EPG-TDDB
ASP-DAC 2024
Cu 互连 TDDB;PINN 解离子扩散 PDE + 硬约束优化
较 FEM 加速约 100×,MSE <0.1%
物理 PDE 残差天然兼容 PINN;适合作为签名模型
PINO Fe-VNAND
arXiv 2603.06881
铁电 VNAND 保持特性;物理信息神经算子
较 TCAD 加速 >10,000×;直接产出紧凑模型参数与 LUT,支撑可靠性 SPICE 仿真
代理模型的正确交付物是「紧凑模型/LUT」,不是散点预测
PEM 寿命代理
Microrel 2026
功率模块 RUL;自回归损伤预测 + 物理增强 ML
代理模型较数值仿真快 10⁶×;主动学习选点;残差反查仿真网格缺陷
任务剖面级 RUL 只有在 10⁶× 加速后才算得起
EMaper
DATE 2026
EM 感知布局布线;物理紧凑模型 + 热仿真前置进 P&R
消除 92.1–100% EM 违规,线长/过孔代价仅 4.5–16.3%;热友好工况零代价
可靠性左移的落地形态:把失效模型变成设计约束
在片老化传感器
ITC / MWSCAS 2025
HCI / BTI 在线监测电路(紧凑片上 sensor)
模拟 IC 内嵌老化遥测,支撑运行时 RUL 与自适应补偿
「设计期埋点」是数字孪生的数据入口
方法学要点(北大 PINN 四步法,大会深读)

① 控制方程残差化(NBTI/TDDB/EM/界面蠕变 → 损失函数核心项);② 网络小型化(4–6 层 MLP、32–64 神经元 + 工艺节点 Embedding + Softplus 物理归一化,S-PINN 自适应损失平衡);③ 数据分层配比(物理仿真 20–30% / 实测 10–20% / 元数据 50–70%,主动学习选点、不确定性加权);④ 工程化部署(复合损失 + L-BFGS → ONNX → EDA/AI-FAB 微服务)。NBTI 案例:训练 <2h(TCAD 等效 1000+h)、单次预测 0.8ms(TCAD 2.3h,~10⁷×)、300 仿真+50 实测 R²>0.92;论文在审 Nature Communications / Science Bulletin。

现场深读 ① · IEDF 刻蚀 PINN(实拍架构还原)
物理描述符是比原始配方更好的输入

流水线六步:工艺配方(压强/源功率/SF₆/C₄F₈/时序)→ COMSOL 等离子体仿真 → Sentaurus 鞘层动力学 → 表面形貌演化(727 组)→ 提取 7 维 IEDF 物理描述符(刻蚀步 4 个:总离子通量/氟离子分数/归一化能量展宽/偏斜指标;沉积步 3 个)→ 与归一化工艺参数融合 → Transformer 编码器捕捉多周期时序 → 38 组 SEM 实测迁移微调 → 输出形貌参数并做工艺筛选(扇贝宽度 <10nm)。要点:把「配方→形貌」的端到端学习,改成「配方→IEDF 物理量→形貌」的两段式,物理可解释性与小样本迁移同时成立。

现场深读 ② · nTSV-PINN(实拍损失函数还原)
正逆两用:仿真器即设计器

前向编码 (GS, L, 缝隙长, log₁₀f + 4 个傅里叶频带 = 12 维) → SiLU MLP 12→192→192→128 → 三个头:复数 S 概率头(8 均值+8 logσ)、RLGC 头(Softplus 保非负)、V/I 场网络。复合损失 Ldata=NLL+0.25·MSE+0.03·S11_dB;Lphysics=λ(t)(0.05·ODE+0.10·BC)+0.01·(无源+互易)+0.005·几何约束;5 折分组集成。反向设计:冻结前向集成 → 多起点几何优化 + 周期重构 → ∇gLinv 迭代出合格几何。要点:微分约束(ODE/BC/无源性/互易性)与几何先验分项加权入损失,使小网络具备跨频段、跨几何泛化。

4.4 相关性分析 · 大会信号 ↔ 文献证据

四条独立证据链收敛到同一个判断

图 7 大会观察与公开文献/标准的互证关系连线 = 佐证
左列:大会信号;右列:独立证据。线宽 ∝ 关联强度(本报告归纳)。用途:区分「会场观点」与「可溯源事实」
相关链 ① · 因果递进
键合间距 ↓ ⇒ 界面失效权重 ↑ ⇒ AI 需求 ↑

微凸点→HB 让互连密度按 pitch² 上升的同时,界面介质、Cu-Cu 键合强度、空洞演化成为新失效主体(大会封装论坛)⇒ 失效物理进入「多物理场耦合」区间(大会测试论坛)⇒ 单机理解析模型失效 ⇒ 代理模型刚需(文献 [R1][R5][R6] 同步出现)。链条每一环都有独立数据源佐证

相关链 ② · 时间共振
「蓝海」不是修辞:文献密度同步爆发

大会判断「AI×可靠性全球尚无成熟方案」;同期文献侧:2024 EPG-TDDB PINN → 2025 PINN-LSTM/传感器 → 2026 APPD-Net/RelGAT/PINO/EMaper/PEM 密集出现——论文从单点方法走向「测试-仿真-设计」全链,窗口期与产业验证链(第五章 76/85/60)重合。

相关链 ③ · 数据闭环
验证平台 = 可靠性模型的天然数据入口

大规模产业验证(设备 76%/材料 85%/零部件 60%)沉淀的失效与寿命数据,正是分层数据配比中最稀缺的「实测 10–20%」;中关村新策仿真测试平台(全国最大硬件仿真集群之一)提供仿真侧 20–30%。验证链即数据链

相关链 ④ · 需求对价
付费意愿标定研究优先级

卫星、车规客户对「快速可靠性检查」有明确付费意愿(大会圆桌);对应文献落点:任务剖面 RUL([R7])、车规快速认证、在片传感器([R9])——先卖工具,再卖模型,最后卖范式

4.5 对我们工作的启发 · 八条可执行判断
启发 1
把加速因子变成「可重算变量」

JEP122 固定 Ea/AF 是静态近似;代理模型让 AF 在任意任务剖面下毫秒级重算——从「一次外推寿命」转向「工况即寿命」,适配 DVFS 与 7×24 智能体芯片的非平稳应力。

启发 2
数据配比 > 模型规模

北大四步法与 APPD-Net 共同证明:物理仿真 20–30% + 实测 10–20% + 元数据 50–70% + 主动学习选点,比堆网络容量有效;模型结构嵌入物理形式(幂律/R-D)是小样本场景的正解。

启发 3
耦合失效必须联合建模

NBTI×HCD 联合模型证明分离建模在电压平面叠加区系统性失真;nLDMOS 类高压器件的 HCI+BTI 叠加区同理——建联合 ΔVth 面而非两条曲线

启发 4
从均值寿命到分布寿命

加速比 10³–10⁶× 后,蒙特卡洛/Weibull 群体级 RUL 第一次算得起:输出「失效分布随工况的演化」,而非单一 MTTF——这正是卫星/车规愿意付费的形态。

启发 5
可靠性左移 = 进设计约束

EMaper 模式:把 EM/老化紧凑模型前置进 P&R 与 DTCO(DTCO+R),失效模型从签核报告变为版图生成器的约束项;我们的 PINN 产物应以「可调用的约束函数」为交付形态。

启发 6
传感器是数字孪生的入口

在片 HCI/BTI 传感器已发至 ITC/MWSCAS:测试芯片埋点 → 量产遥测 → 在线 RUL。没有数据回流的数字孪生只是仿真器——先设计埋点,再谈孪生。

启发 7
交付物 = 紧凑模型 + 工具链,不是散点

PINO 的范式:代理模型 → LUT/紧凑老化模型 → SPICE/EDA 可调用;Reliability Agent 形态:读 GDS/SPICE → PINN 退化预测 → JEDEC 判定 → 不达标自动调 EDA API 改版图 → 输出含物理依据的报告。

启发 8
窗口期在本土验证链

设备 76%/材料 85%/零部件 60% 的国产验证 + AI4Chip 政策 + 中关村仿真平台 = 实测数据与验证场景在本土化链条上;对接验证平台做标杆案例(6–12 月),是建立话语权最短路径。

战略收束(大会观点 × 本报告判断)

短期 6–12 月快 100× 的可演示标杆 → 中期 1–2 年切入产业验证链 → 长期 3–5 年器件→封装→系统数字孪生。终点形态是 Reliability Agent:自主定义问题、调用工具、生成含物理依据的报告。

验证 · 差距 · 投资

产业验证与投资:
从「可用」到「好用」,从单点到系统

国产替代进入体系化验证阶段;中美差距在单点、机会在系统;投资逻辑沿「AI 算力需求 → 互联与存储升级 → 先进封装材料设备 → 端侧生态」全链条传导。

5.1 验证成果 · 三个百分比
图 8 产业验证完成度(2023–2026)大会产业验证论坛
设备:国产化工艺占比 76%(覆盖四大主流工艺线);材料:五大关键材料验证 85%(2023–2026 完成 185 项);零部件:功能验证完成率 60%(6 类以上 100% 国产替代)。意义:大规模验证 → 信任 → 规模化采购闭环;验证数据反哺 AI 可靠性模型
企业
替代突破(从「替代进口」到「指标反超」)
武汉金数字
OCD 设备先进制程交付验收,获超大额重复订单
上海新阳
多晶硅研磨液完全替代进口标杆产品,关键指标优于进口
有研益金
电镀设备全套验证并产业化
金宏气体
多种电子气体完成验证,持续稳定供应
北方华创
超一万篇专利,2026 中国专利金奖,牵头制定国内首个半导体装备产业标准
中关村新策仿真测试平台揭牌 · 全国最大硬件仿真集群之一RDI 聚力联盟 × 北京集成电路学会 · 标准与生态共建新创智 × 康普软件 · AI EDA 高速通信 IP 联合开发
5.2 中美差距 · 破局在系统
图 9 中美 AI 芯片单点差距(中国 / 美国)大会投资论坛
单芯片算力 1/15、内存带宽 1/18、AI 芯片上市公司市值 1/23。破局路径:8192 条互联总量反超 · 极致模型架构优化(差距逐月缩小)· 开源生态(20 倍市值空间)
核心判断

差距在单点,机会在系统——以集群化、系统级优化对冲单芯片劣势,是中国 AI 芯片产业的现实最优解;它与第二章的异构集成路径互为表里:系统级补偿,物理上靠互连,经济上靠生态。

5.3 投资与商业模式
热点 ①②
光模块 · 算力互联

800G/1.6T 需求确定、硅光/CPO 路线收敛(800G+ 市场 2025 $11.8B → 2028 $129.6B,CAGR 69%);网络互联、存储芯片、超节点配套。

热点 ③④
先进封装材料设备 · 技术分叉替代

基板材料变革、散热材料(铜-金刚石)、混合键合设备;技术路线分叉打开国产替代窗口。

热点 ⑤
端侧 AI 定制设计

2029 市场 ¥1.22 万亿(CAGR ~40%);AI PC 2026 出货 1.43 亿台、渗透率 55% 首超传统 PC。

模式 1
专用化 FAB
投入仅传统 FAB 1/10,FAB 与设计公司深度绑定
模式 2
EDA 卖成果
从「卖工具」到卖「设计成果」,价值锚点迁移
模式 3
算力成本竞争
成熟工艺 + 系统级优化 → 性价比数量级优势,取代单芯片性能成为竞争核心
未来十年

三大前沿探索(深度智能/认知智能/光电融合)· 全链条系统协同 · 从 follow 到 define:自主技术路线图与标准体系——竞争的本质是定义权竞争。

现场实录 · ON-SITE EVIDENCE

大会现场实录:
39 幅实拍 + 7 幅报告框架图,按主题归位

全部照片为 IC World 2026 现场投屏实拍(一手素材),按六个主题重组;每张附内容与数据解读。点击可放大查看。

6.1 算力与端侧
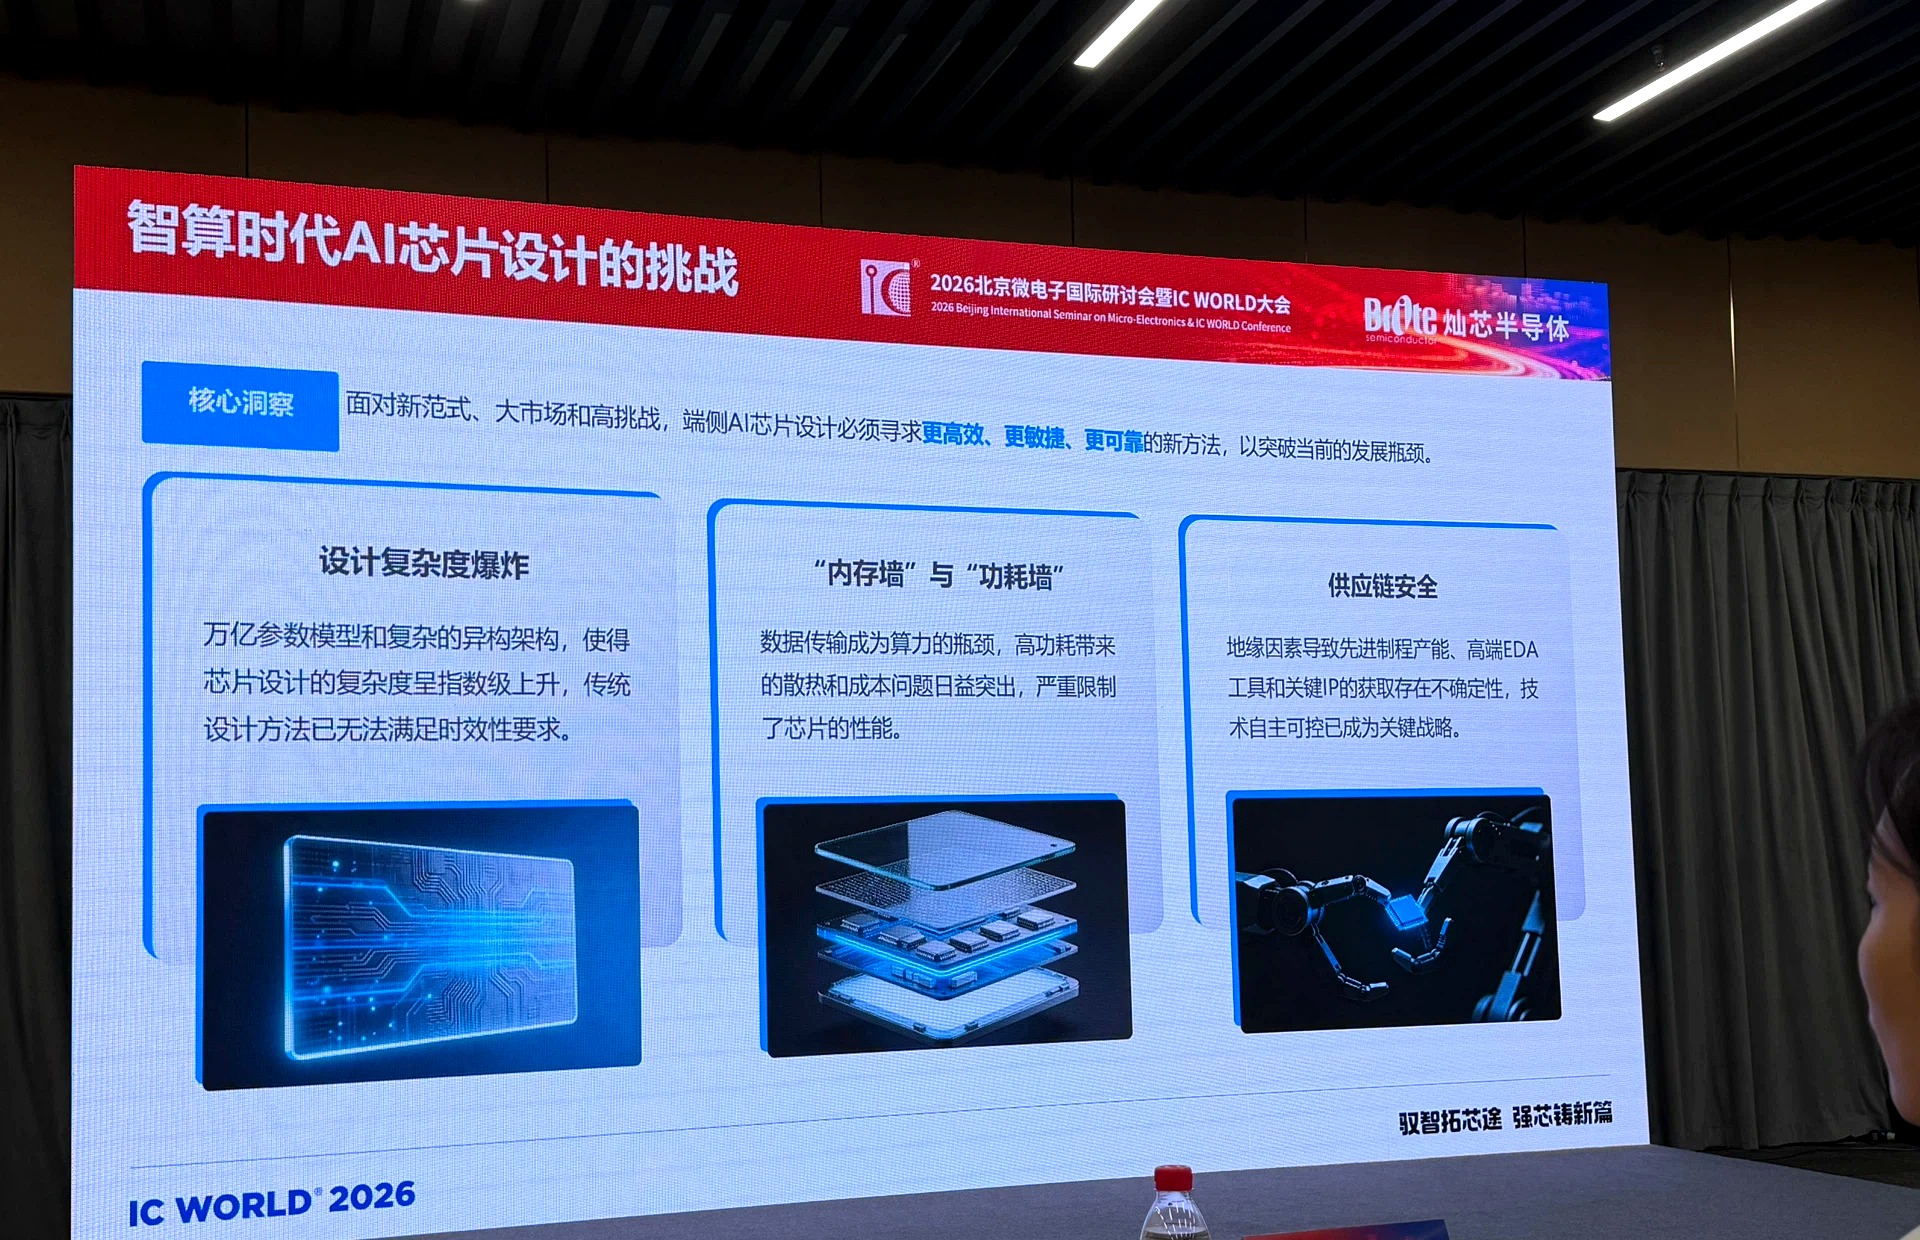
灿芯半导体演讲:AI芯片设计三大挑战放大
灿芯半导体
AI 芯片设计三大挑战:复杂度爆炸 · 内存墙/功耗墙 · 供应链安全
2026 端侧 AI 规模化落地,端侧 SoC 成战略制高点;算法/硬件/应用/商业四条件就绪,进入大规模应用元年。
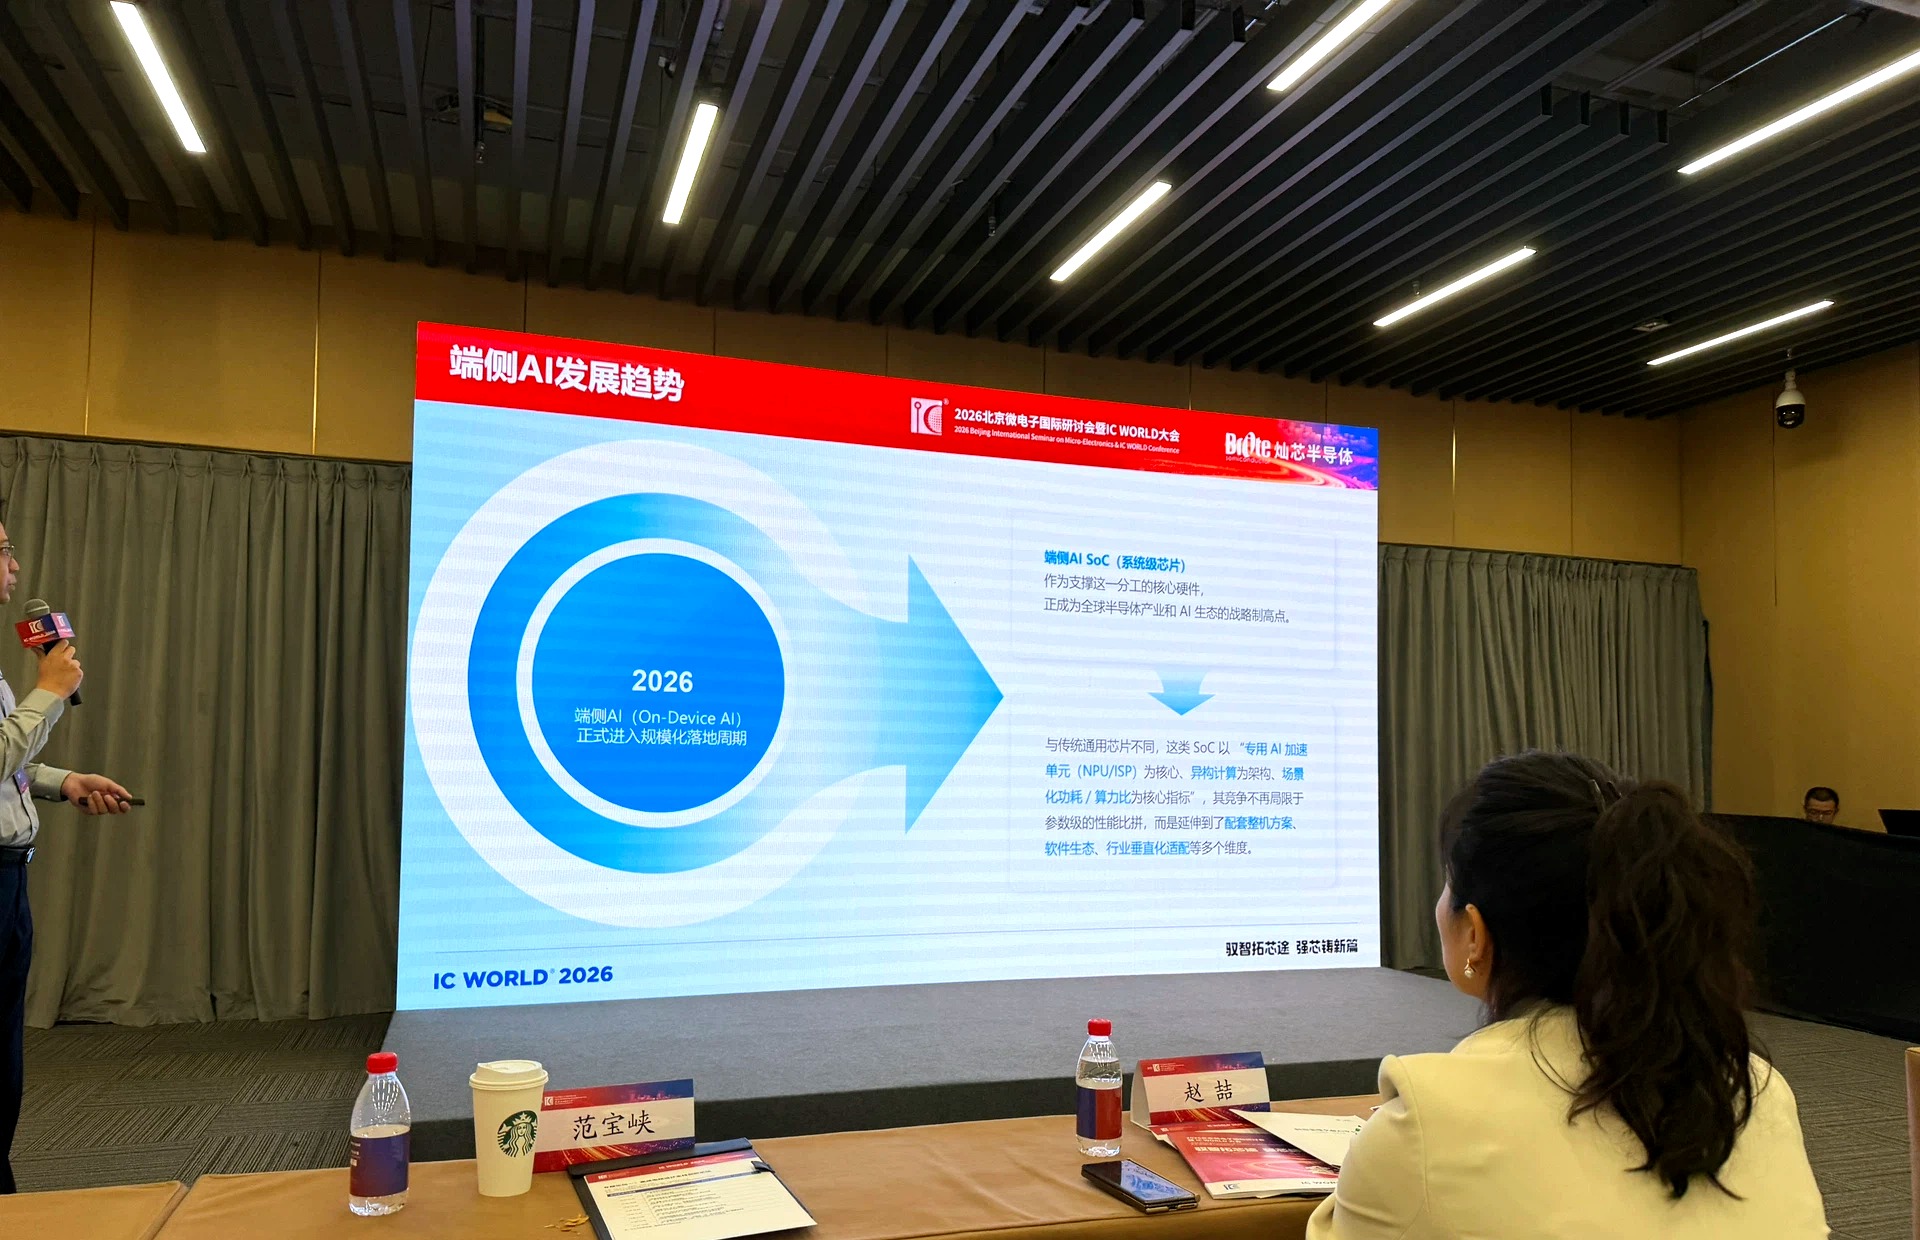
端侧AI趋势放大
灿芯半导体
2026 端侧 AI 进入规模化落地周期
端侧 SoC = 战略制高点;竞争维度向整机/生态/垂直适配延伸。
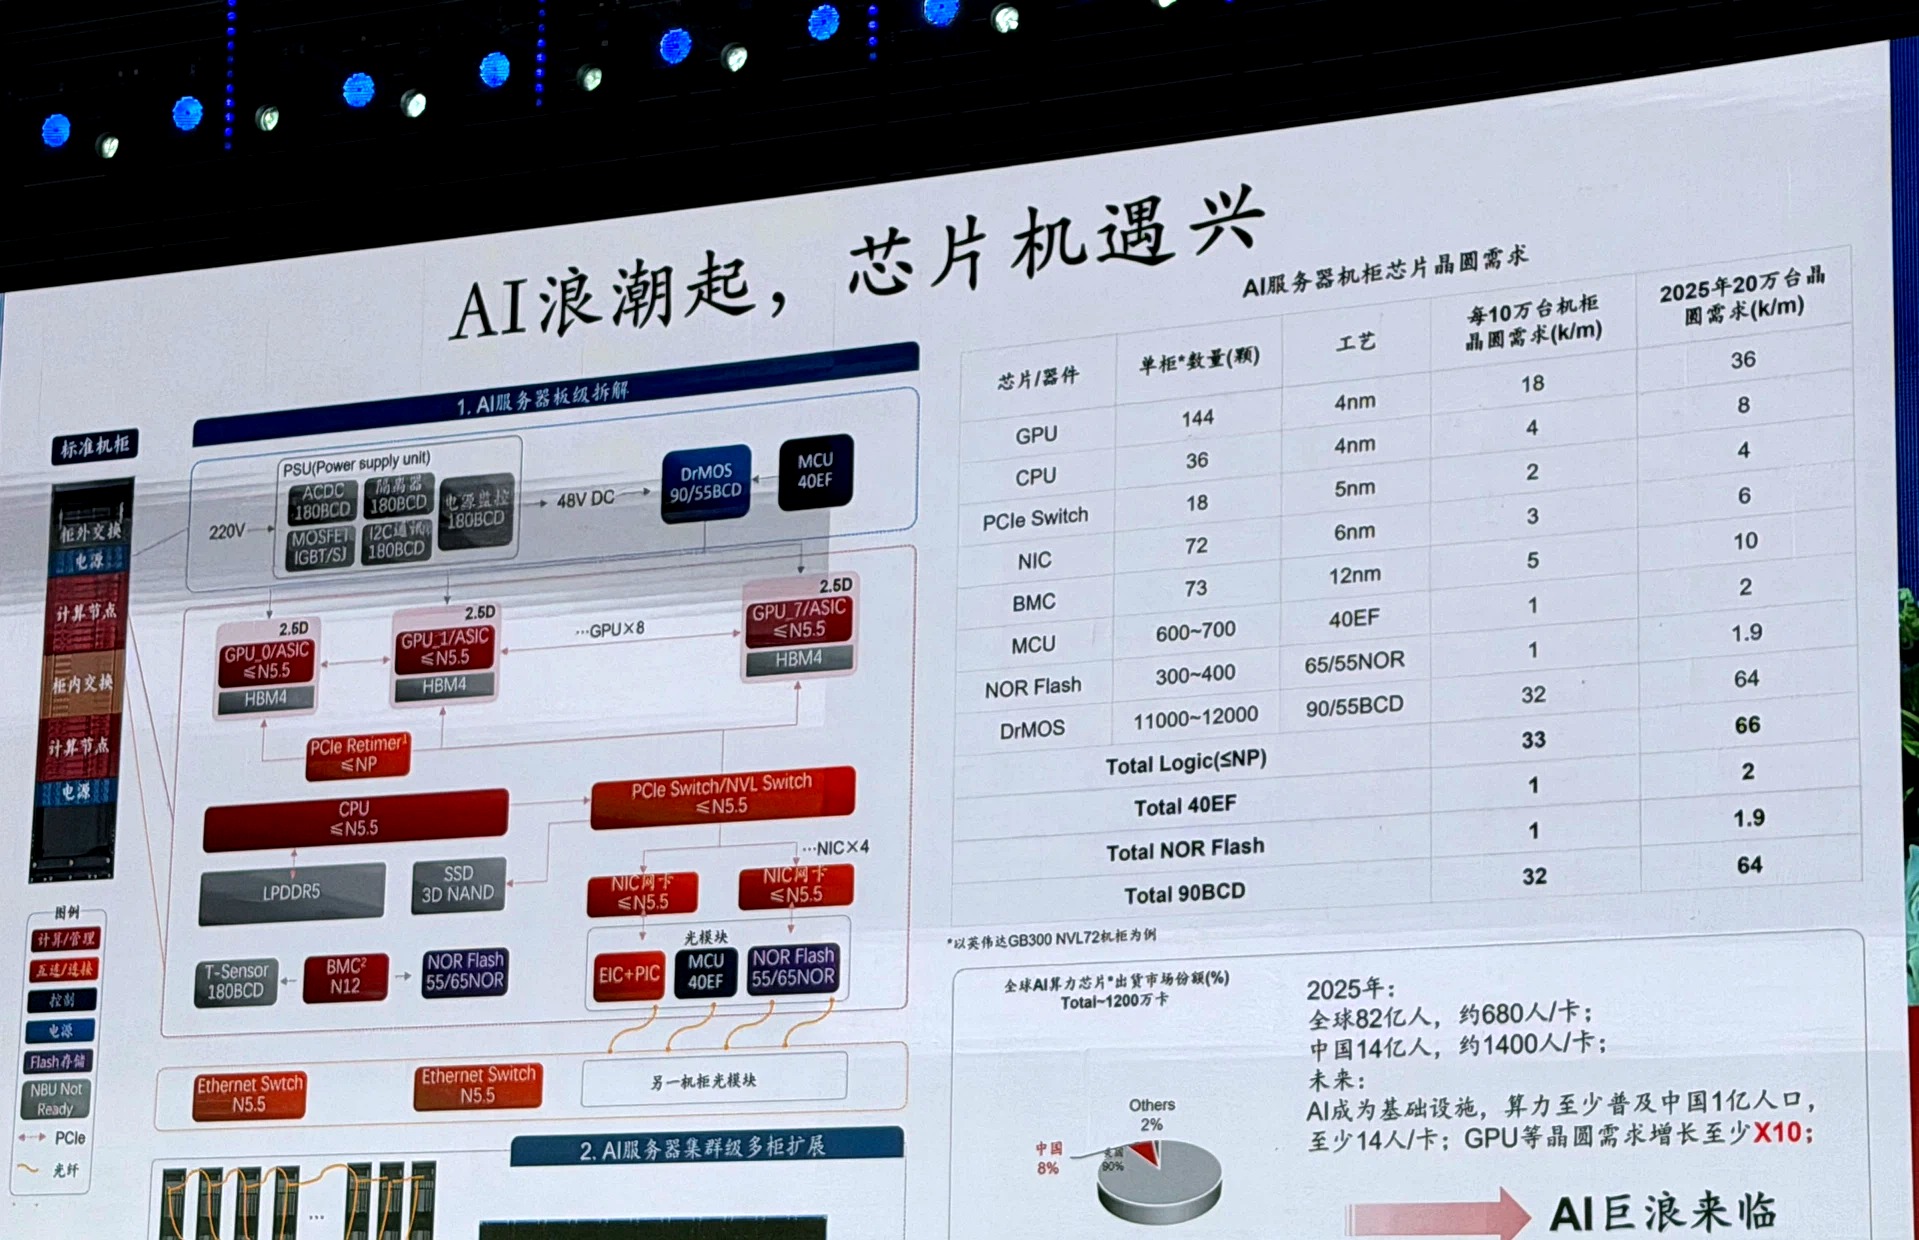
机柜晶圆需求测算放大
STIC
AI 服务器机柜的晶圆需求测算
板级拆解量化「算力普及 → 晶圆需求 10×」的传导链。
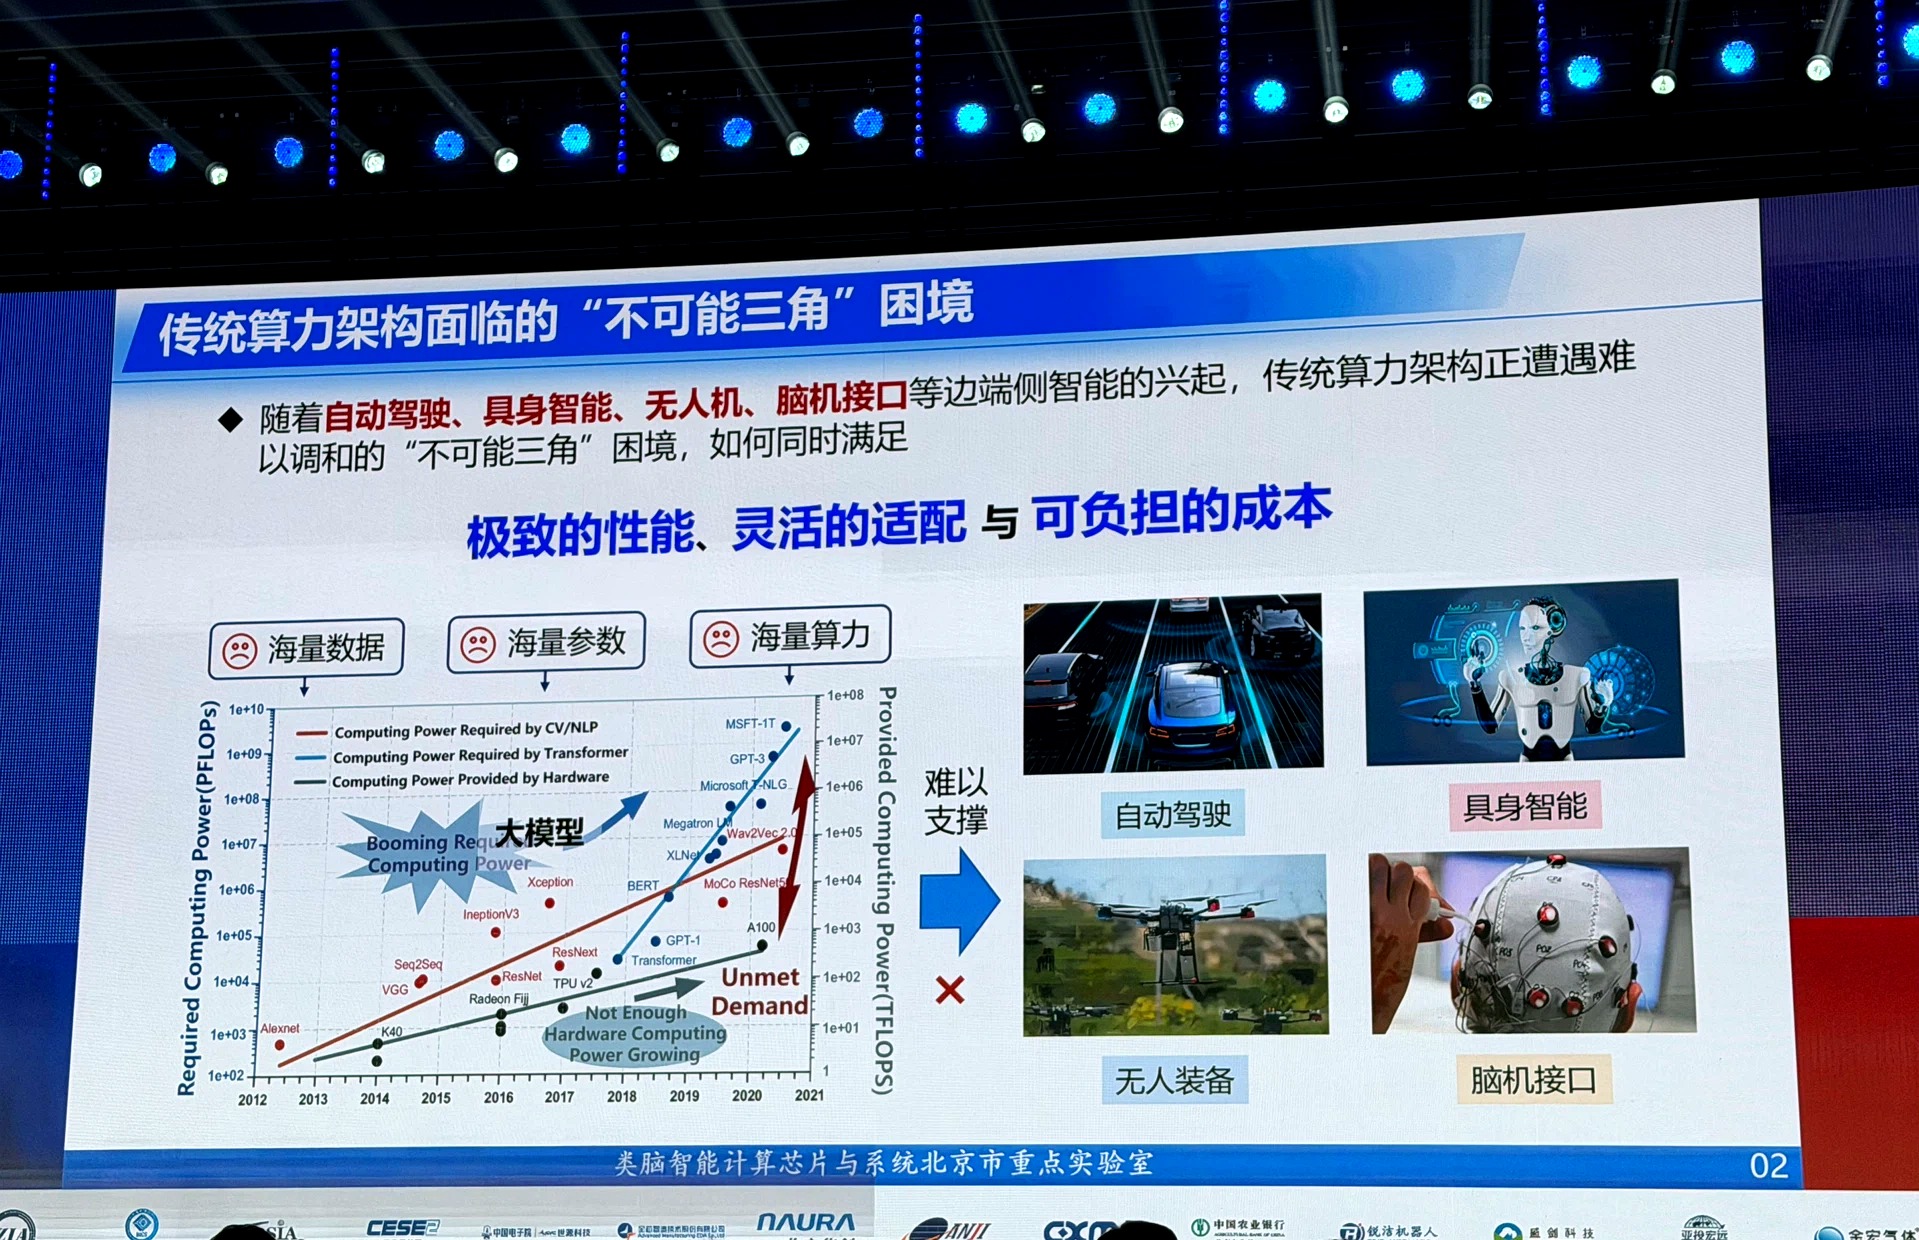
类脑不可能三角放大
北大类脑实验室
传统算力架构的「不可能三角」
海量数据×海量参数×海量算力 → 供需剪刀差,类脑计算的立论起点。
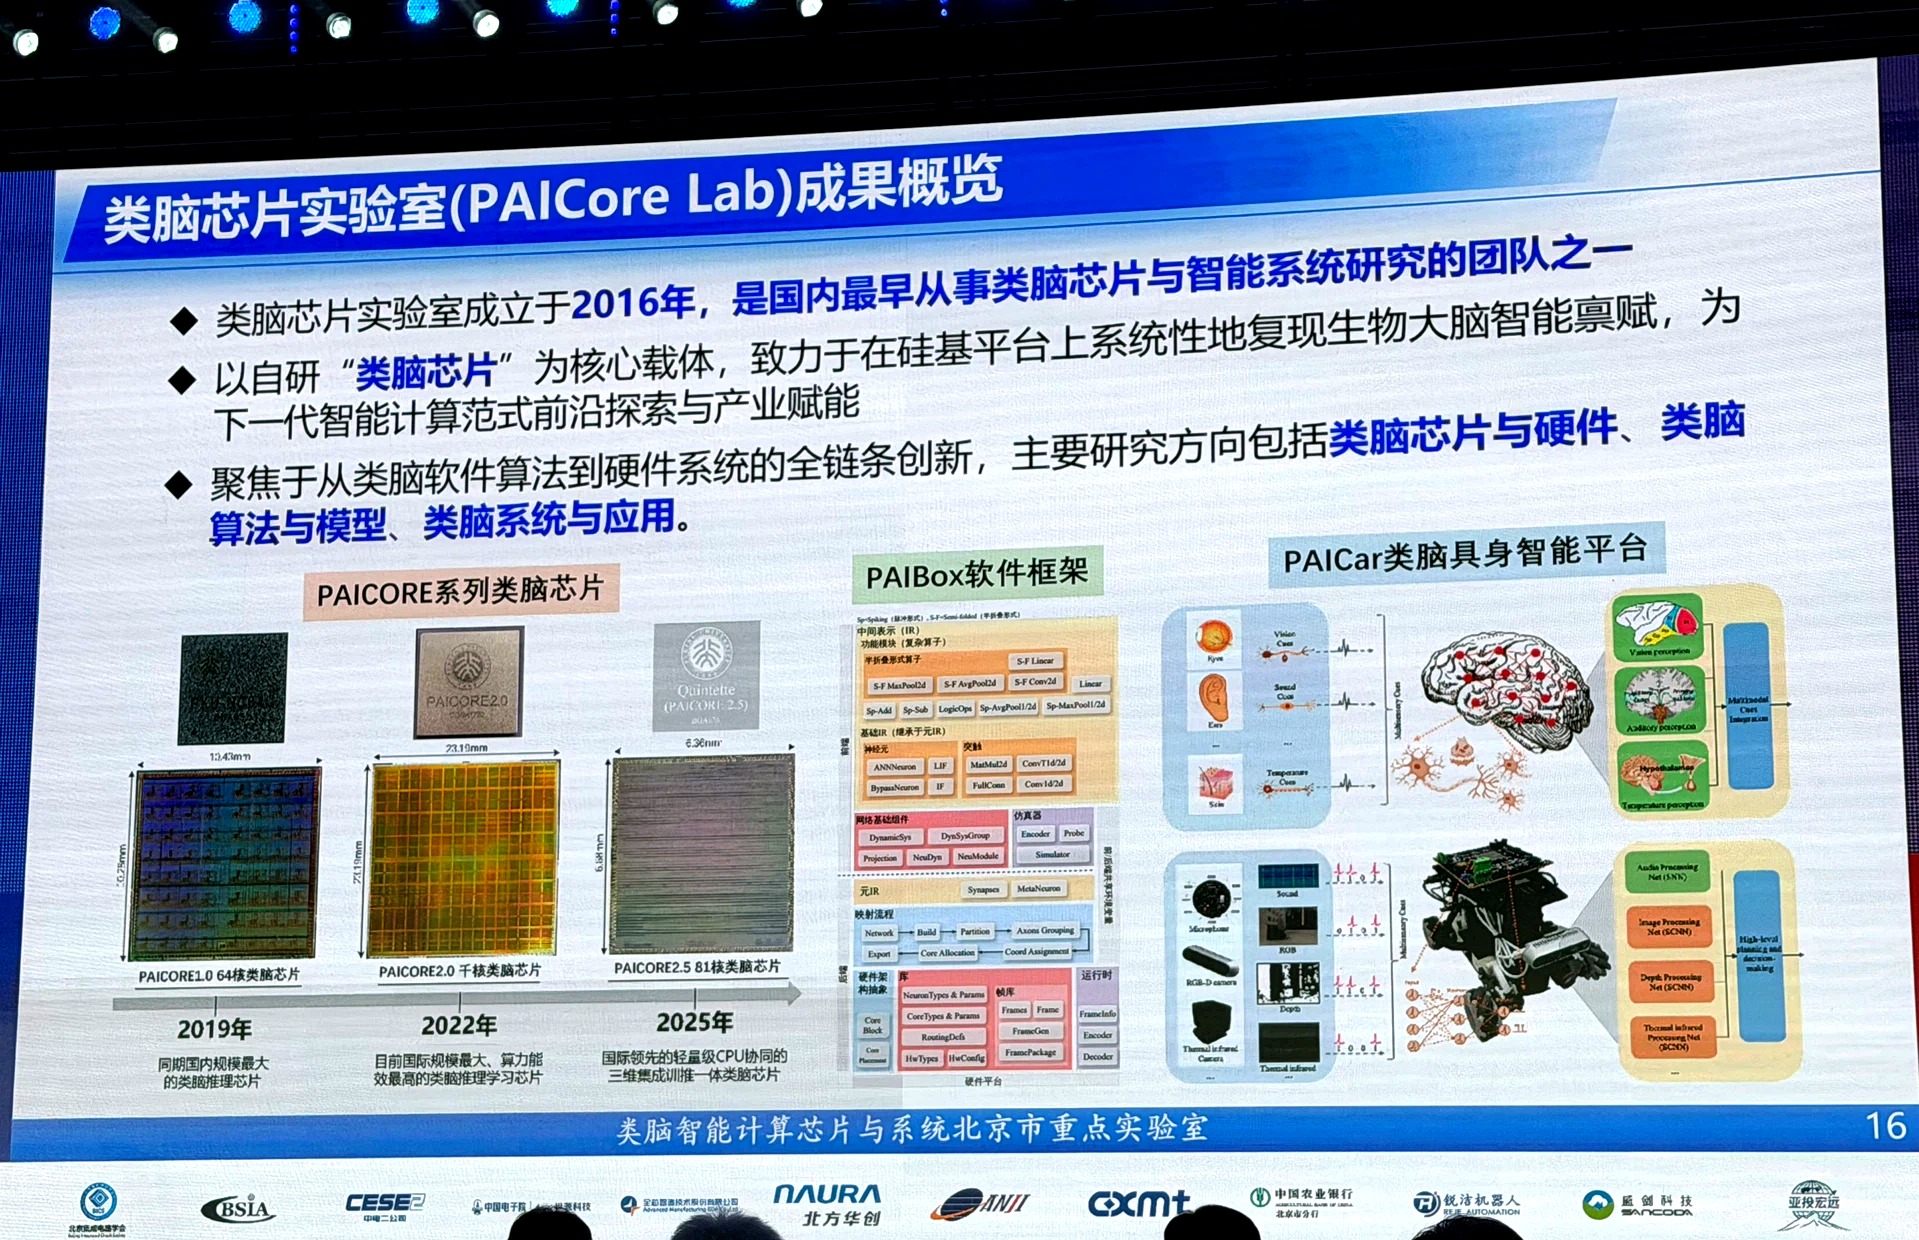
PAICORE芯片放大
北大 PAICORE
类脑芯片破不可能三角:5.181 TSOPS/W 全球最高能效
正式发表于 IEEE JSSC 60(2):651-671, 2025(DOI 可溯)。
6.2 互联与超节点(芯耀辉演讲实拍)
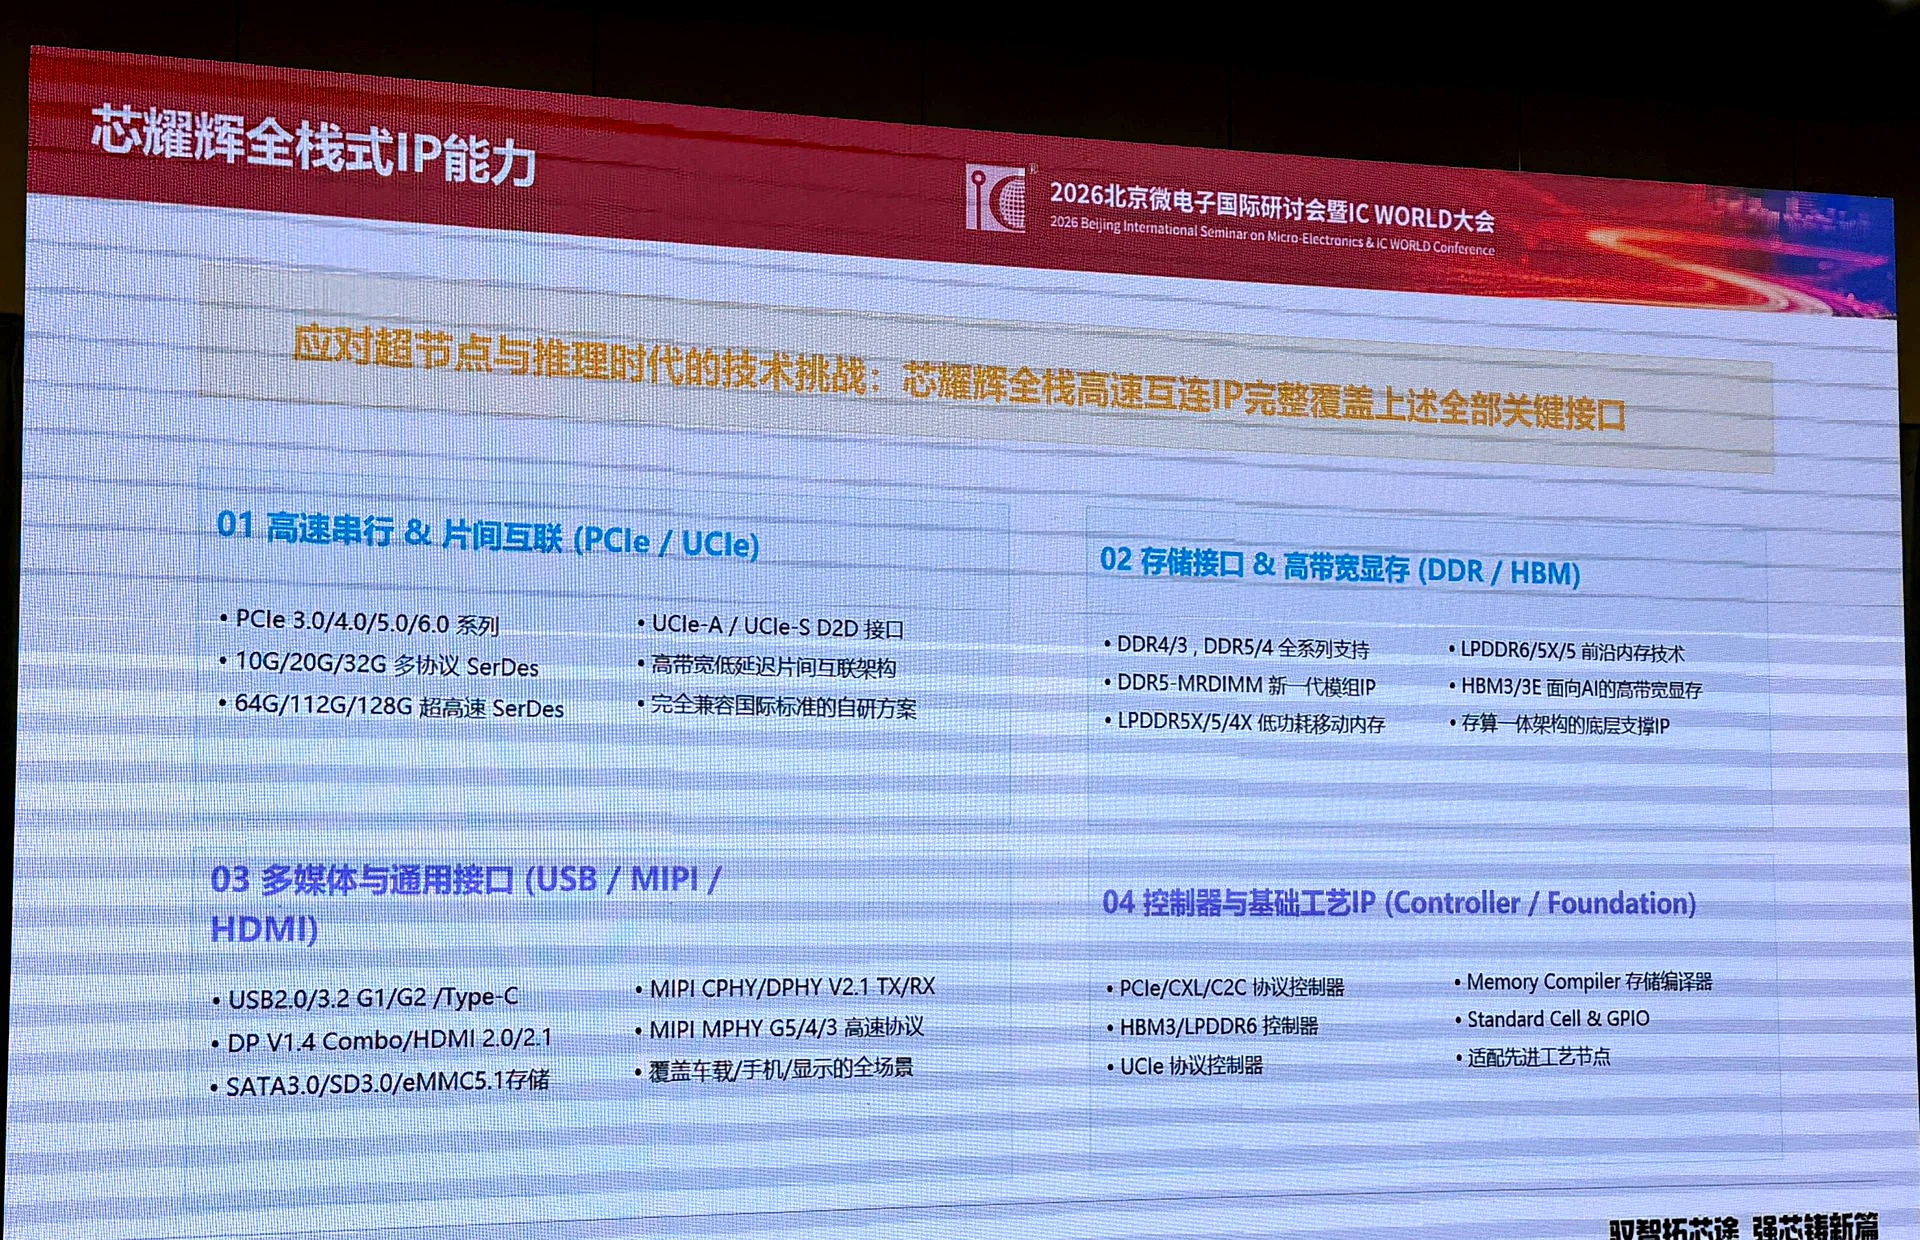
接口IP全栈放大
芯耀辉
接口 IP 从单点替代走向全栈覆盖
直接支撑超节点与推理时代的系统级创新。
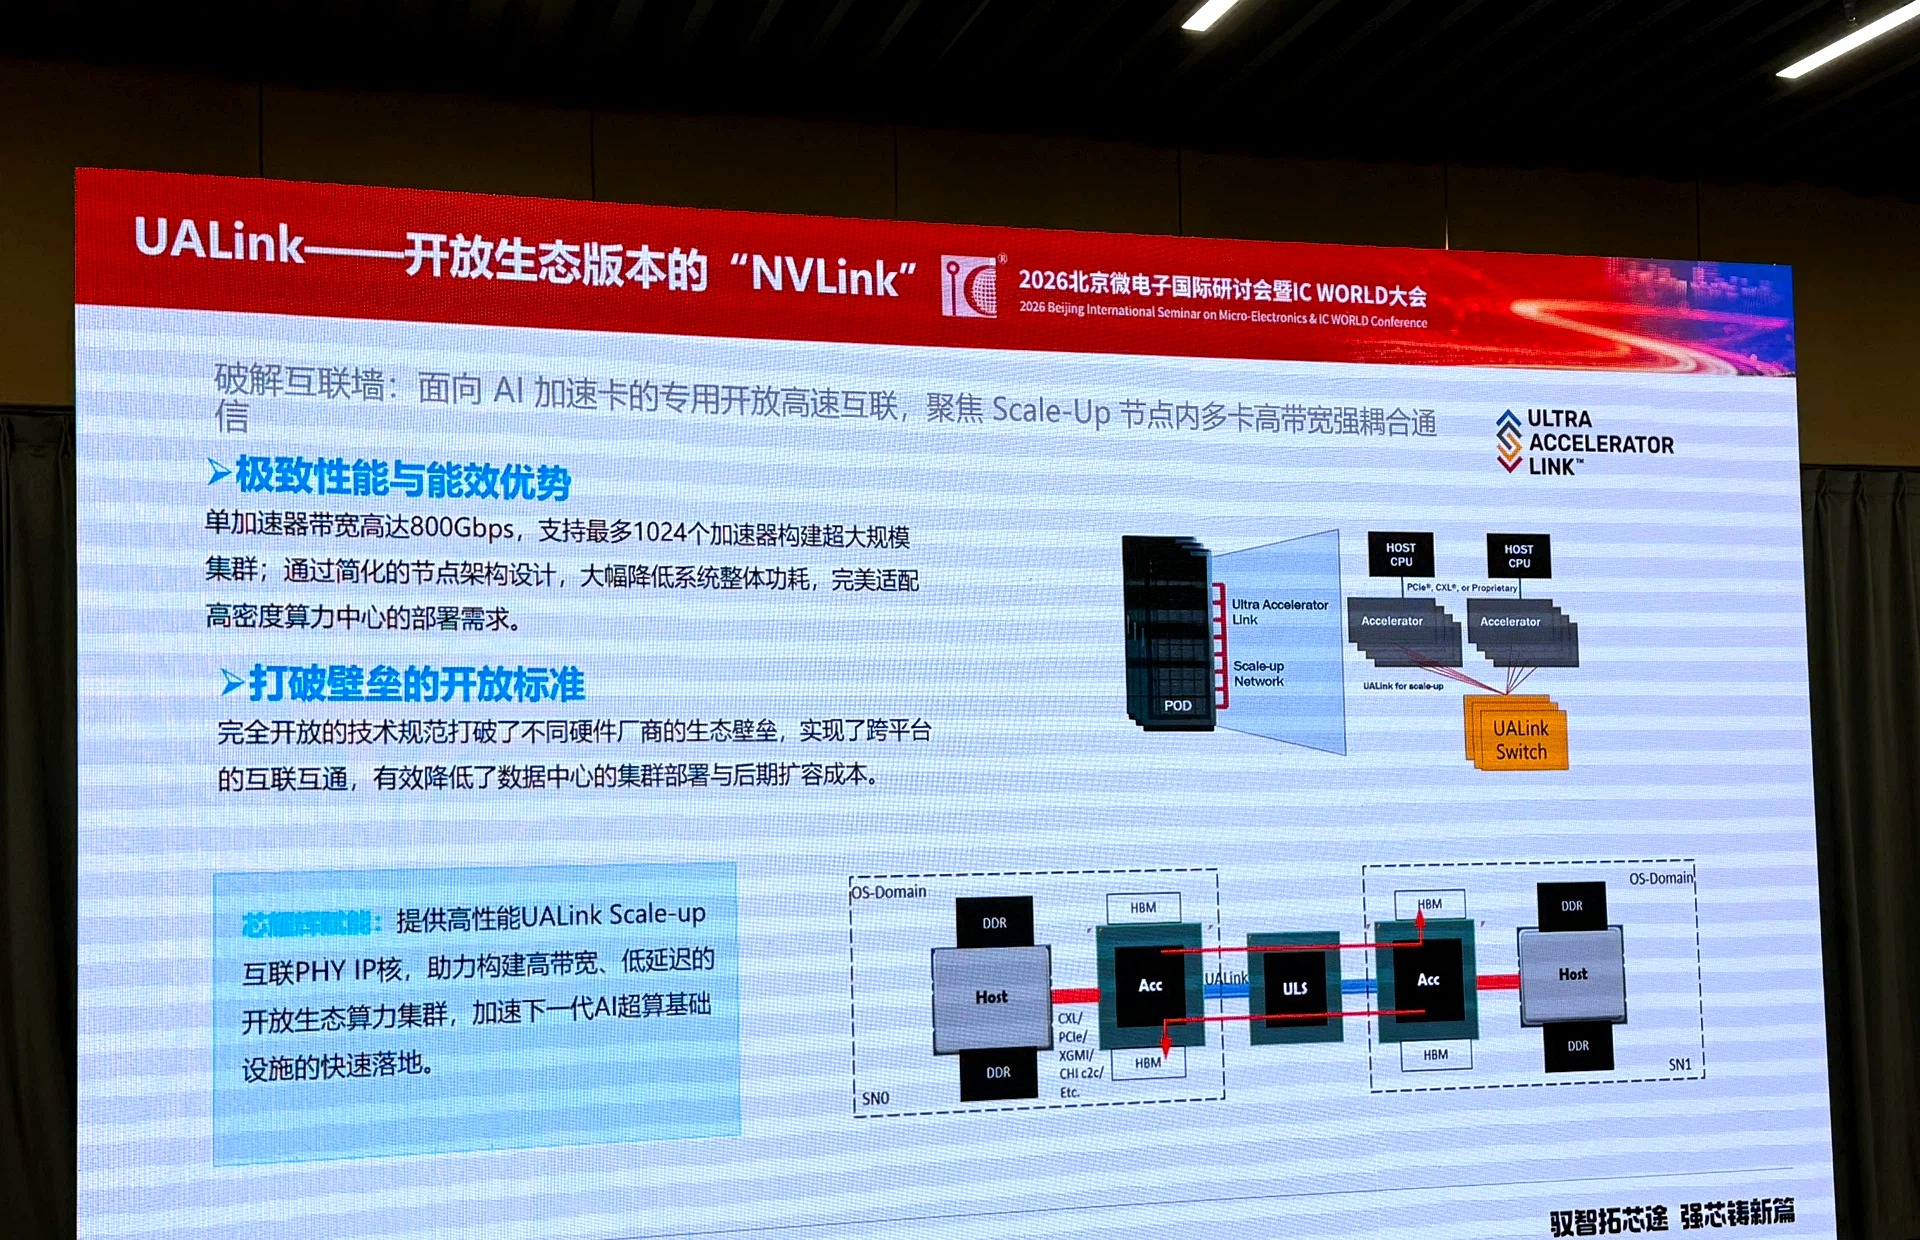
UALink放大
芯耀辉
UALink:开放生态版 NVLink
Scale-up 域开放标准,1024 加速器单域互连。
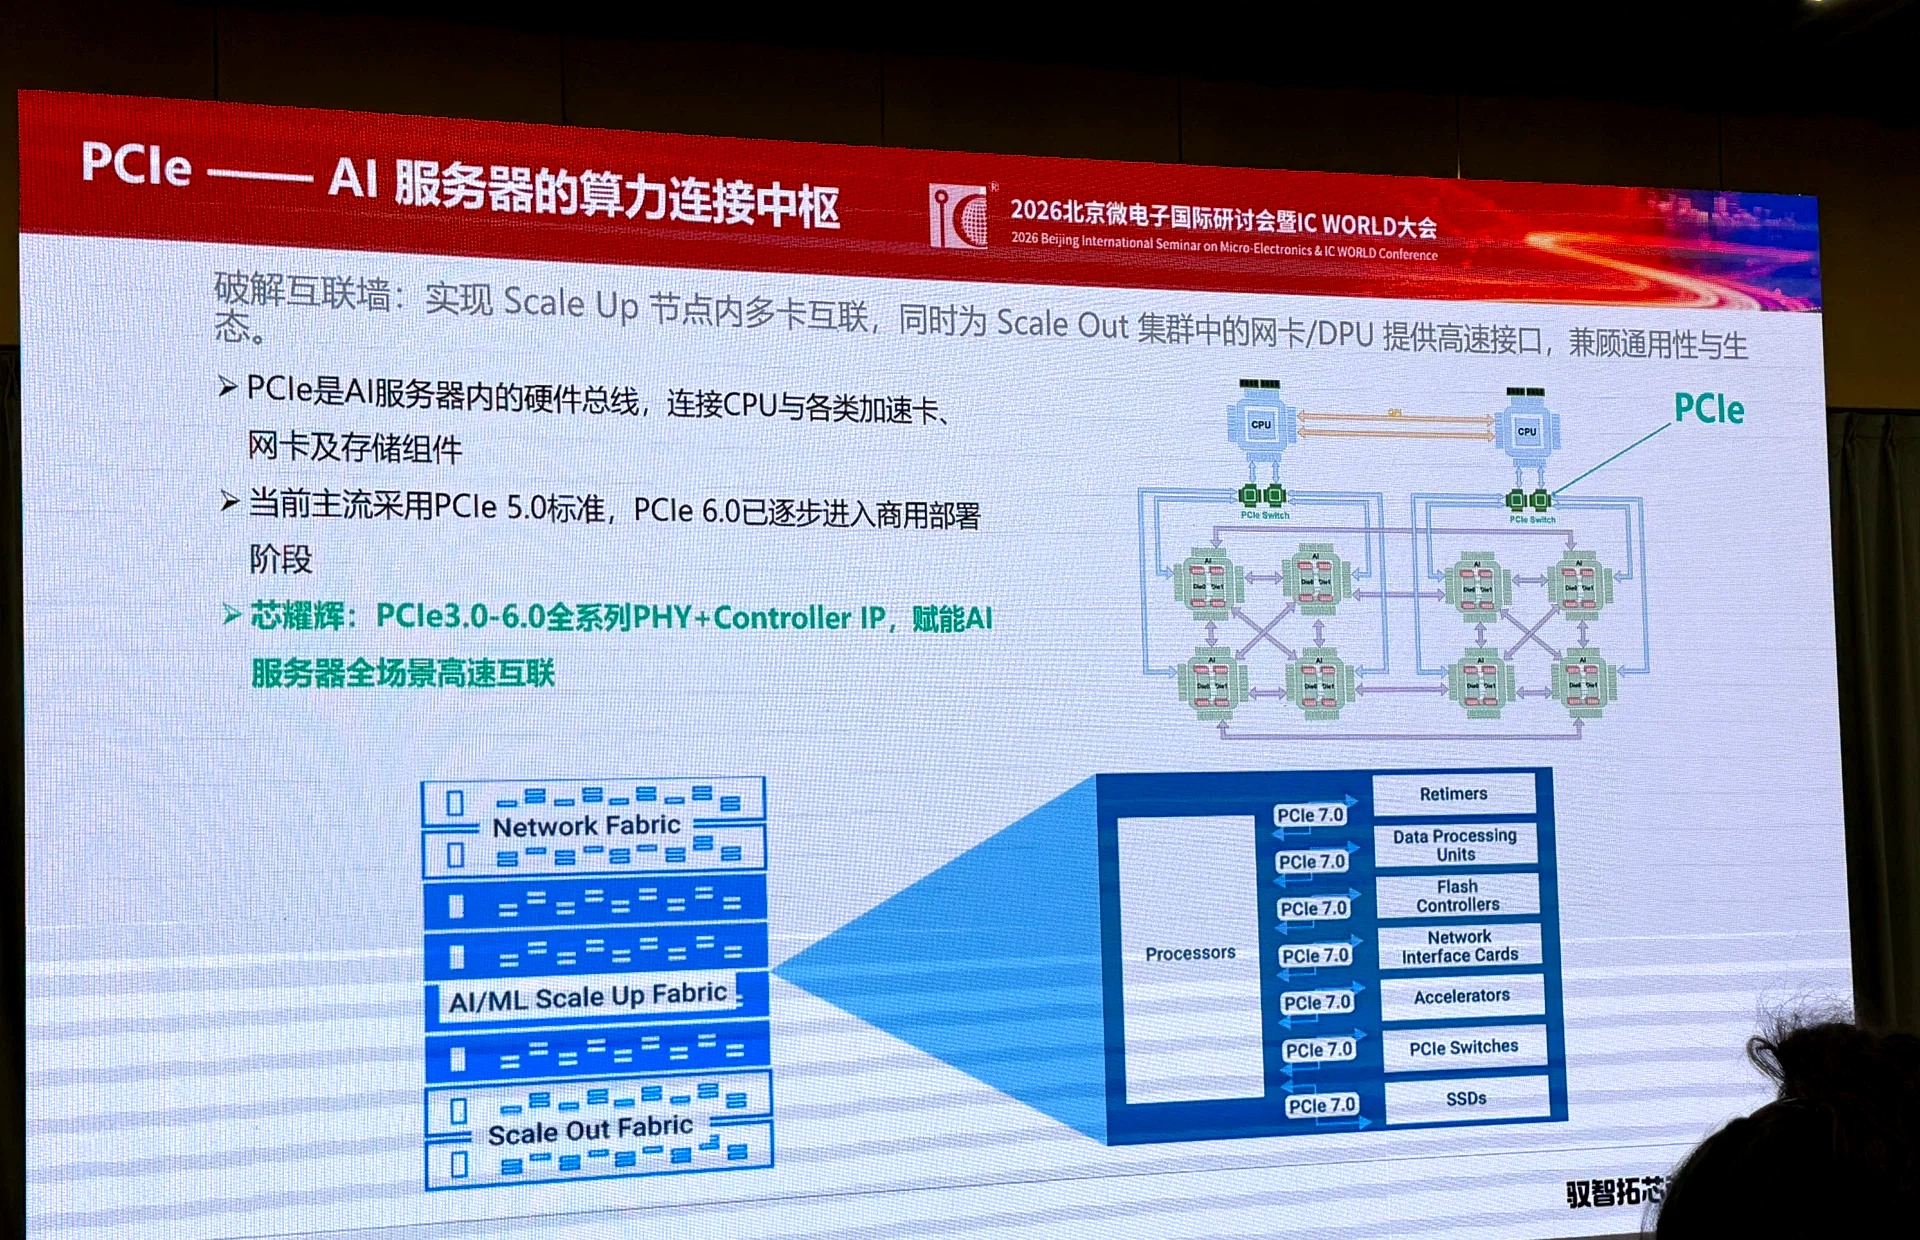
PCIe全系列放大
芯耀辉
PCIe 全系列控制器
AI 服务器算力连接中枢。
存储接口分层放大
芯耀辉
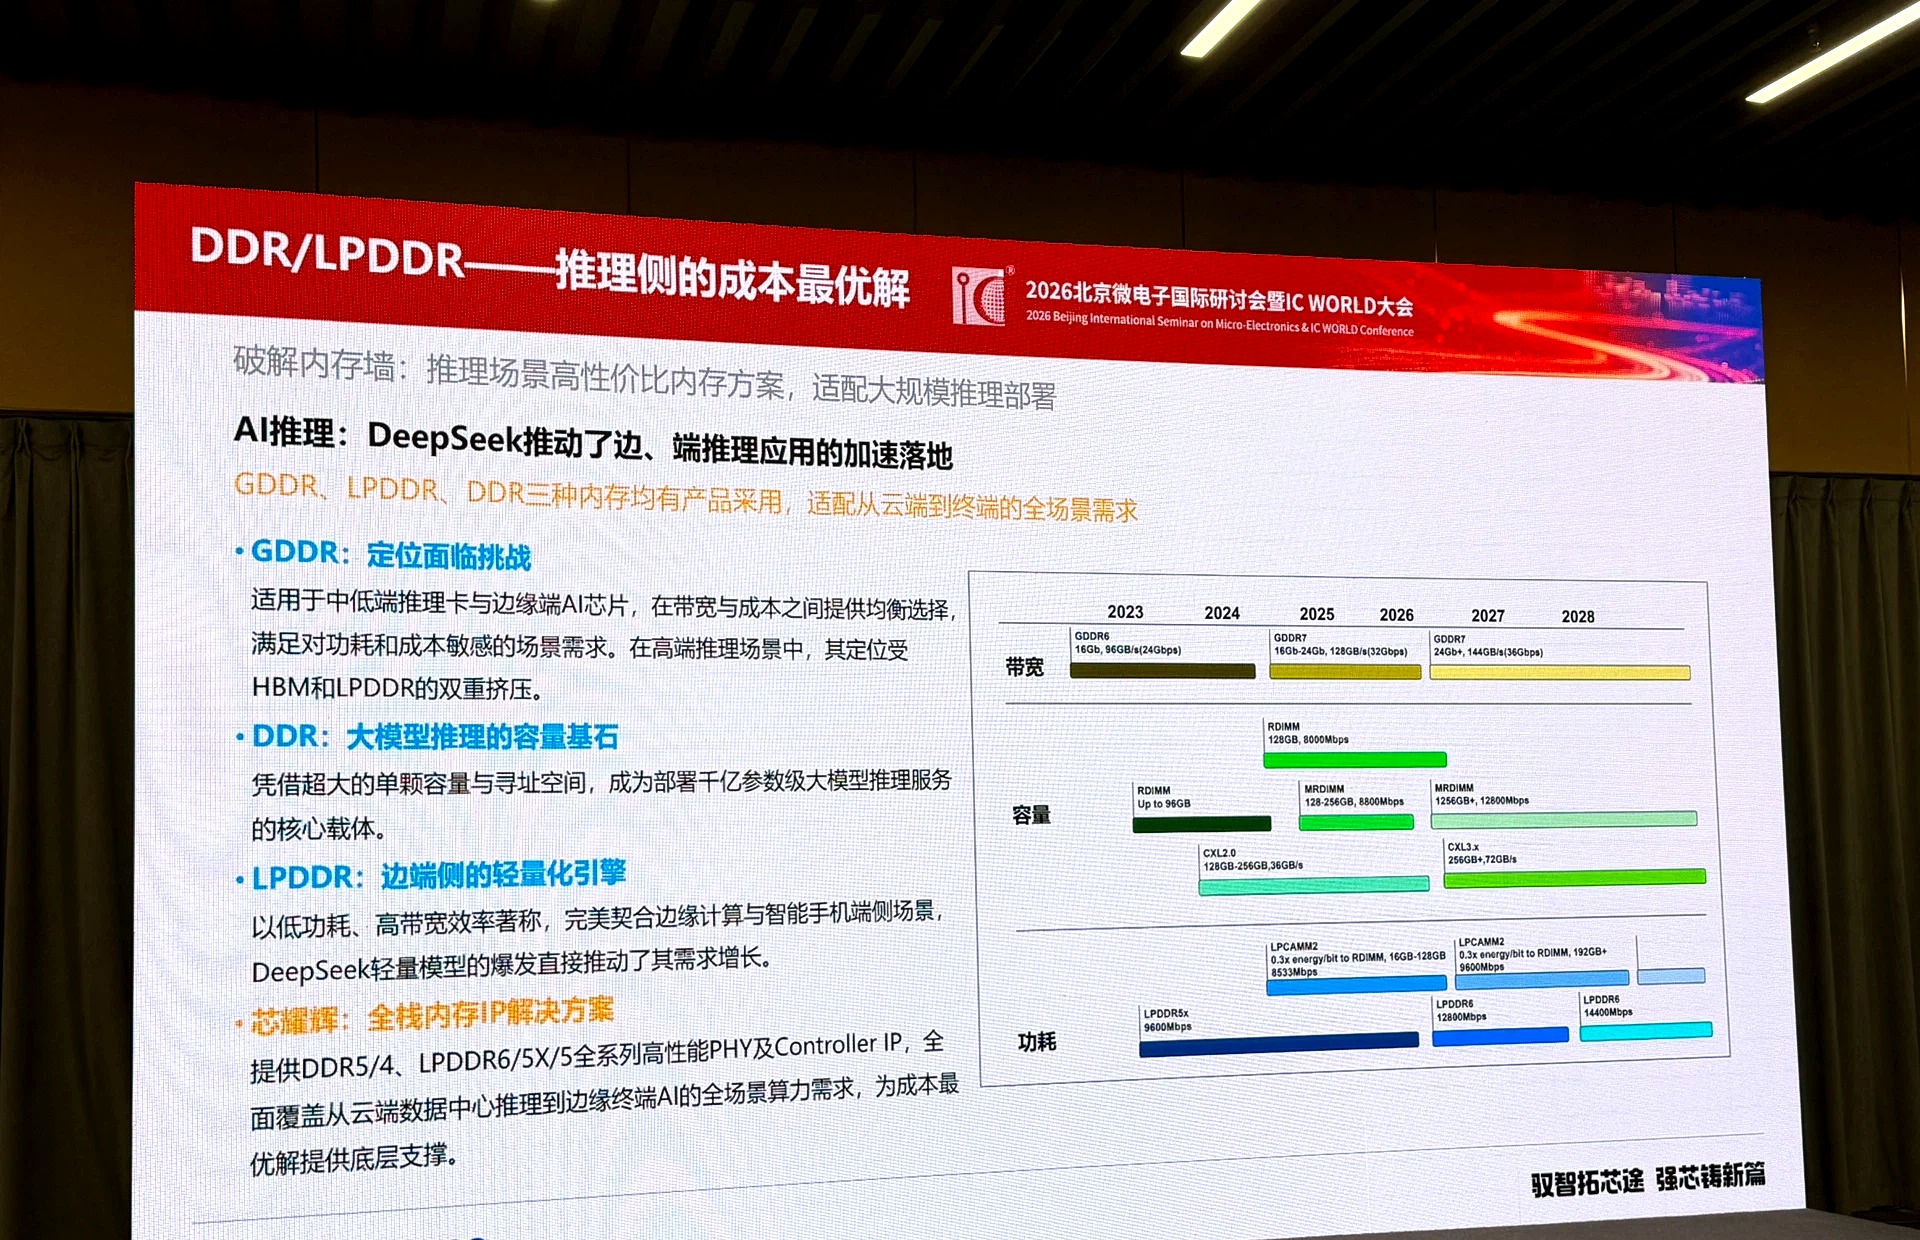
存储接口分层演进:DDR 守成本、HBM 抢带宽、UCIe 促解耦
推理时代的内存分层逻辑。
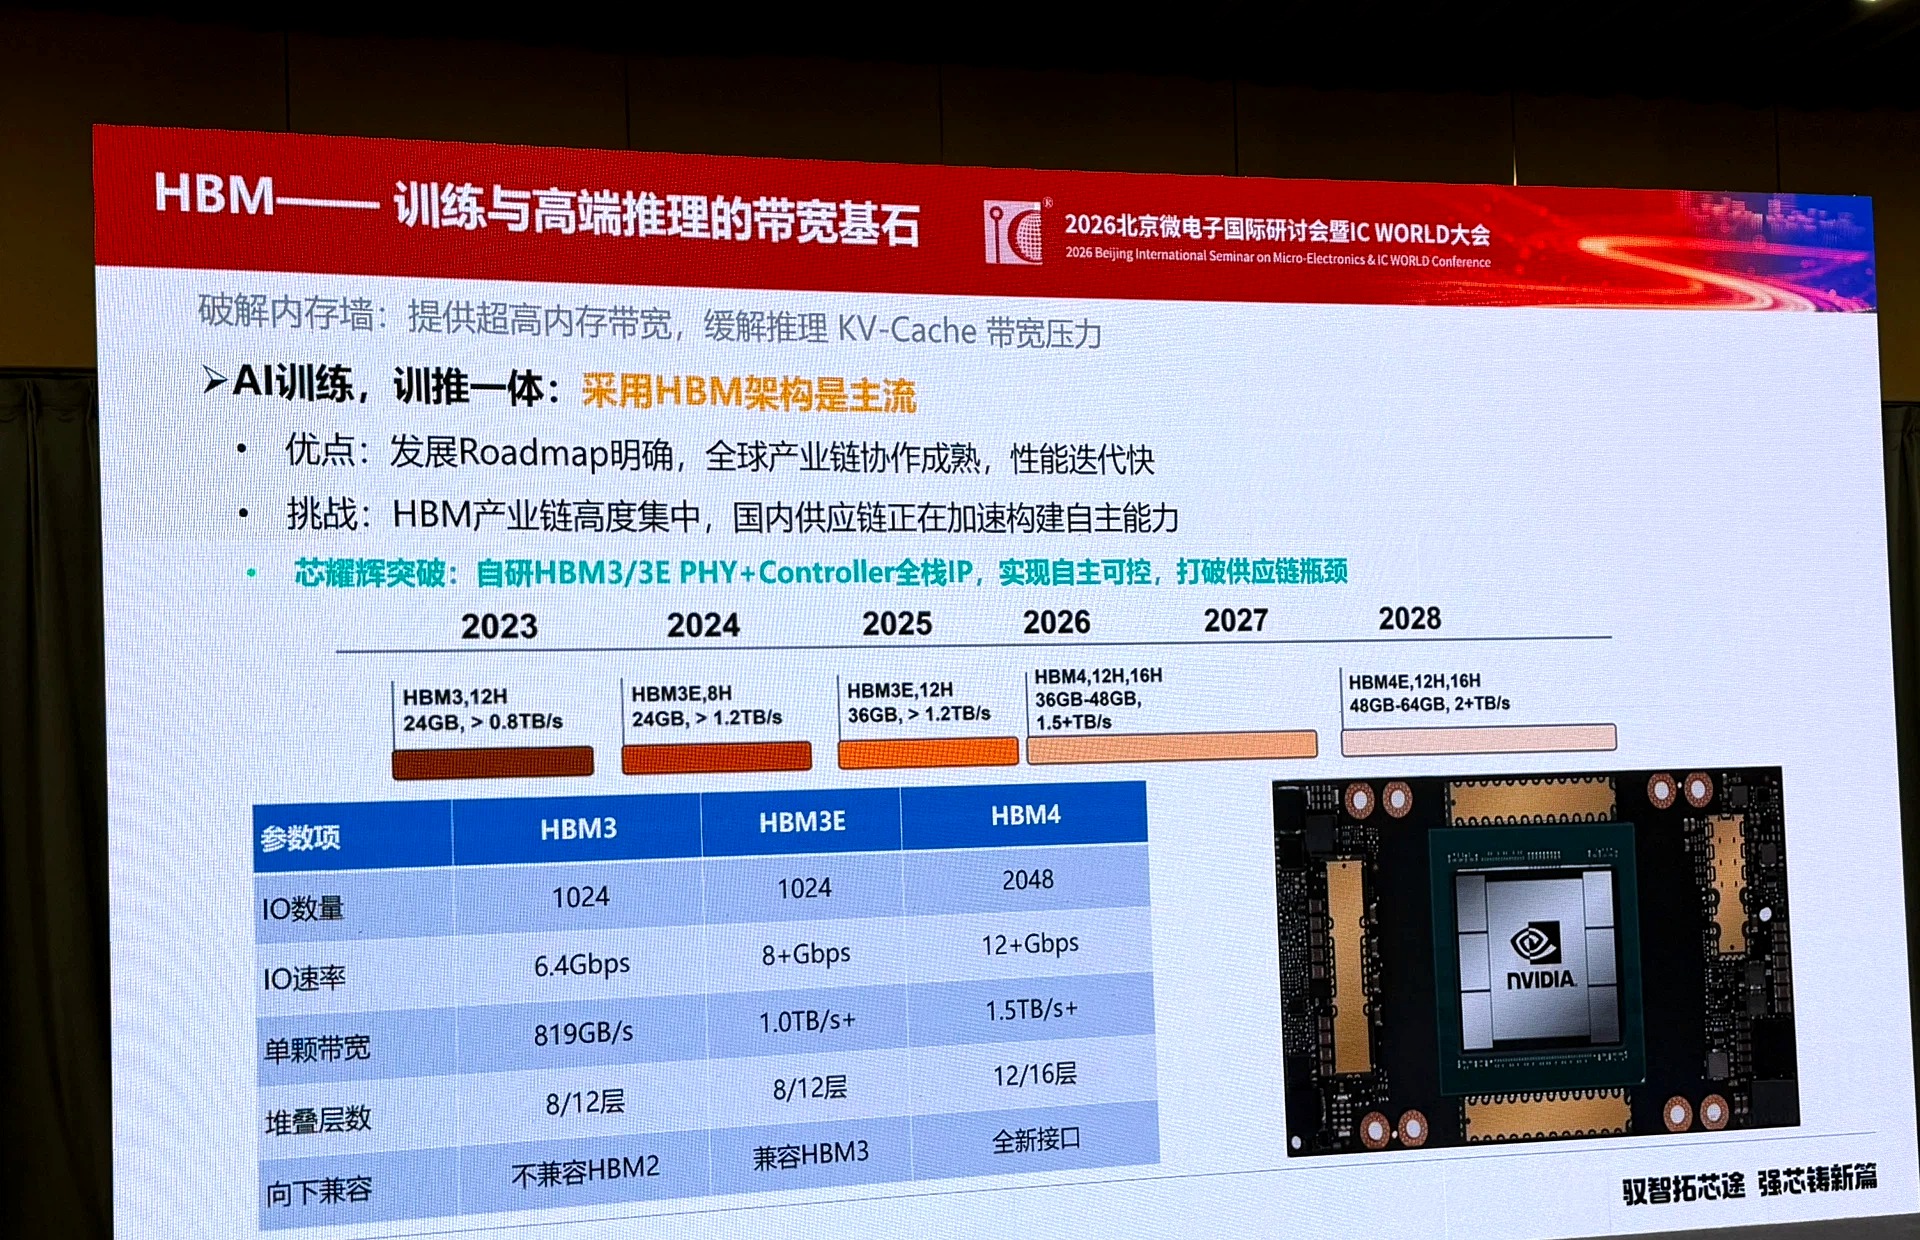
DDR全场景放大
芯耀辉
DDR 全场景覆盖
推理侧成本效率基石。
HBM3到HBM4放大
芯耀辉
HBM3 → HBM4
1.2 → 2 TB/s,位宽翻倍路径清晰。
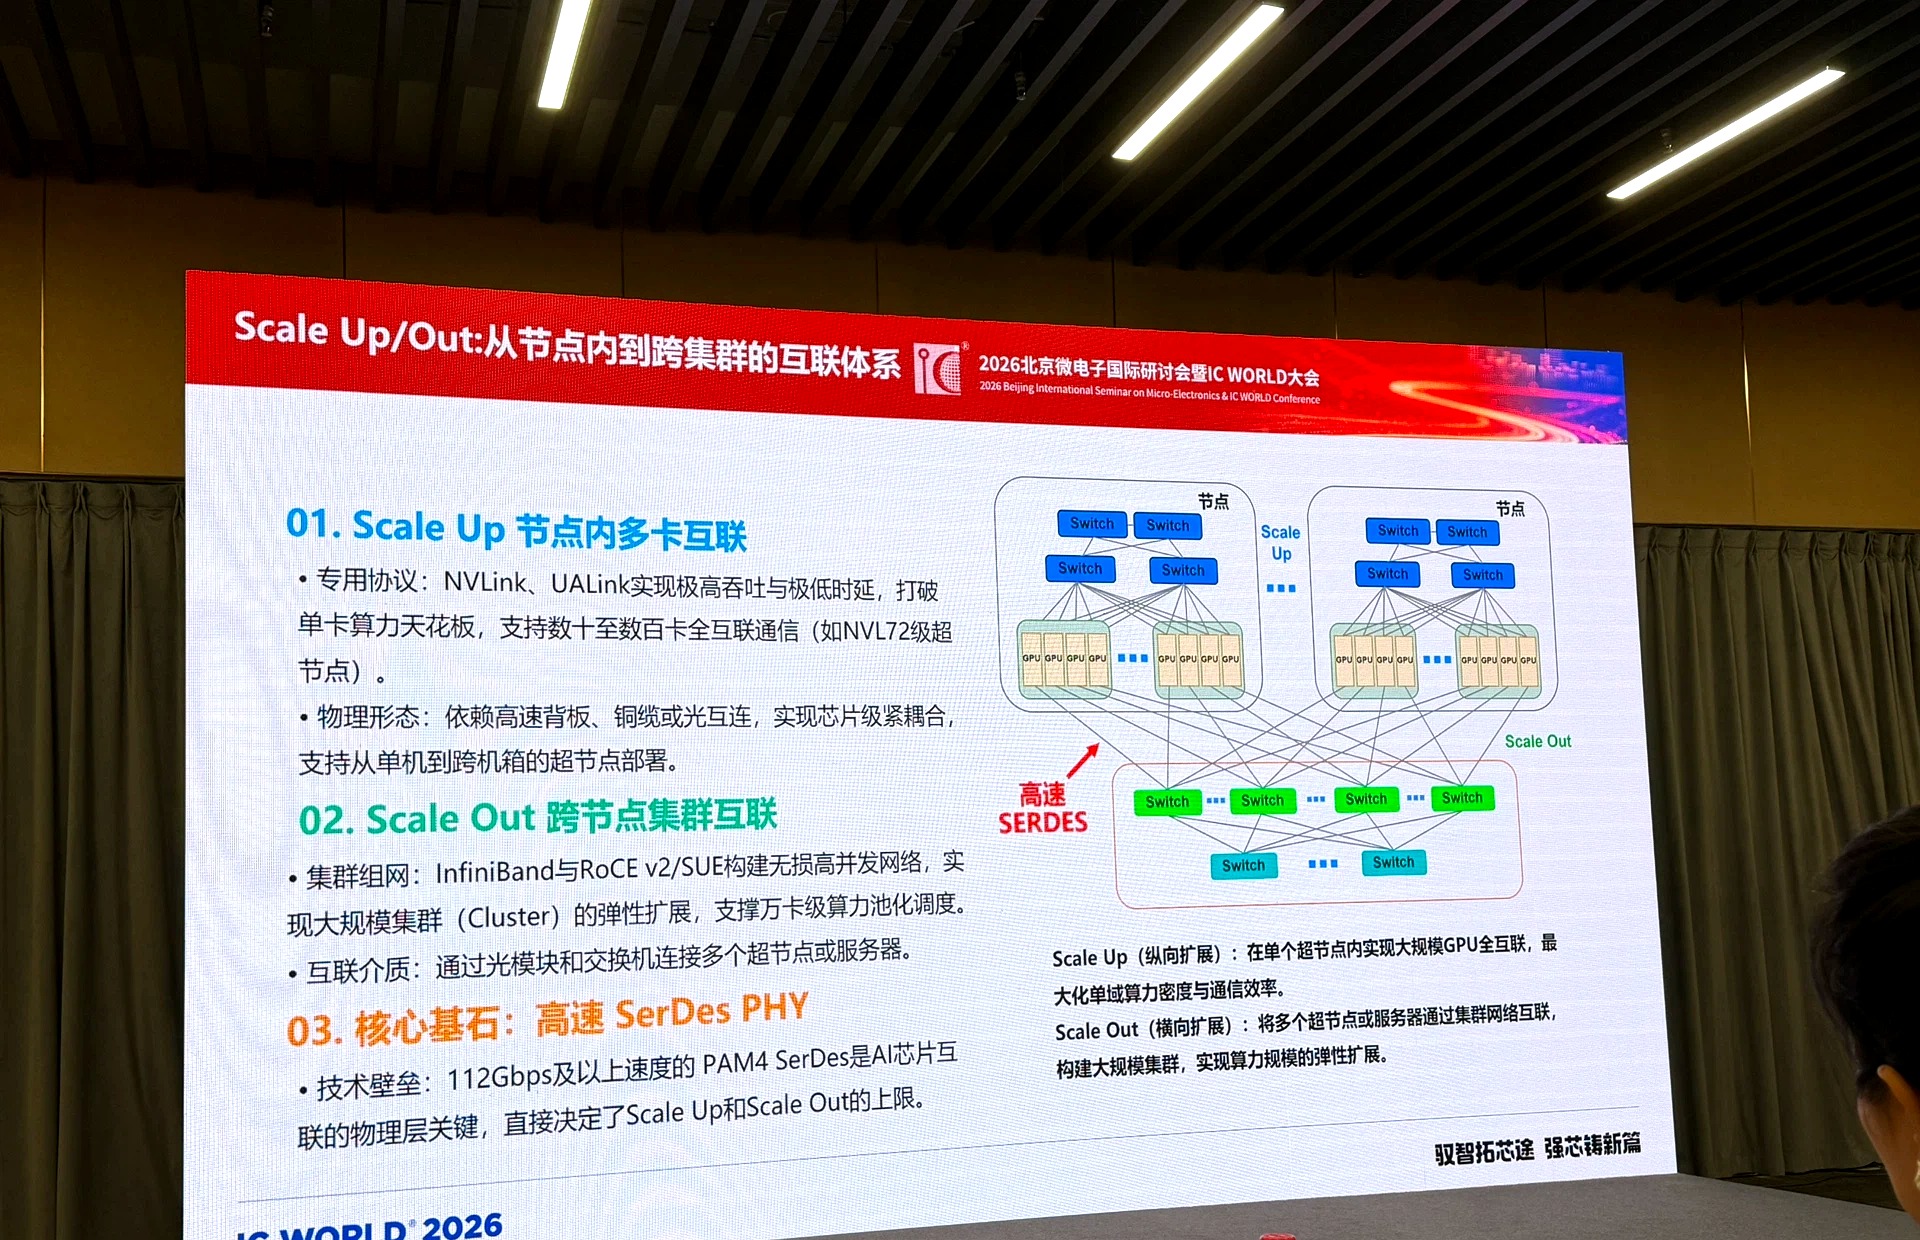
Scale三层放大
芯耀辉
Scale In / Up / Out 三层互联体系
超节点重新定义算力单位。
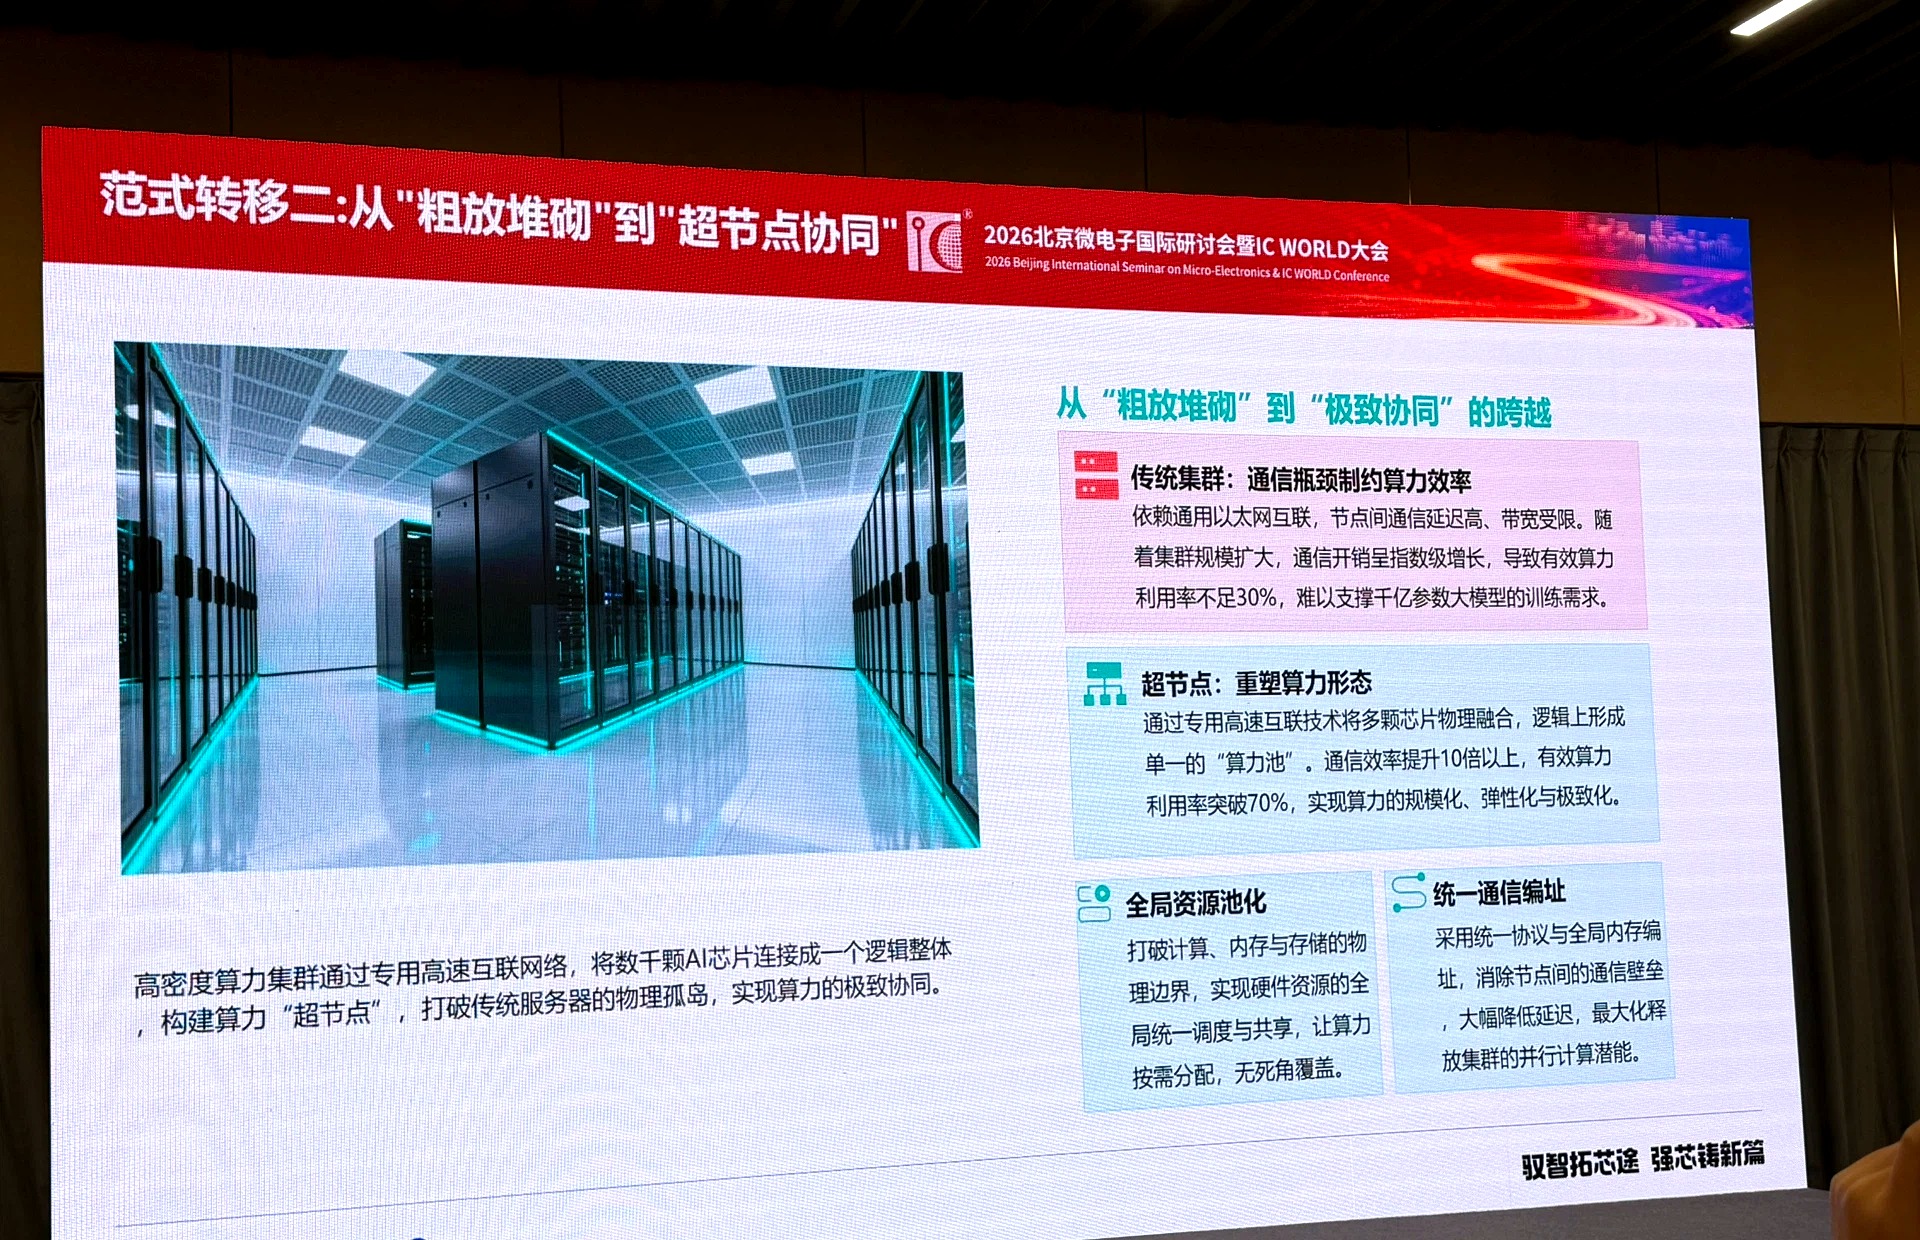
超节点协同放大
大会主论坛 · 范式转移 ②
从「粗放堆砌」到「超节点协同」
有效算力利用率 <30% → 突破 70%。
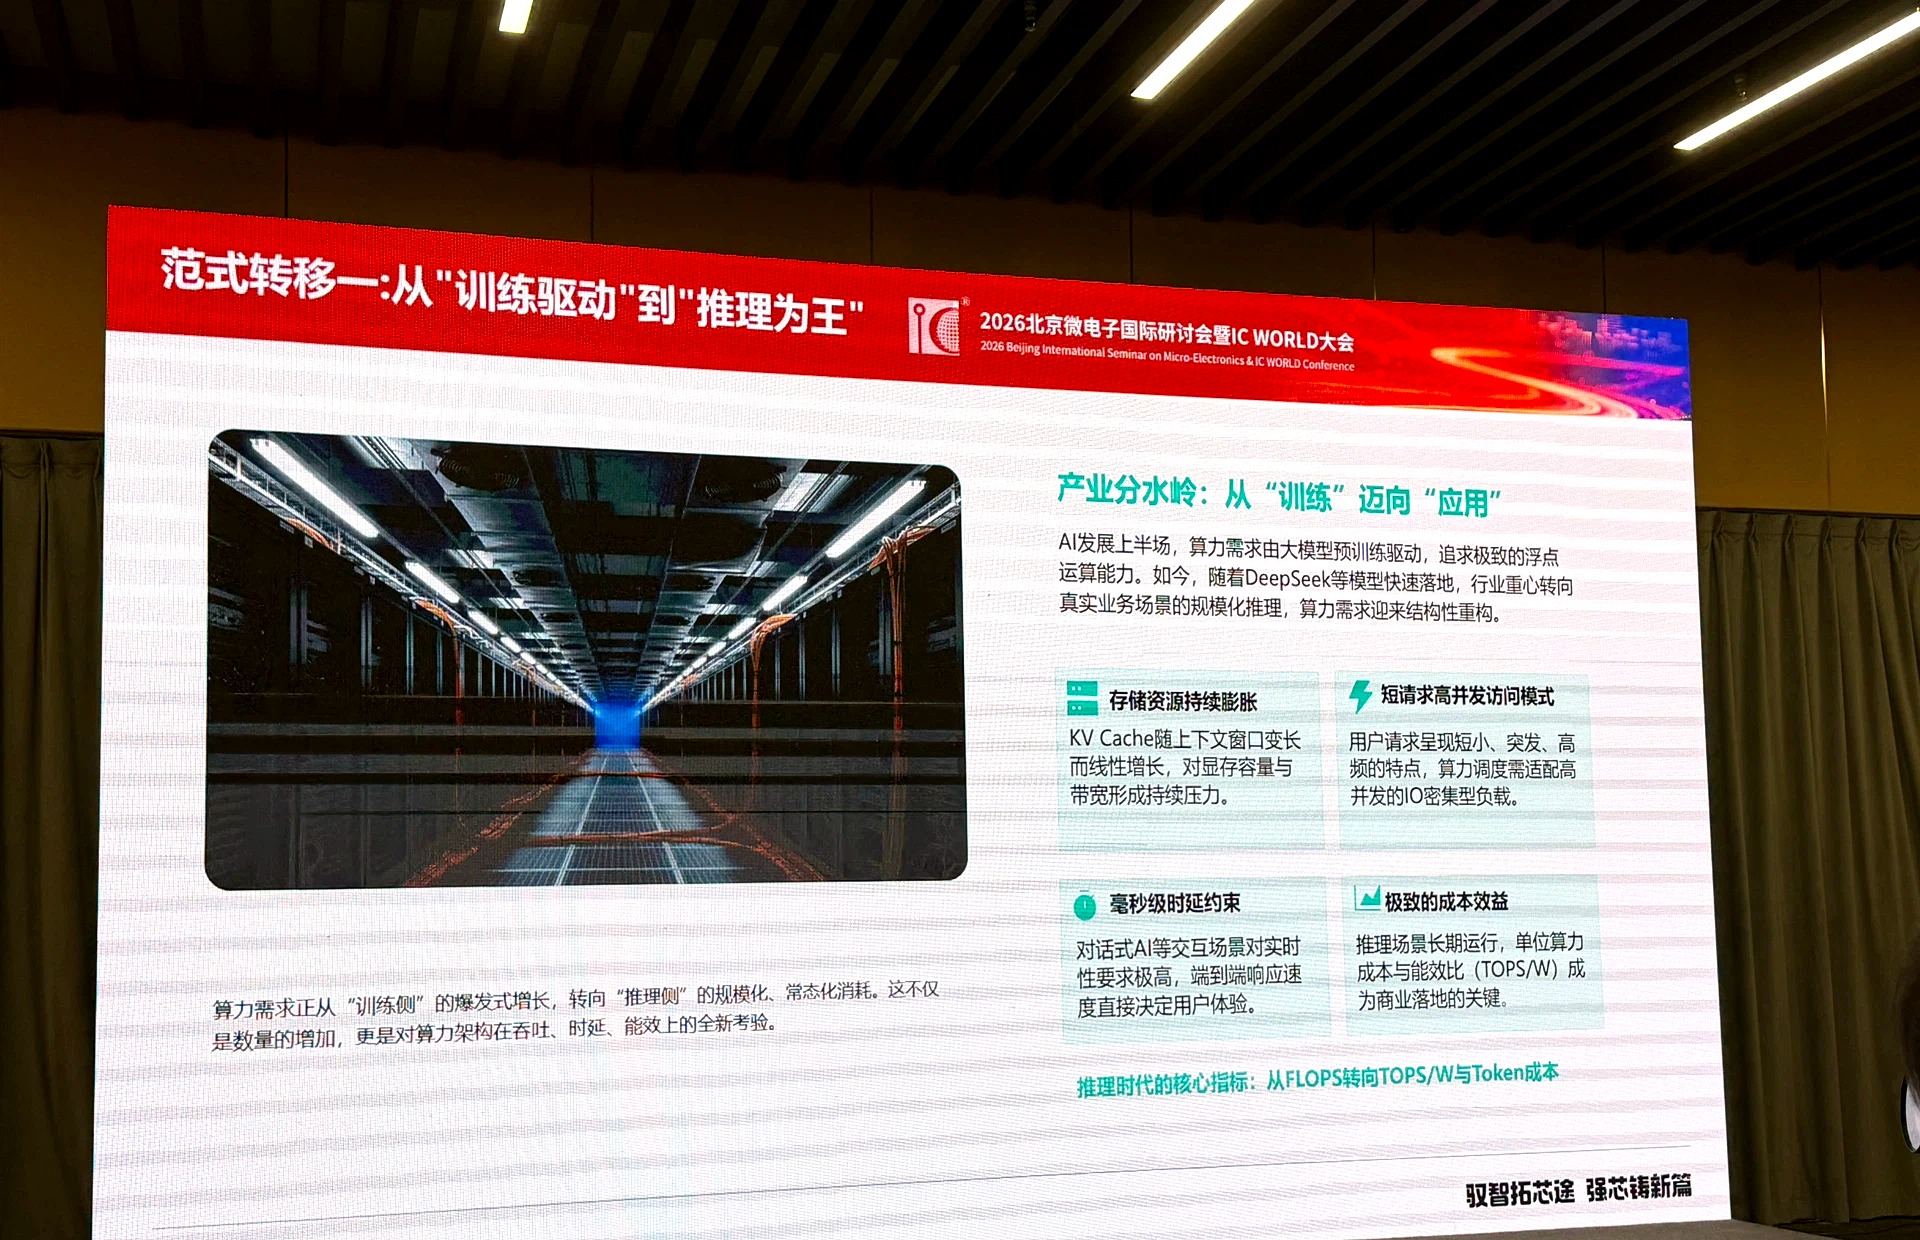
推理为王放大
大会主论坛 · 范式转移 ①
从「训练驱动」到「推理为王」
评价坐标换轨:FLOPS → TOPS/W × Token 成本。
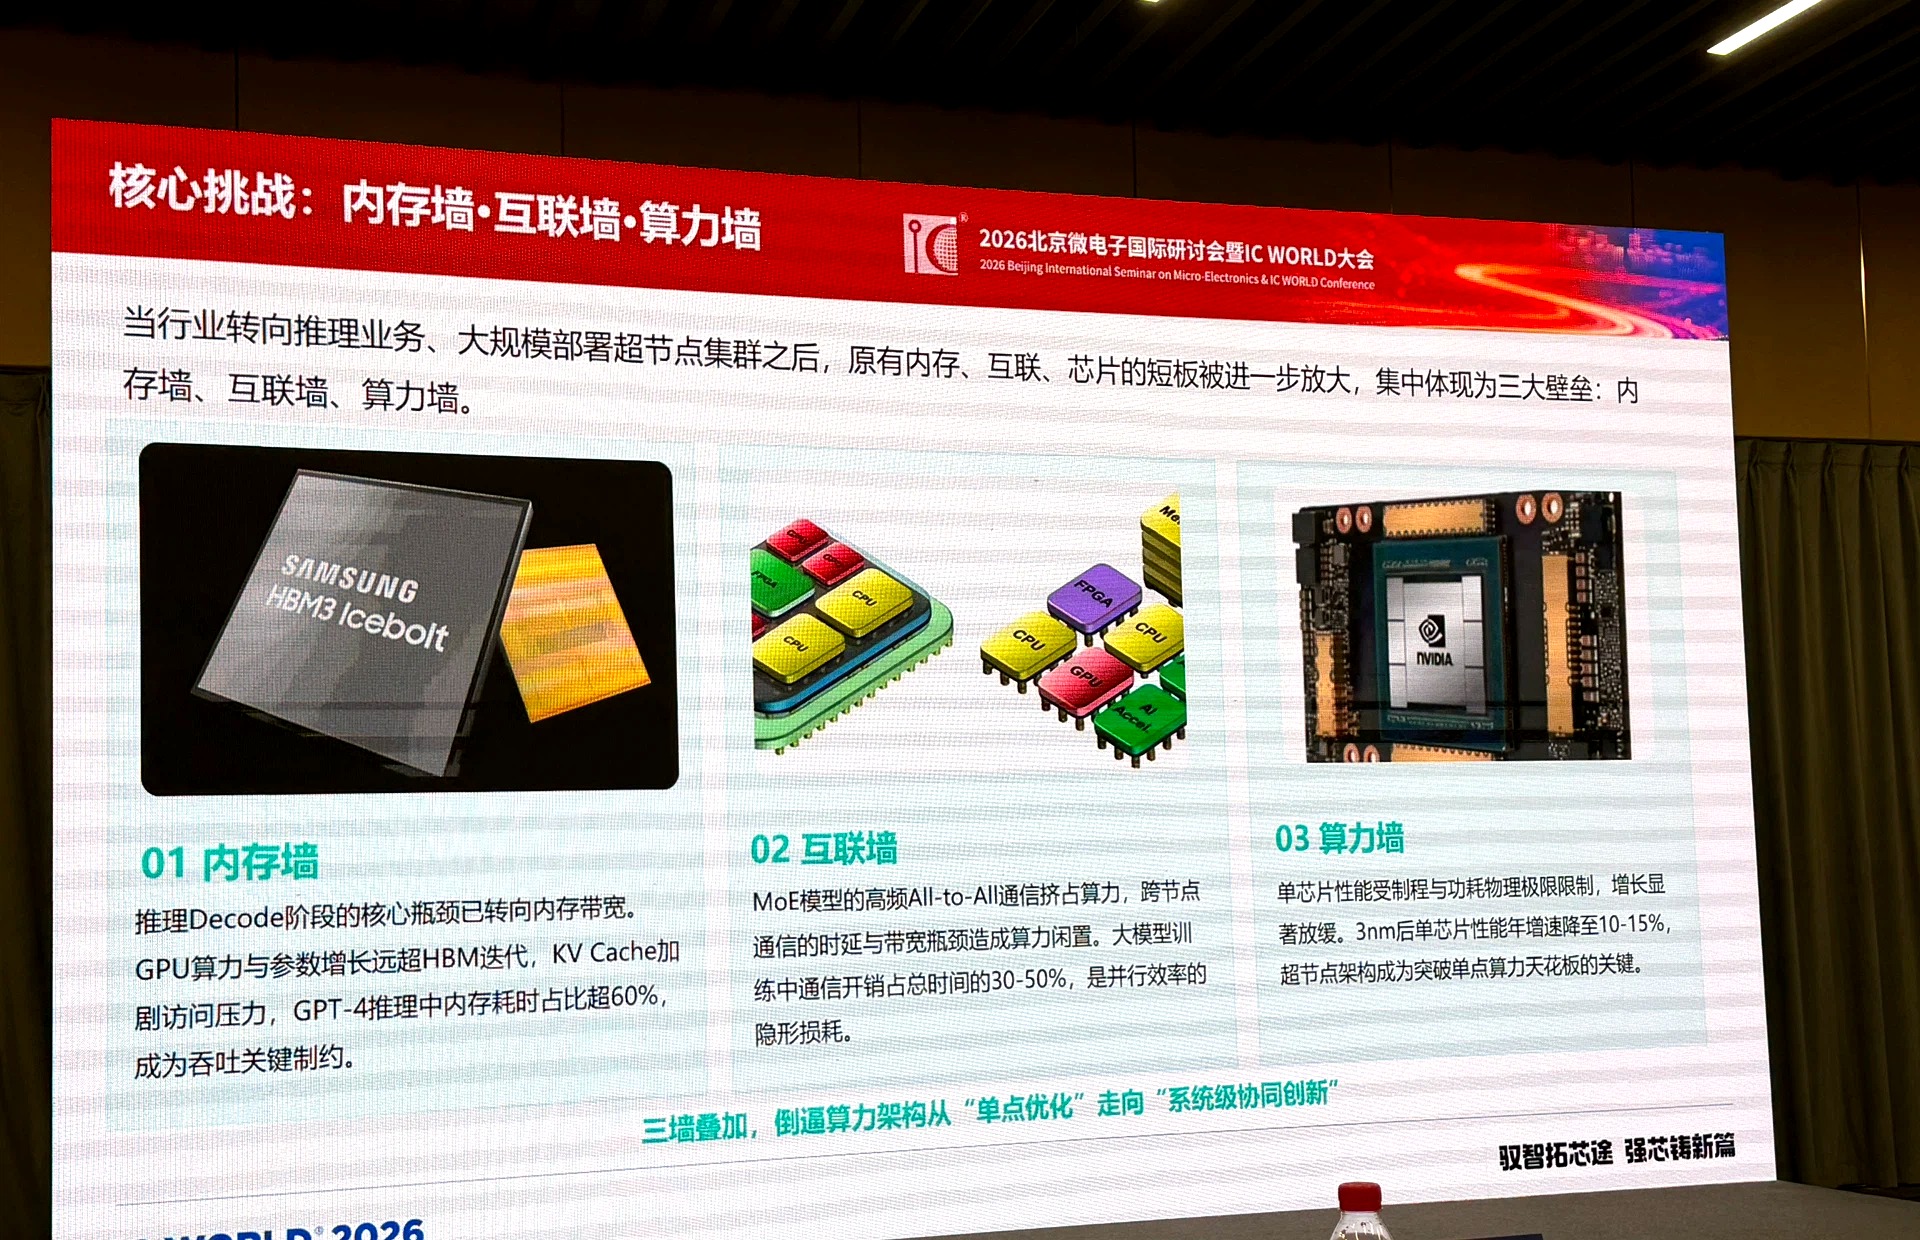
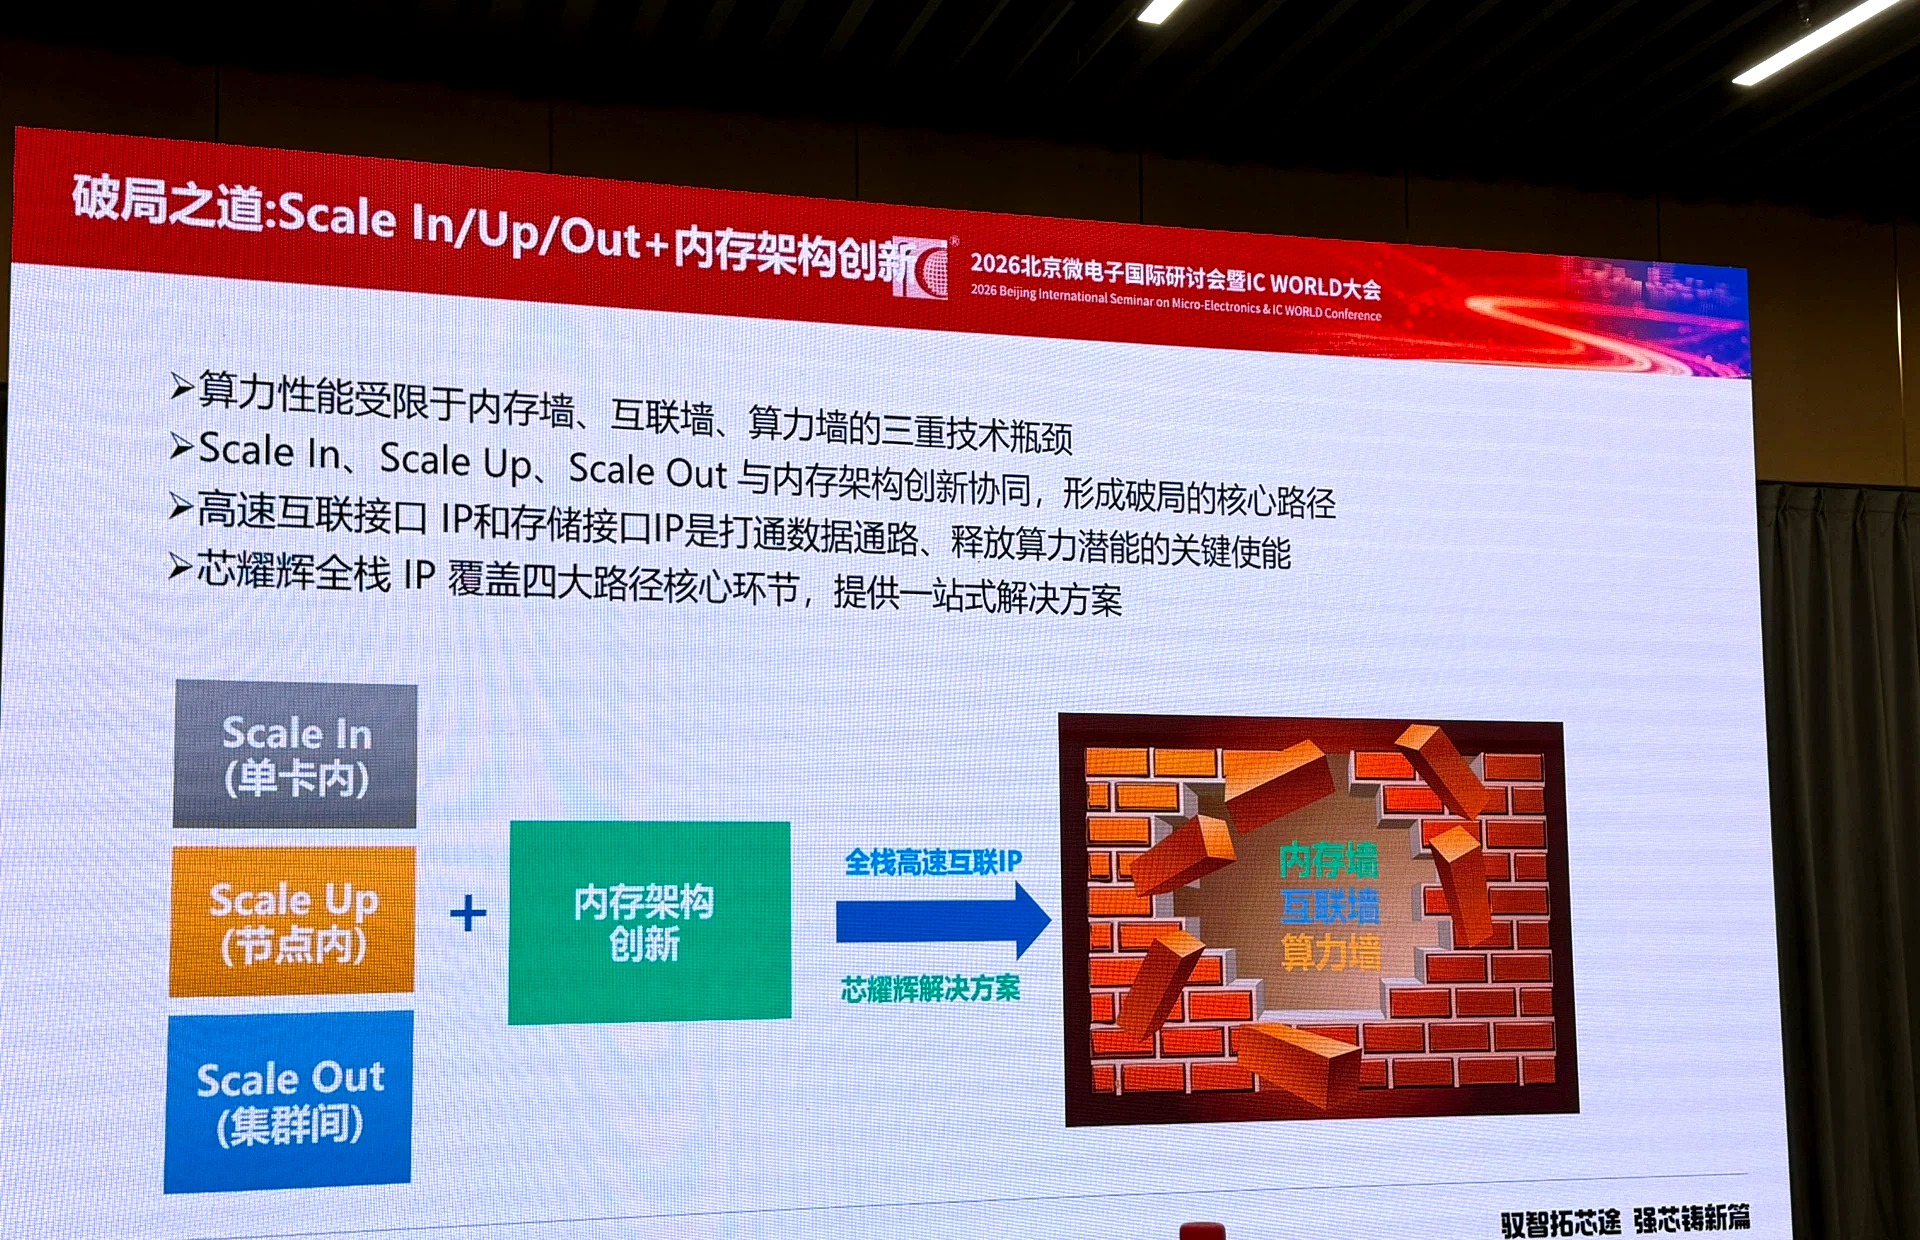
三墙放大
芯耀辉 × 华为《智能世界 2035》
三大瓶颈与破局之道
先进制程收益收窄,系统级创新成为主路径。
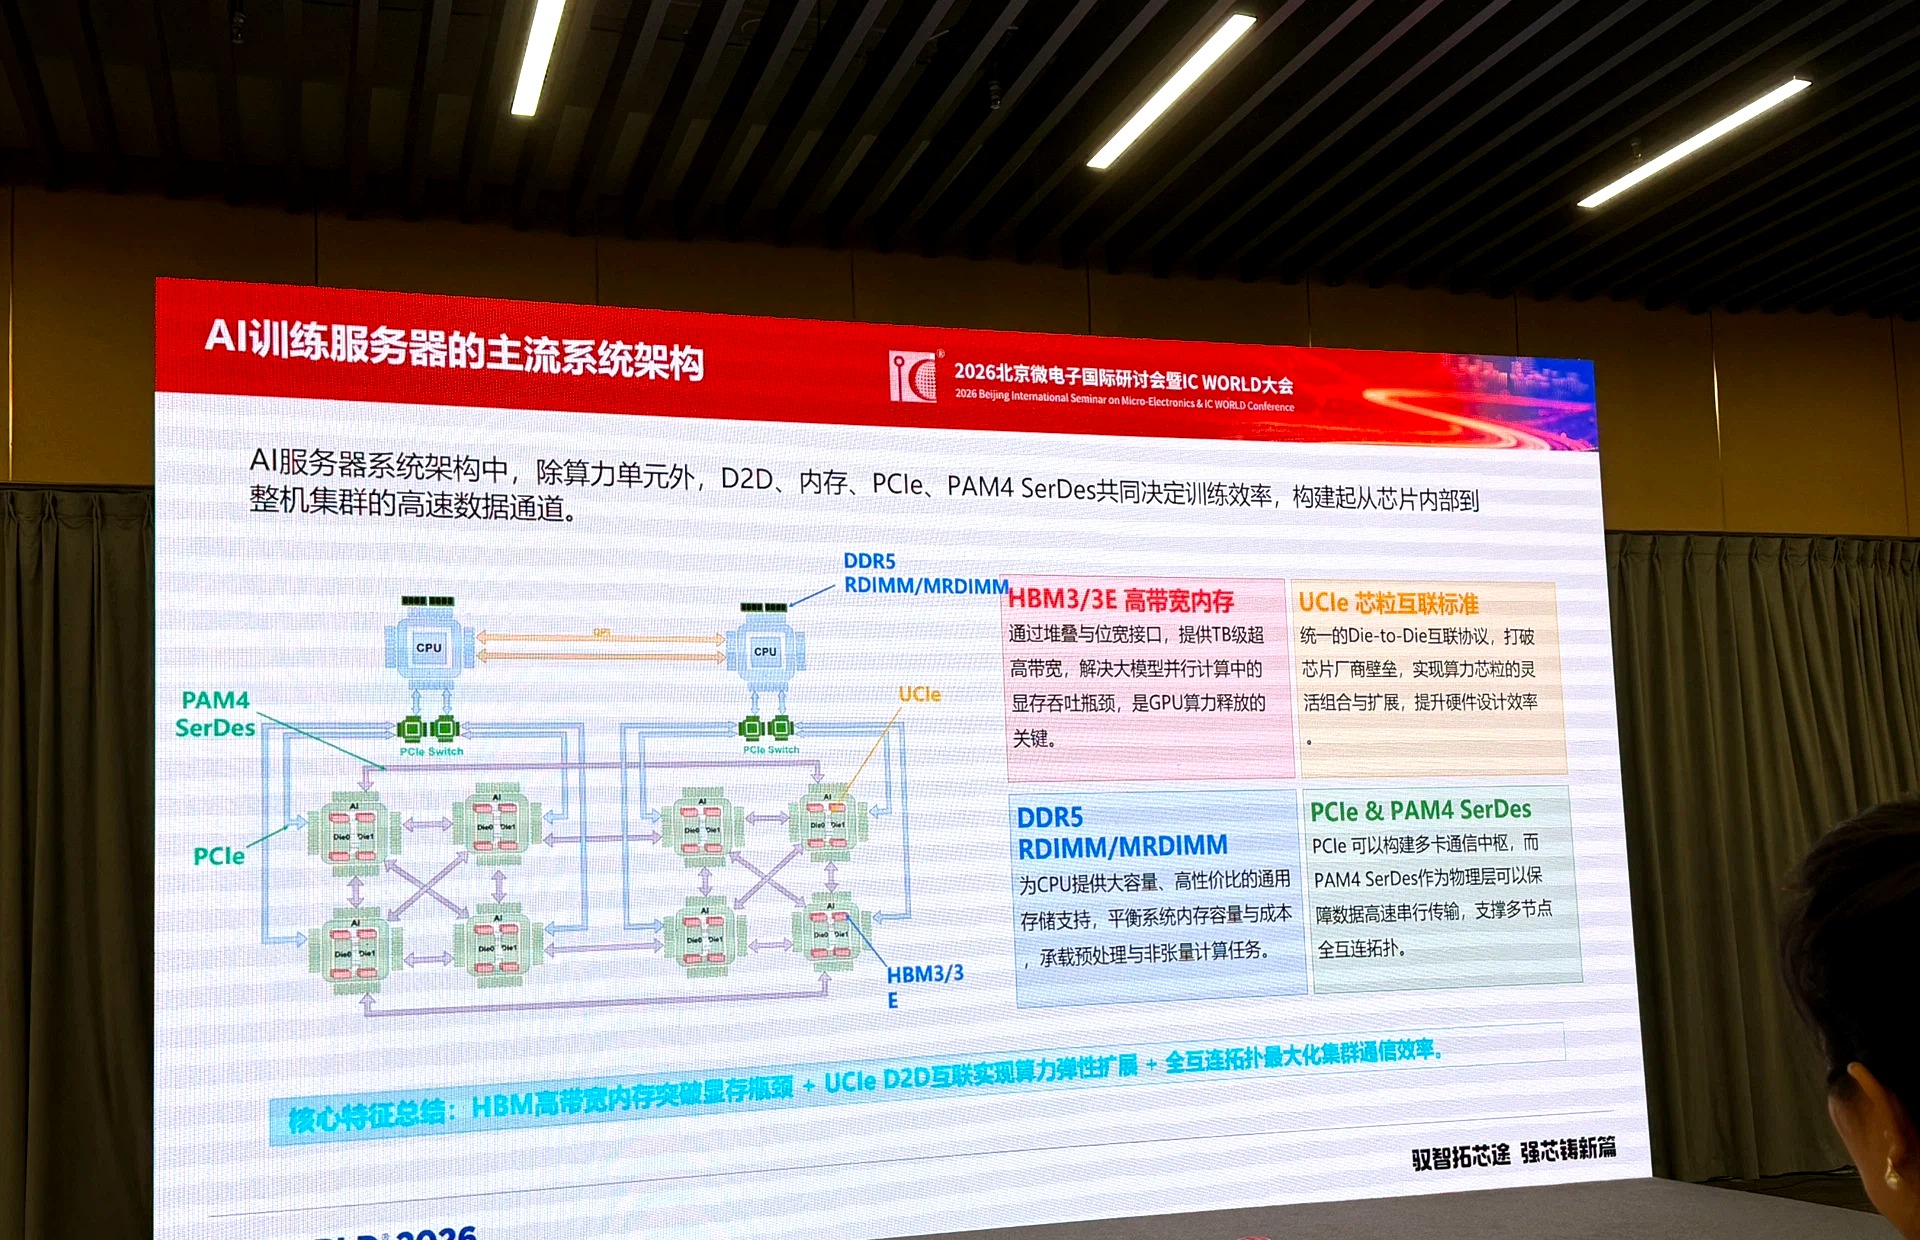
PAM4互连放大
芯耀辉
HBM3E + UCIe + PAM4 全互连
高带宽低时延的物理层组合。
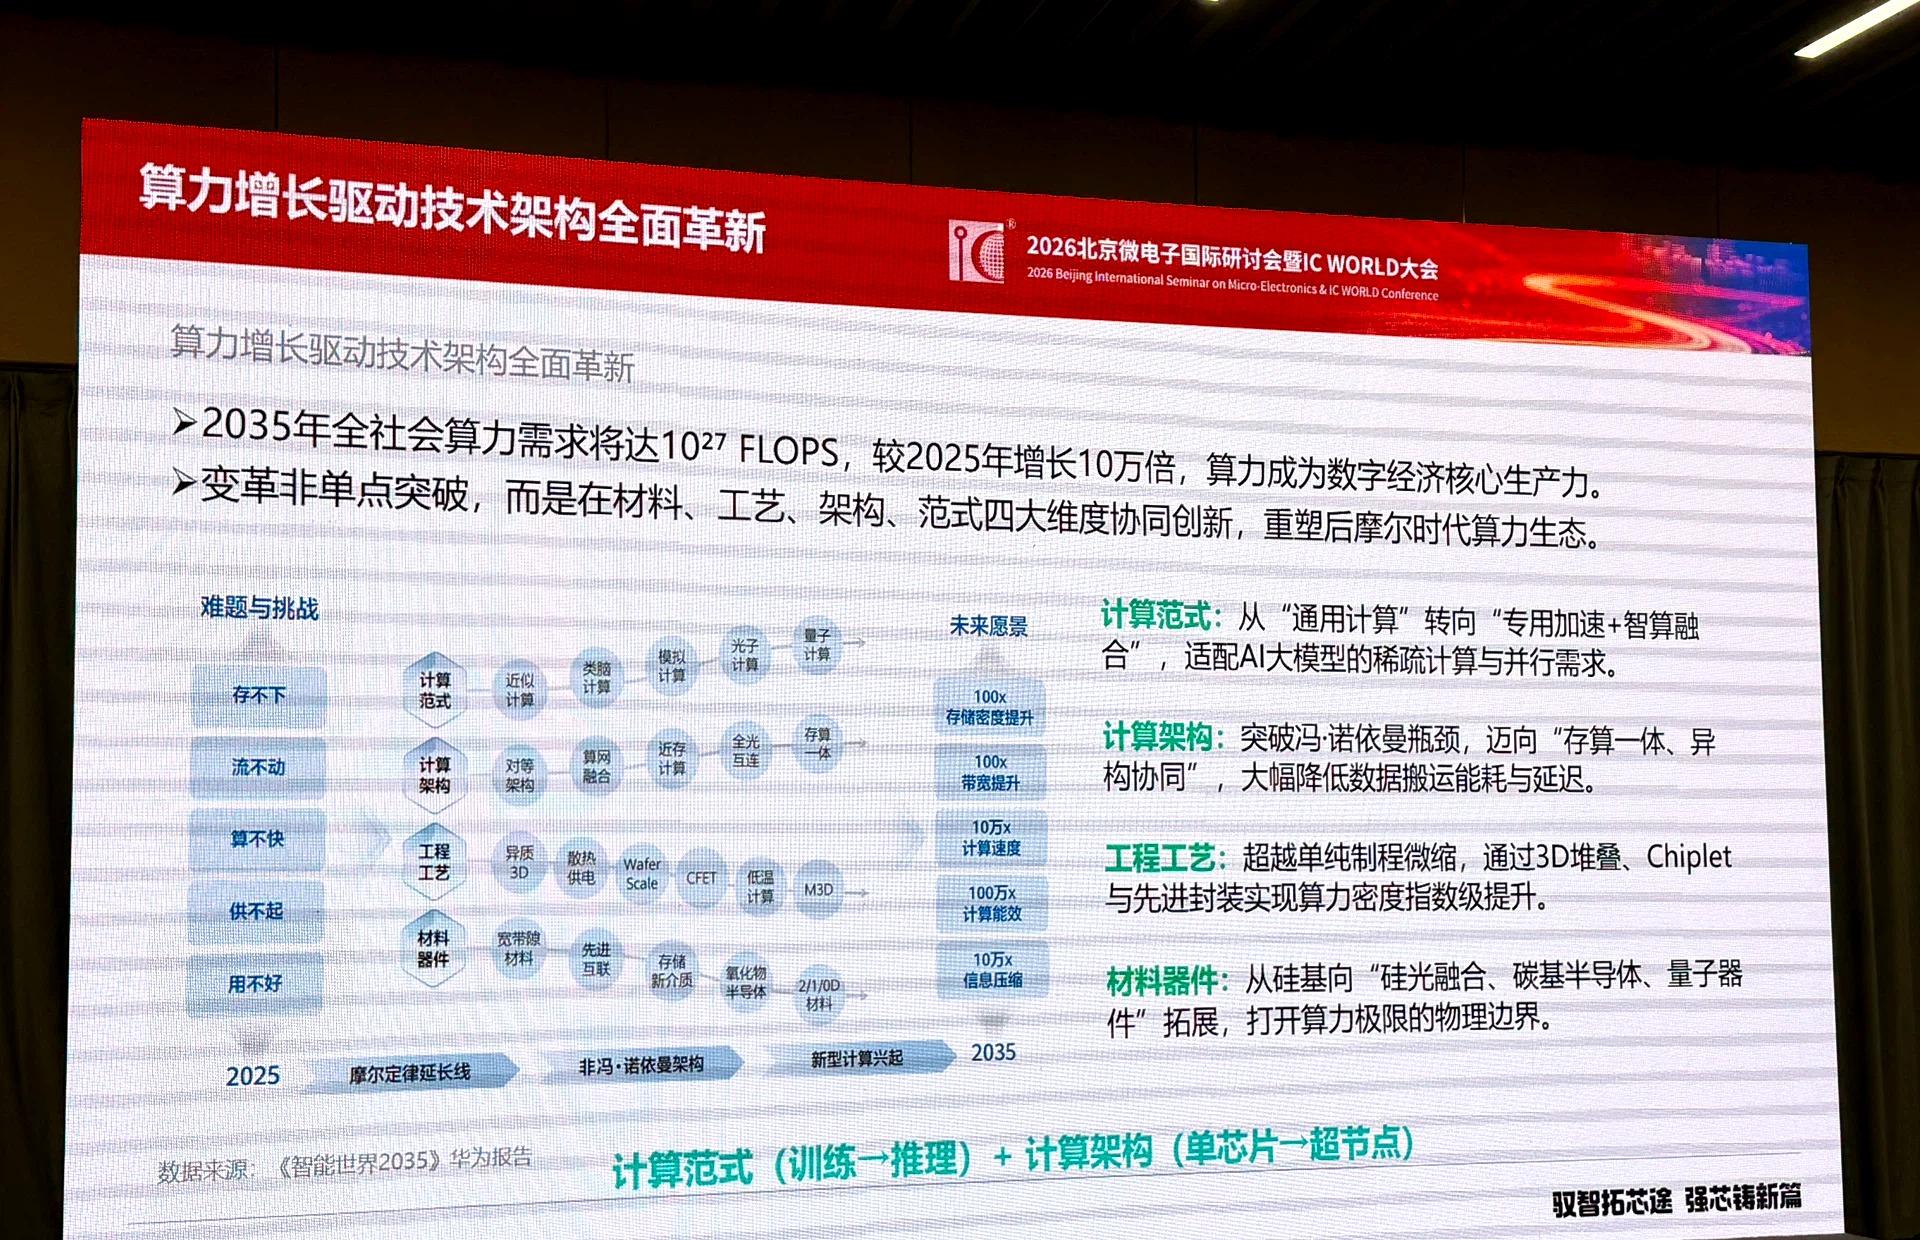
2035算力放大
华为《智能世界 2035》
2035:10²⁷ FLOPS 时代
Token 全链路智能基础设施的需求坐标。
互联效率放大
芯耀辉
互联效率即算力
通信优化把集群「名义算力」变「有效算力」。
IP矩阵放大
芯耀辉
全栈 IP 矩阵
平台化定制能力。
6.3 3D 集成与存算一体
先进封装路线图放大
拓荆键科 / 北京大学
先进封装十年路线:混合键合与玻璃基板定调 2030
三维集成本质是互连演进——微凸块→混合键合→晶体管堆叠。
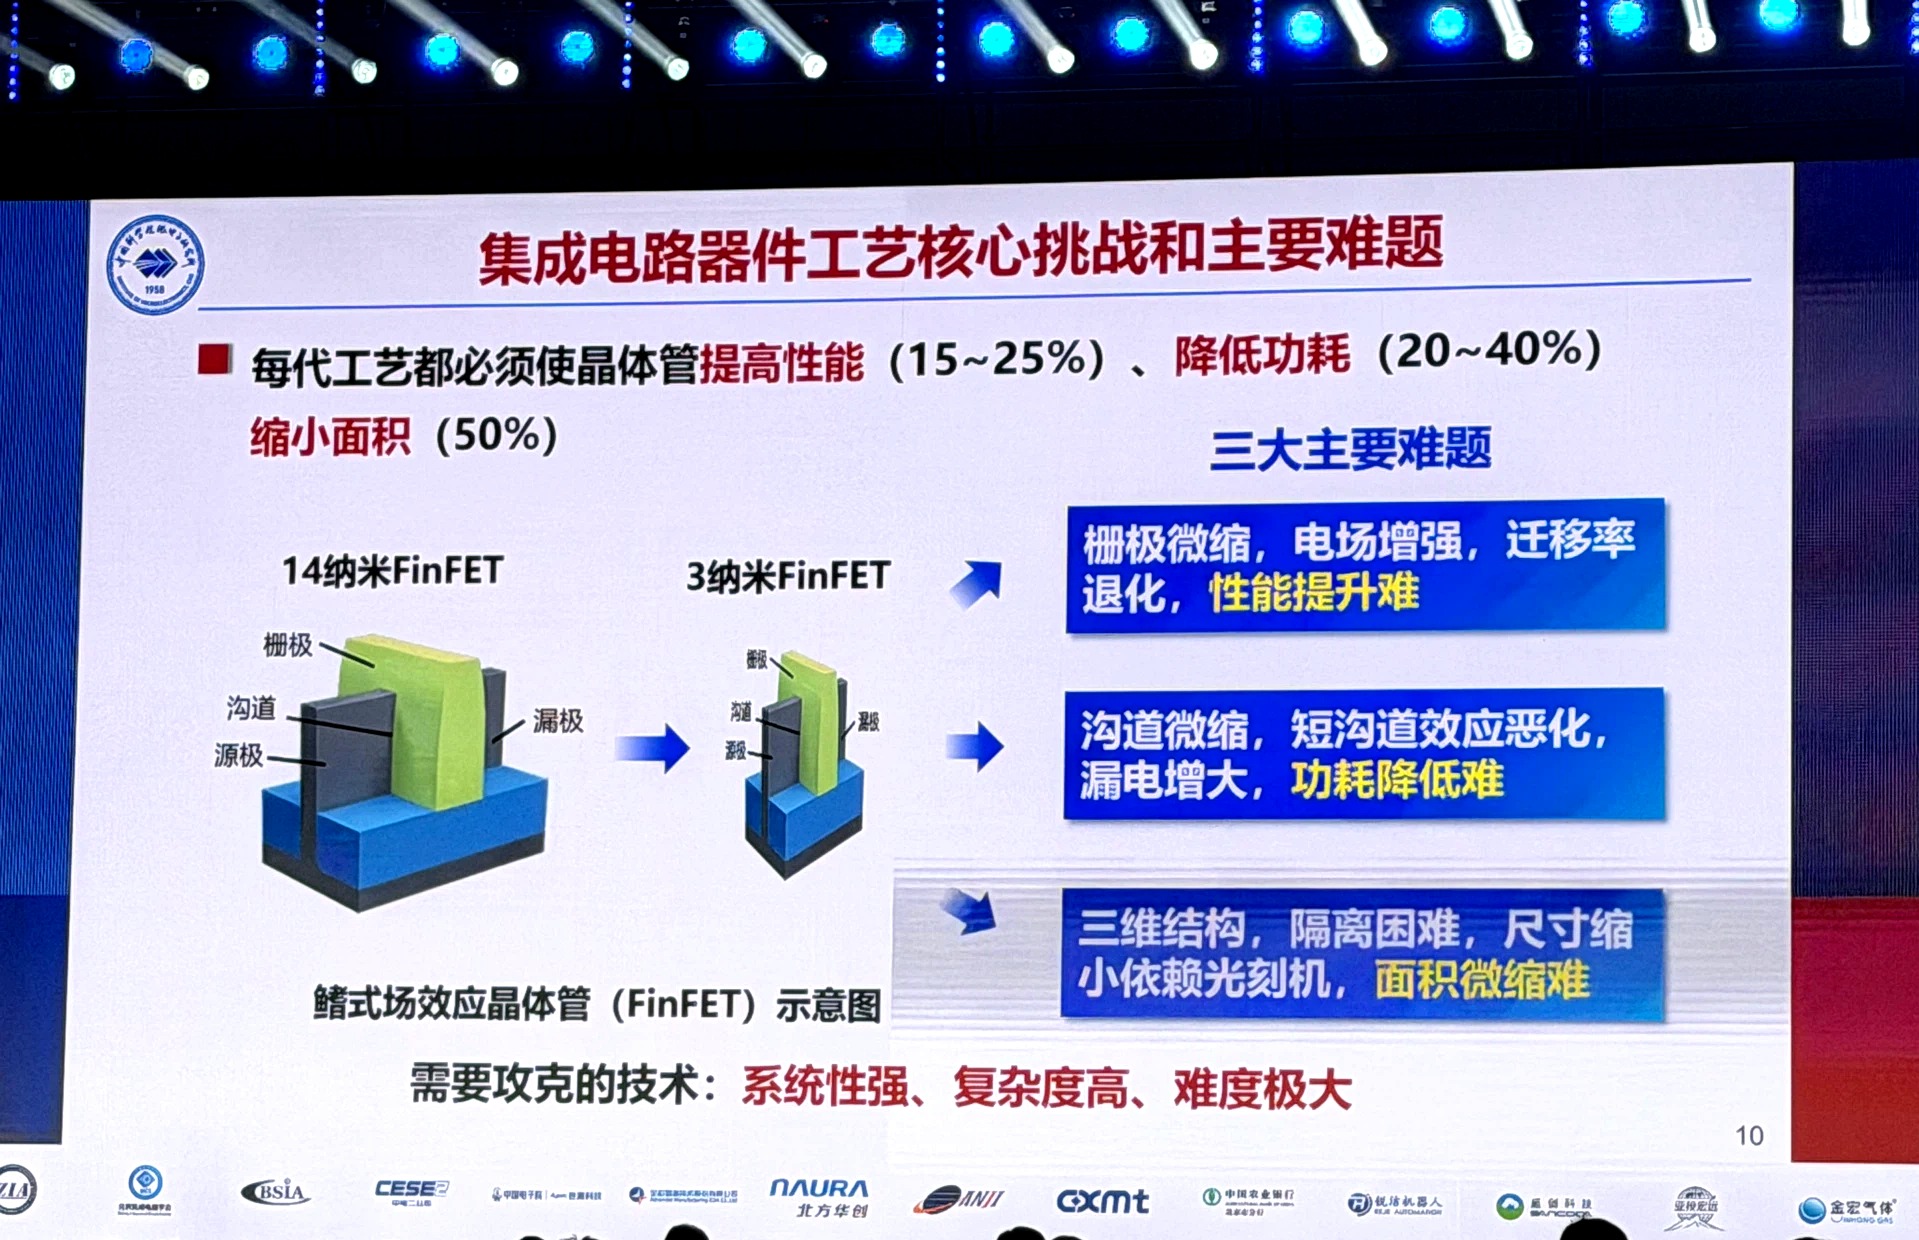
STCO放大
器件工艺 / STCO 专题
3D 时代的设计复杂性:器件微缩减速,系统协同提速
后摩尔设计方法论从 DTCO 走向 STCO。
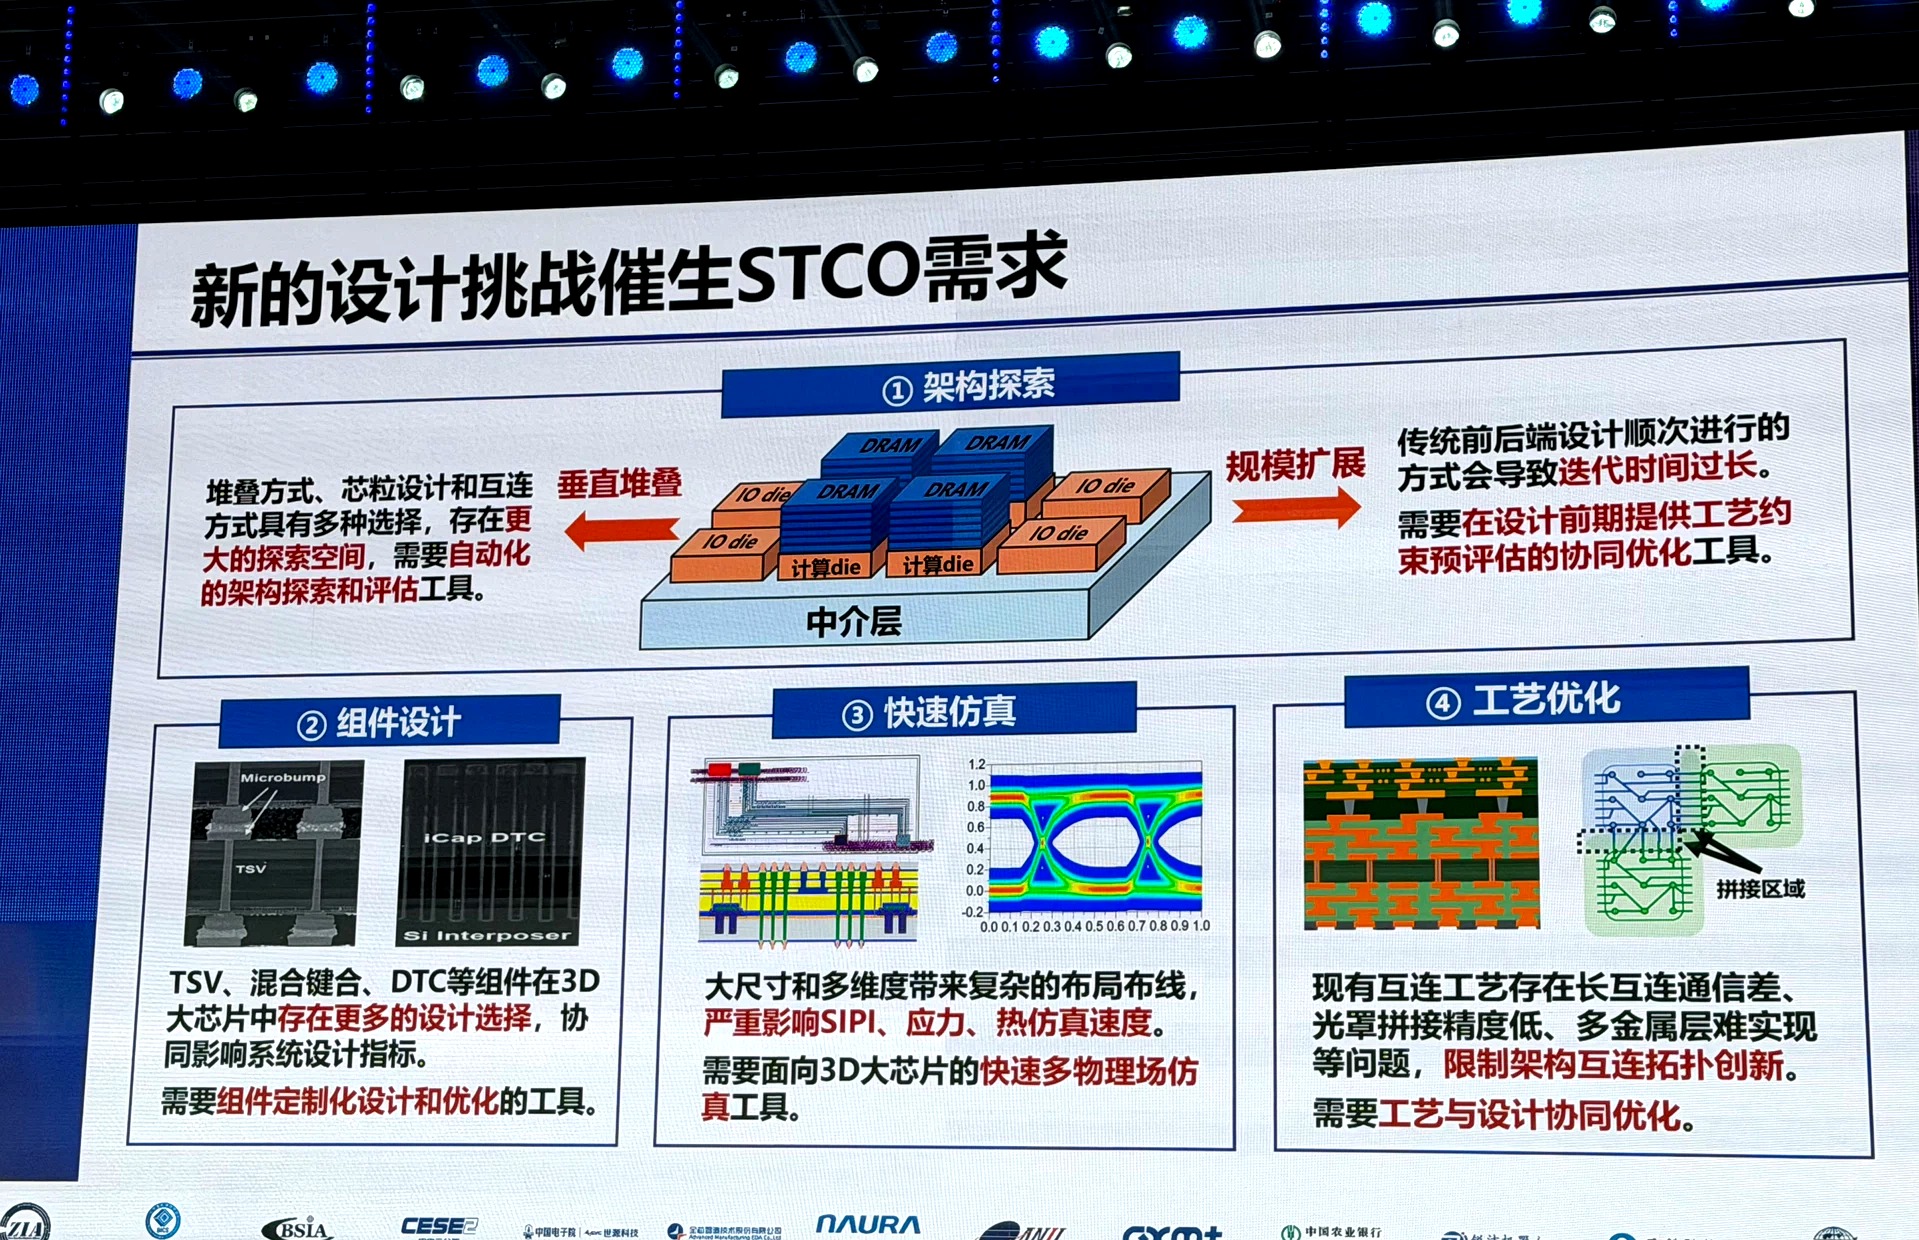
3D设计工具放大
STCO 专题
五大设计工具需求
SI/PI/应力/热仿真成为 3D 大芯片刚需。
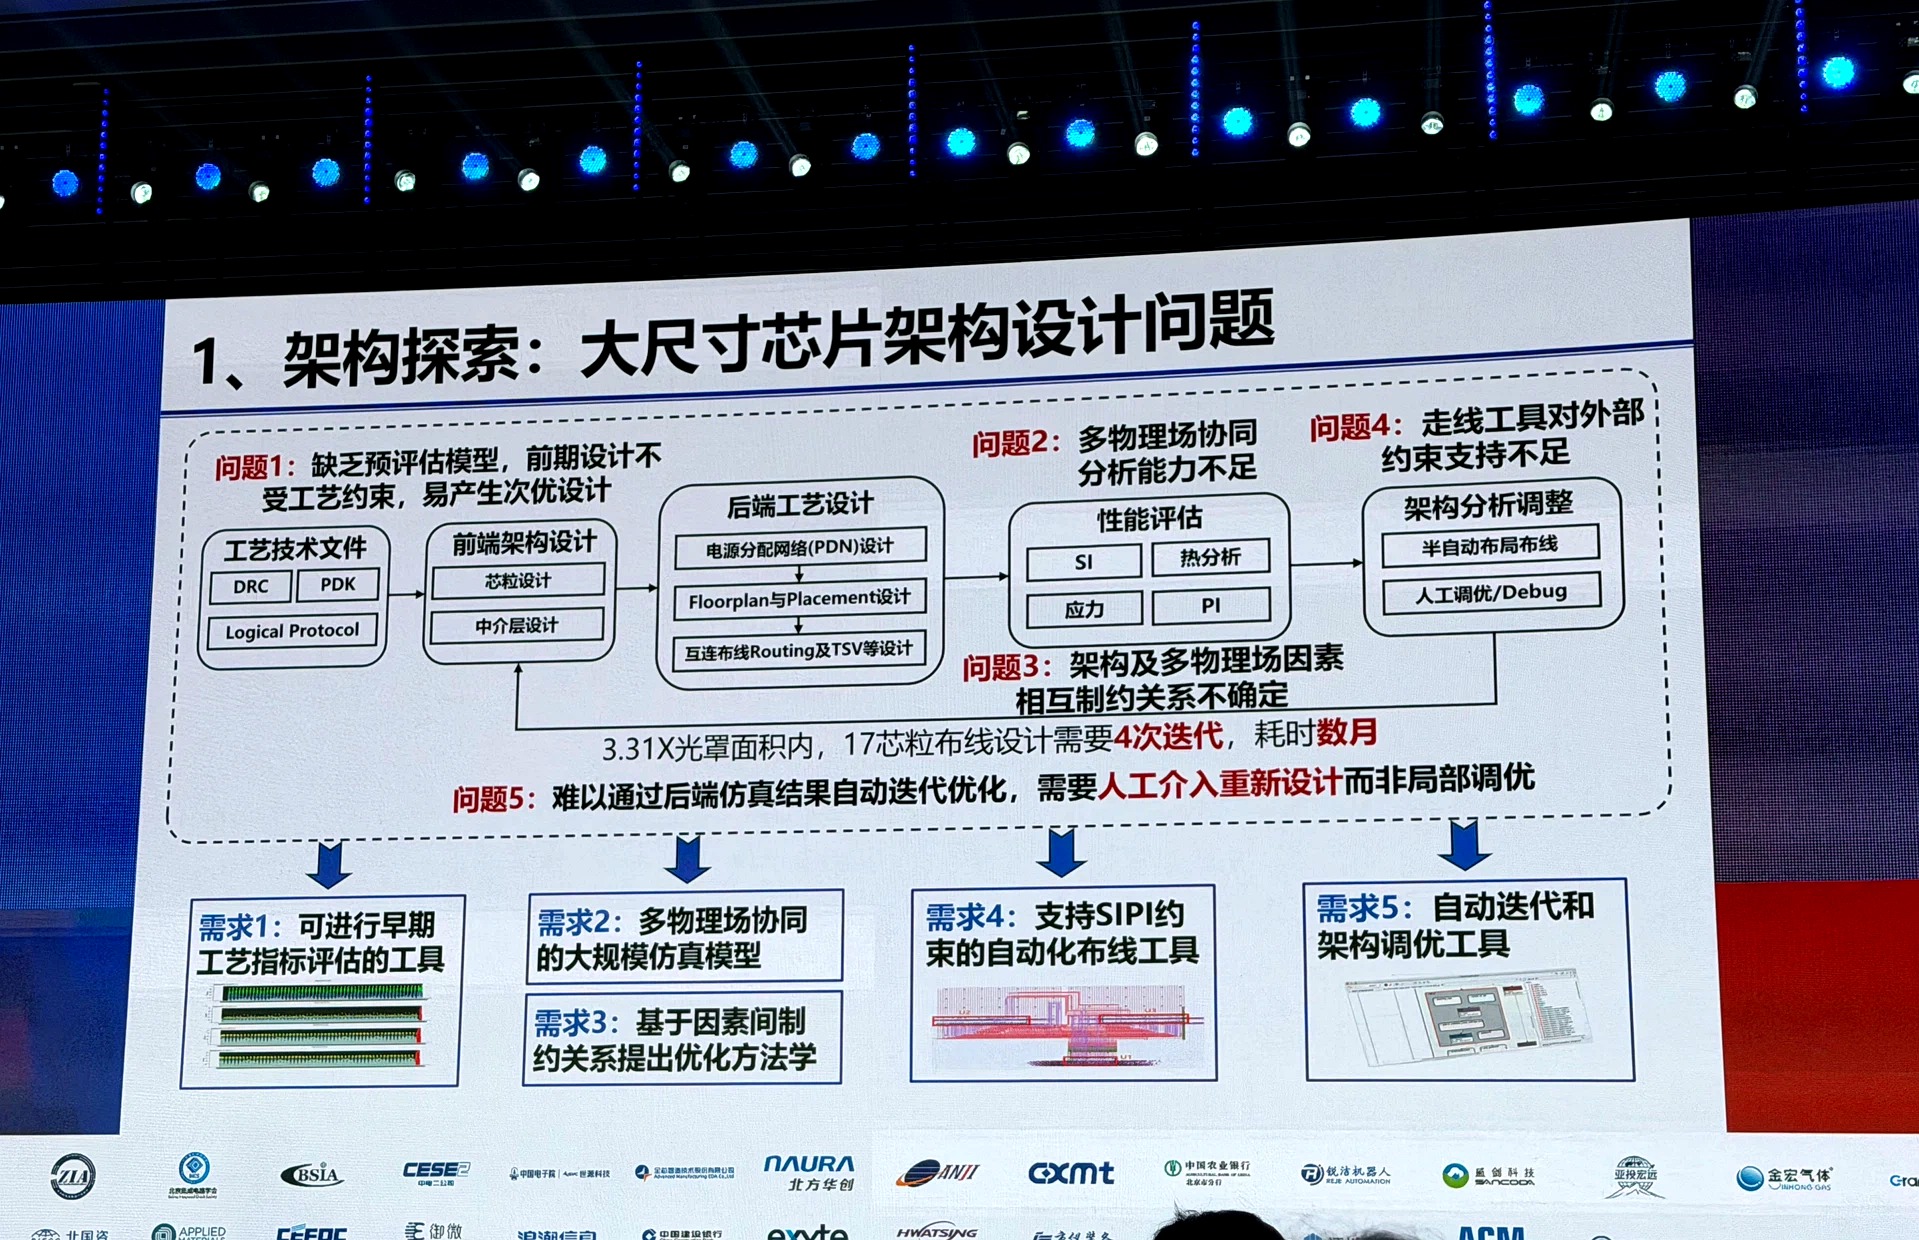
17芯粒放大
STCO 专题
3.31× 光罩 · 17 芯粒
超大集成的设计成本实证。
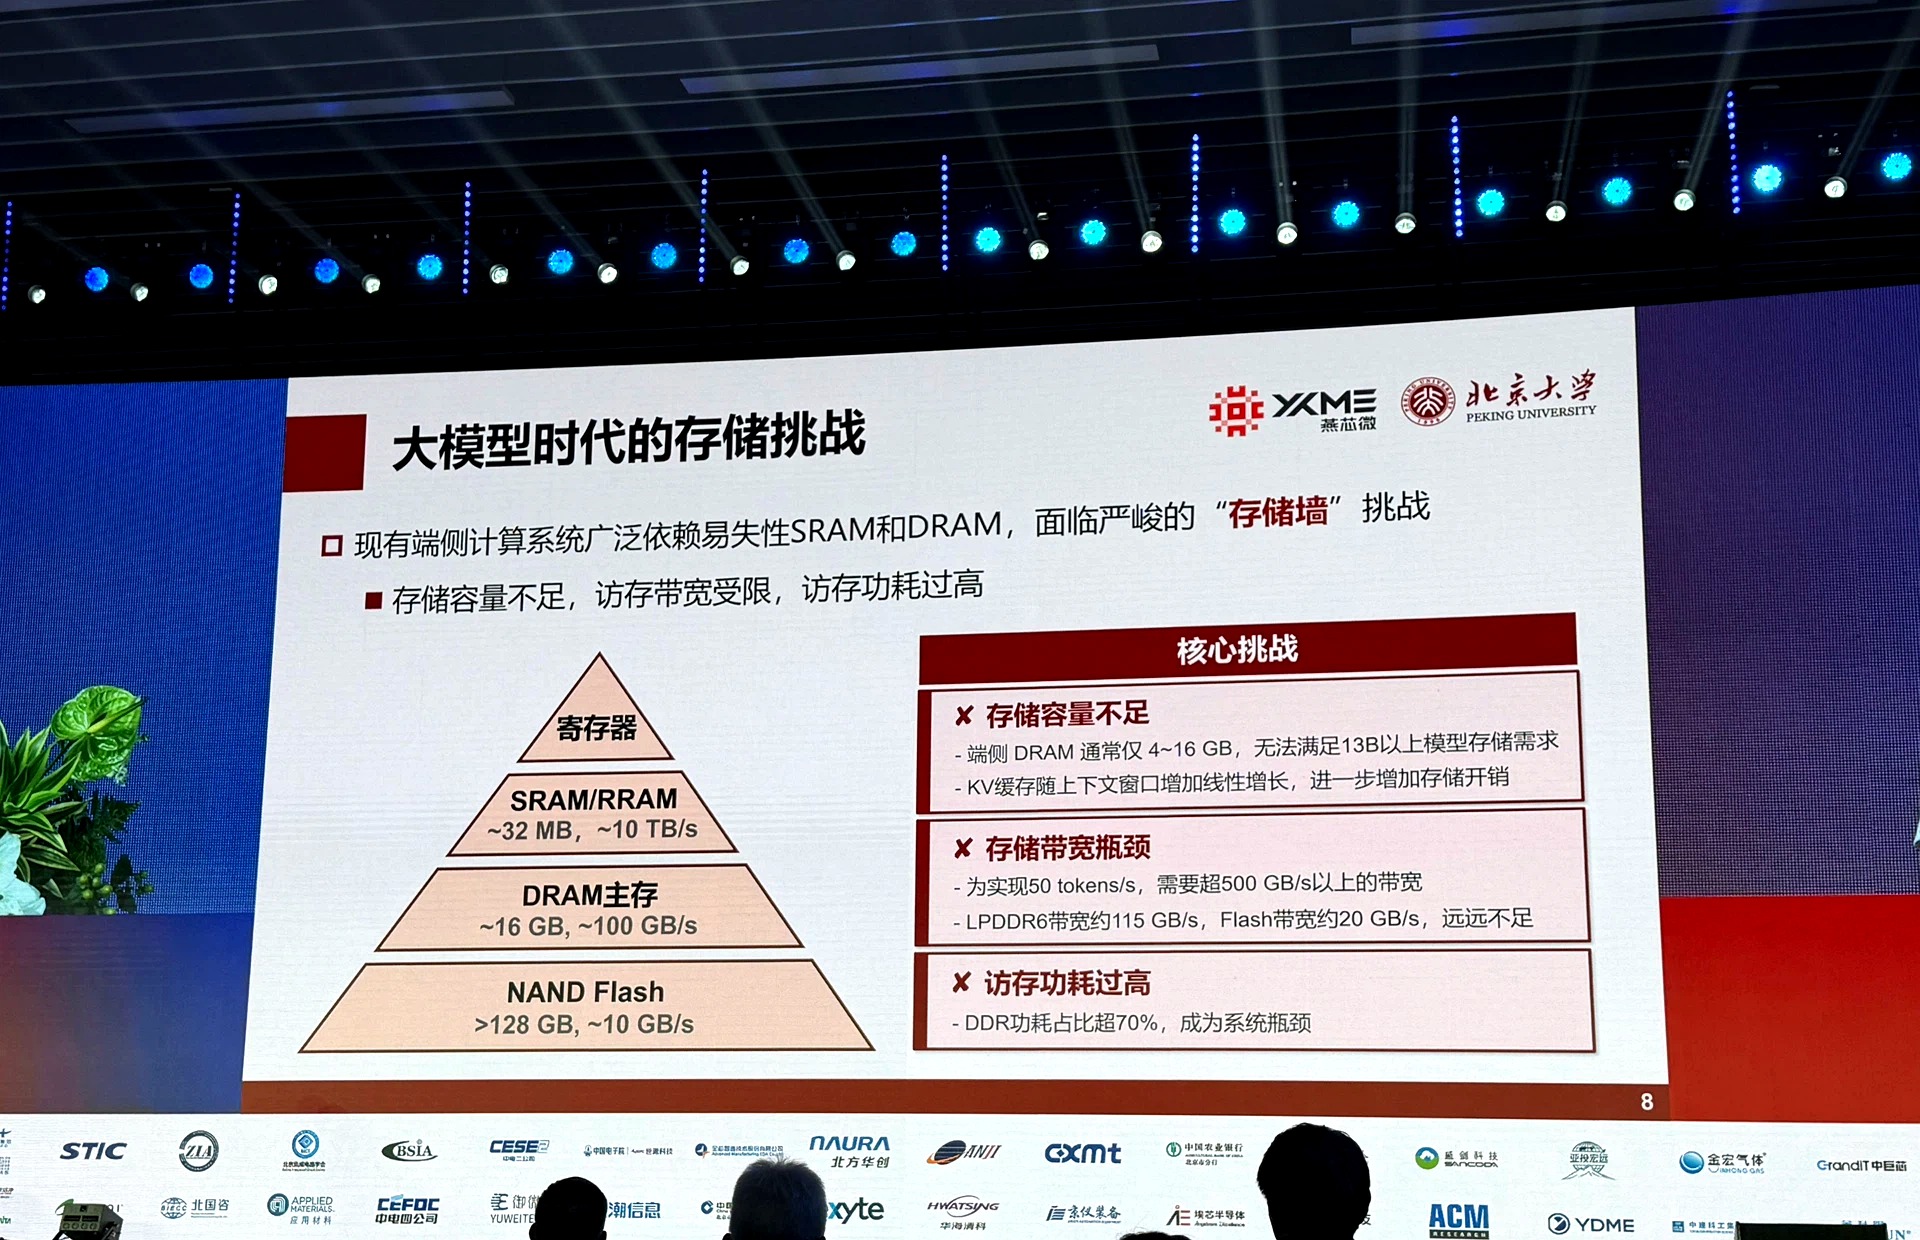
存储墙放大
燕芯微 × 北京大学
大模型时代的存储挑战:容量 · 带宽 · 功耗三重缺口
50 tokens/s 需 >500GB/s,LPDDR6 仅 ~115GB/s——量化缺口给出存算路线必要性。
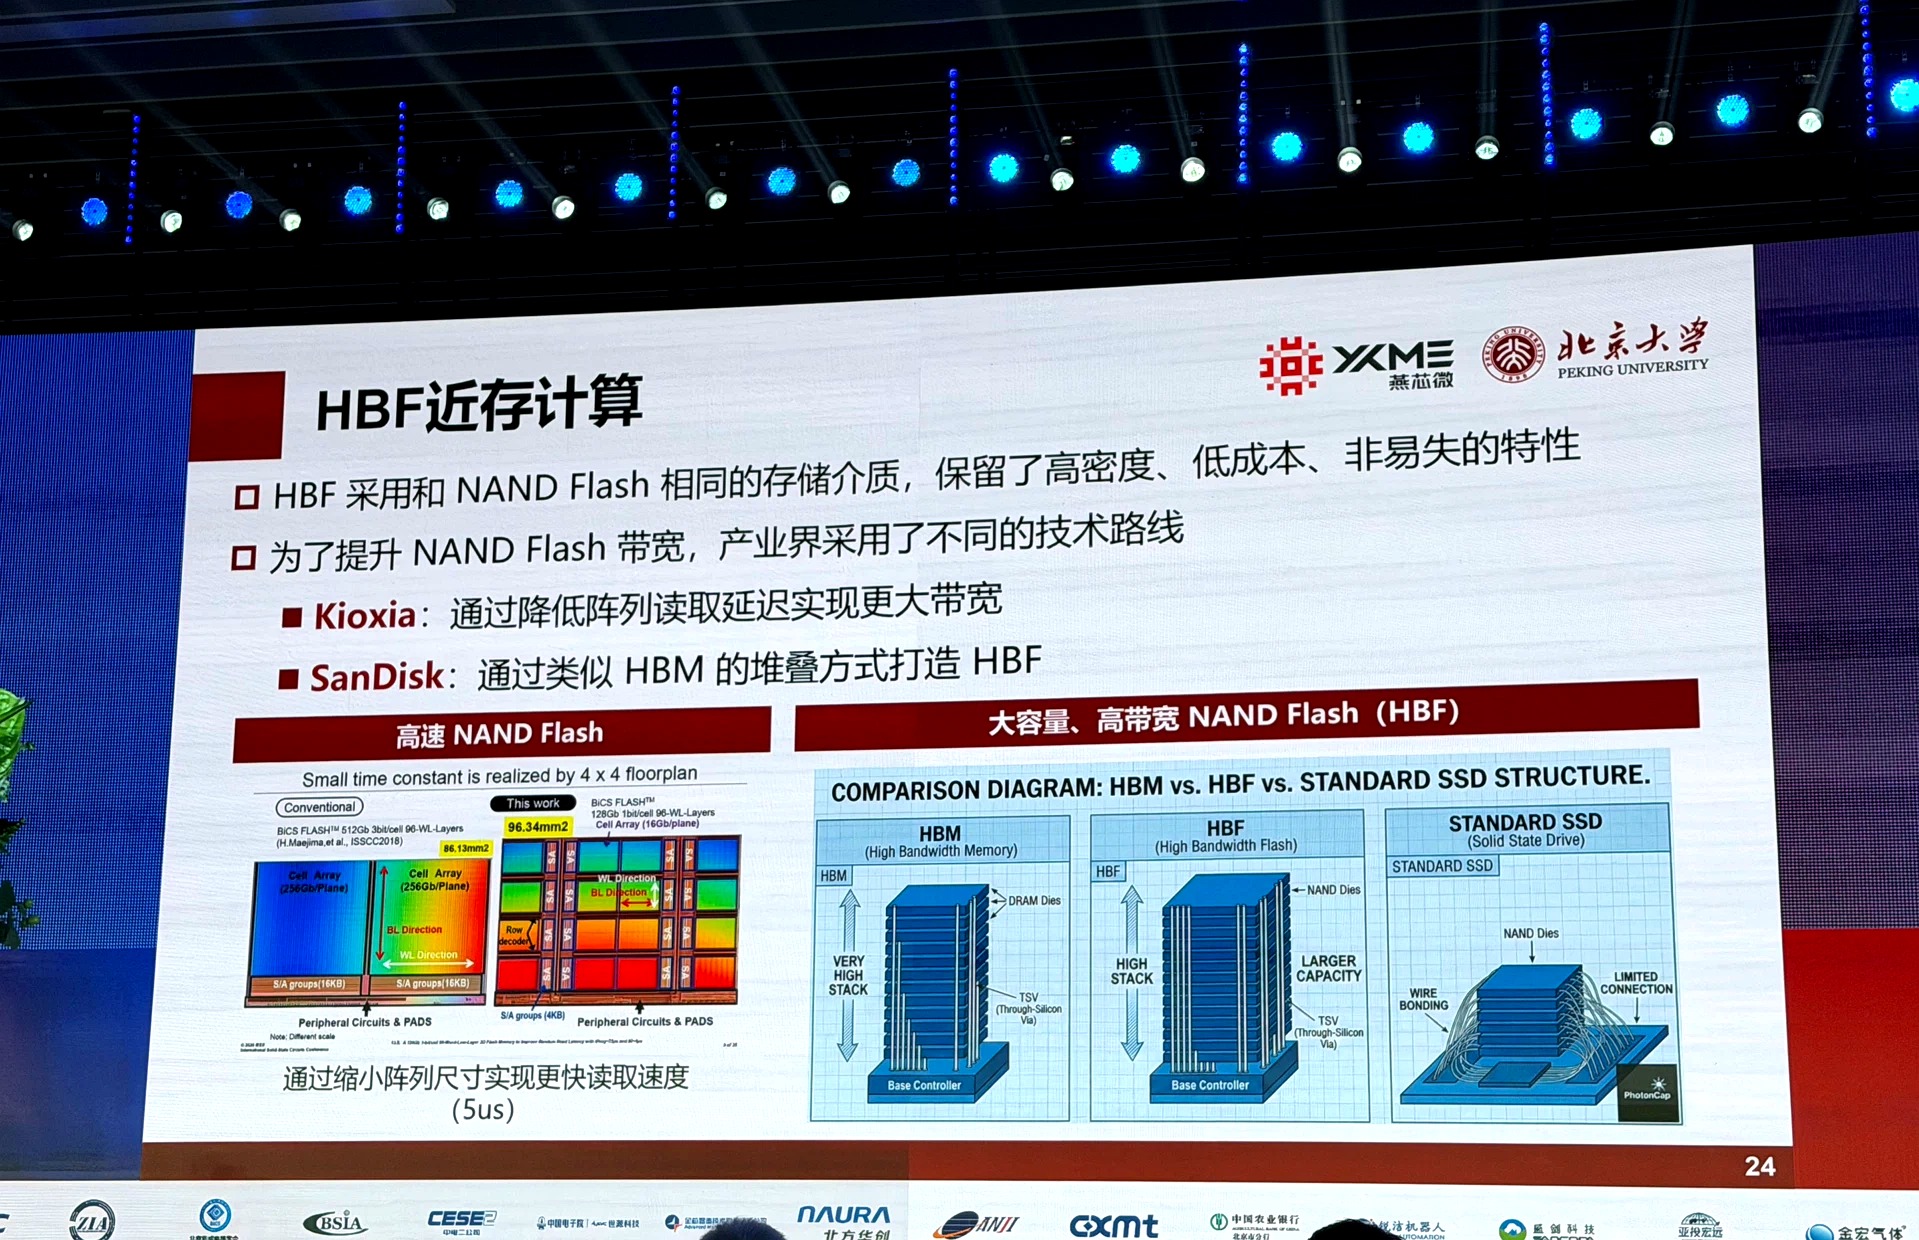
HBF放大
FMS 2026 HBF 标准发布
HBF:填补 HBM 与 SSD 之间的空白
「图书馆与书房」:HBM 保带宽、HBF 扩容量;开放标准为国产厂商绕开 HBM 专利提供窗口。
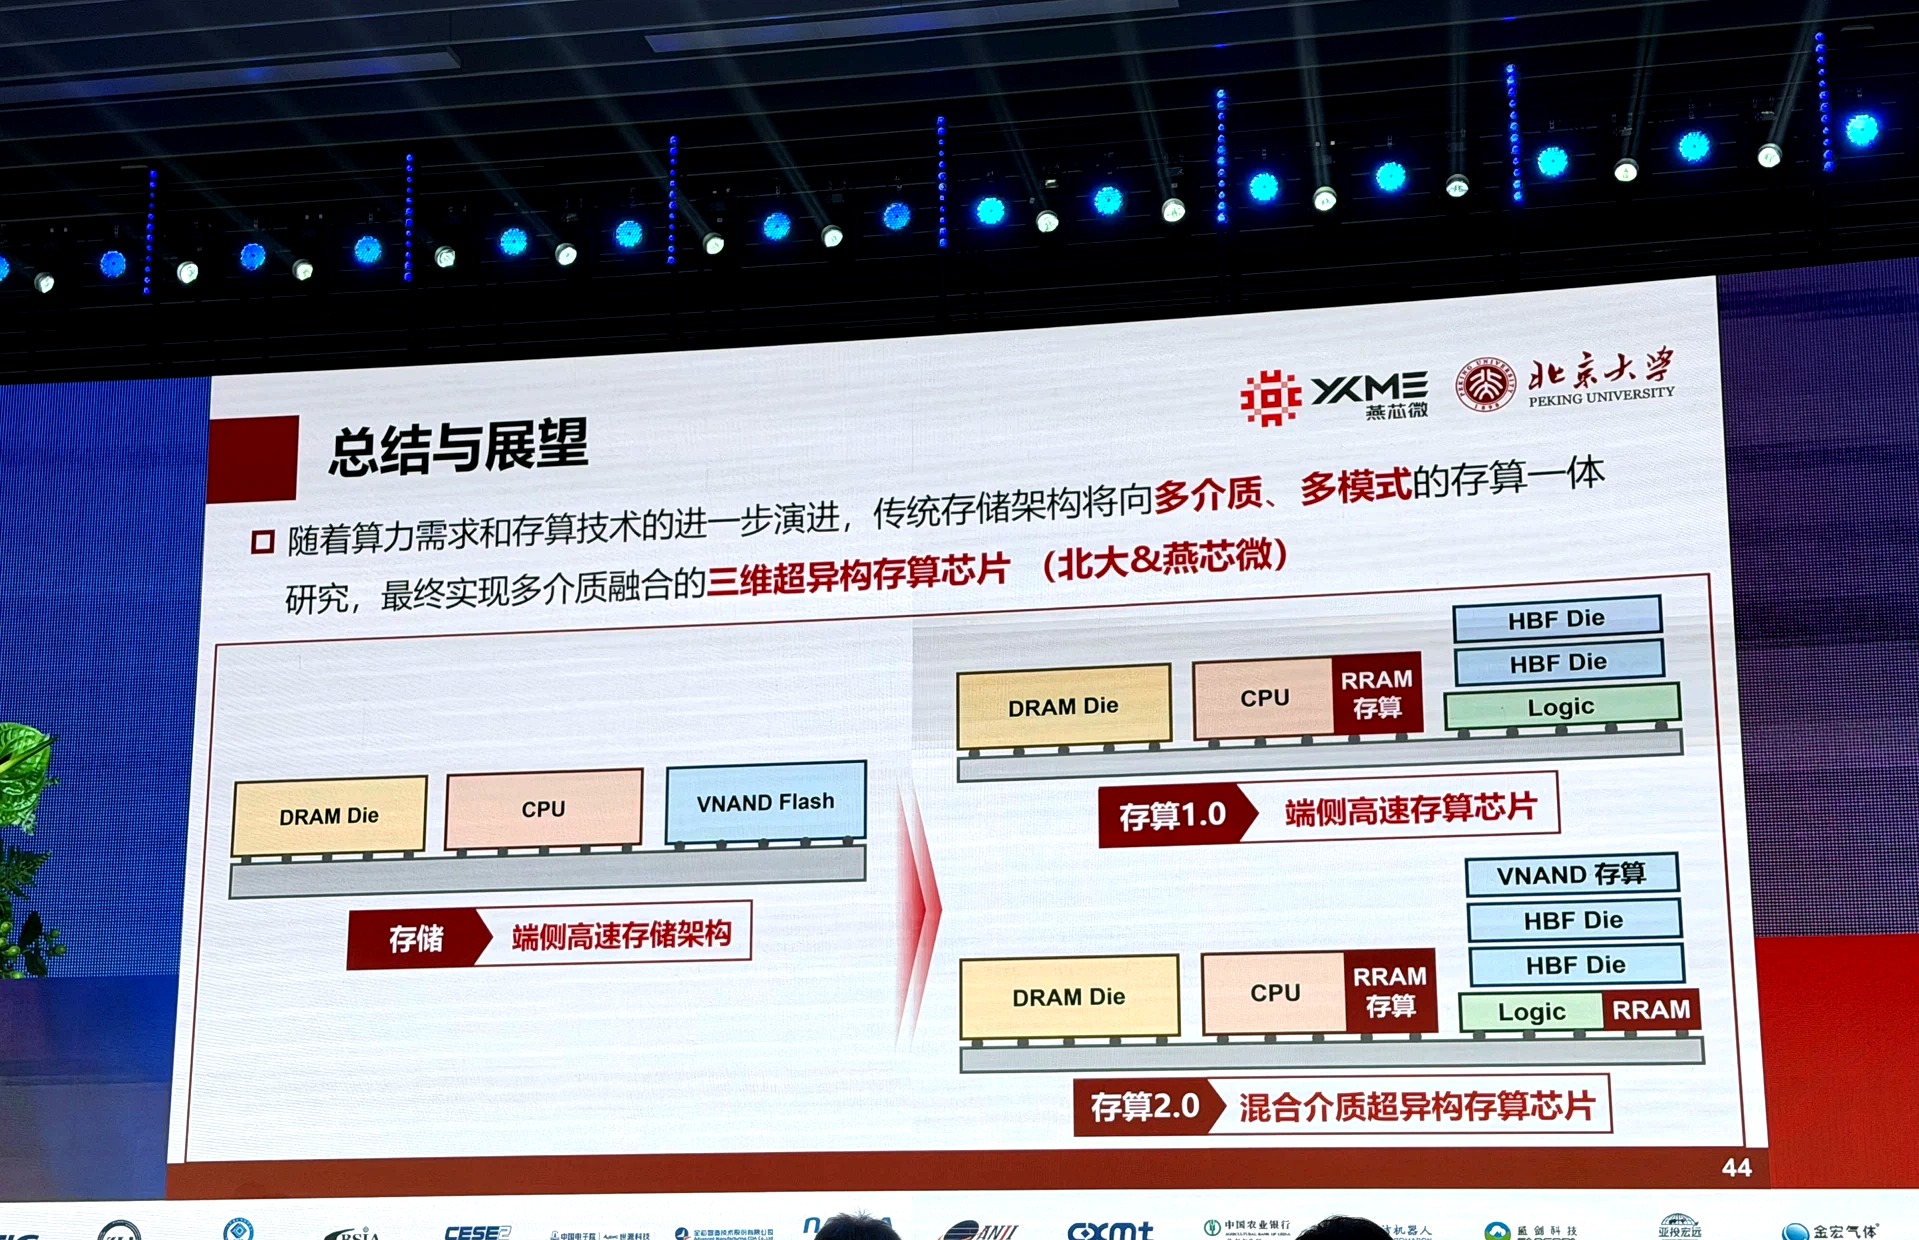
存算2.0放大
北大 / 燕芯微
存算 1.0 → 存算 2.0
混合介质三维超异构存算芯片。
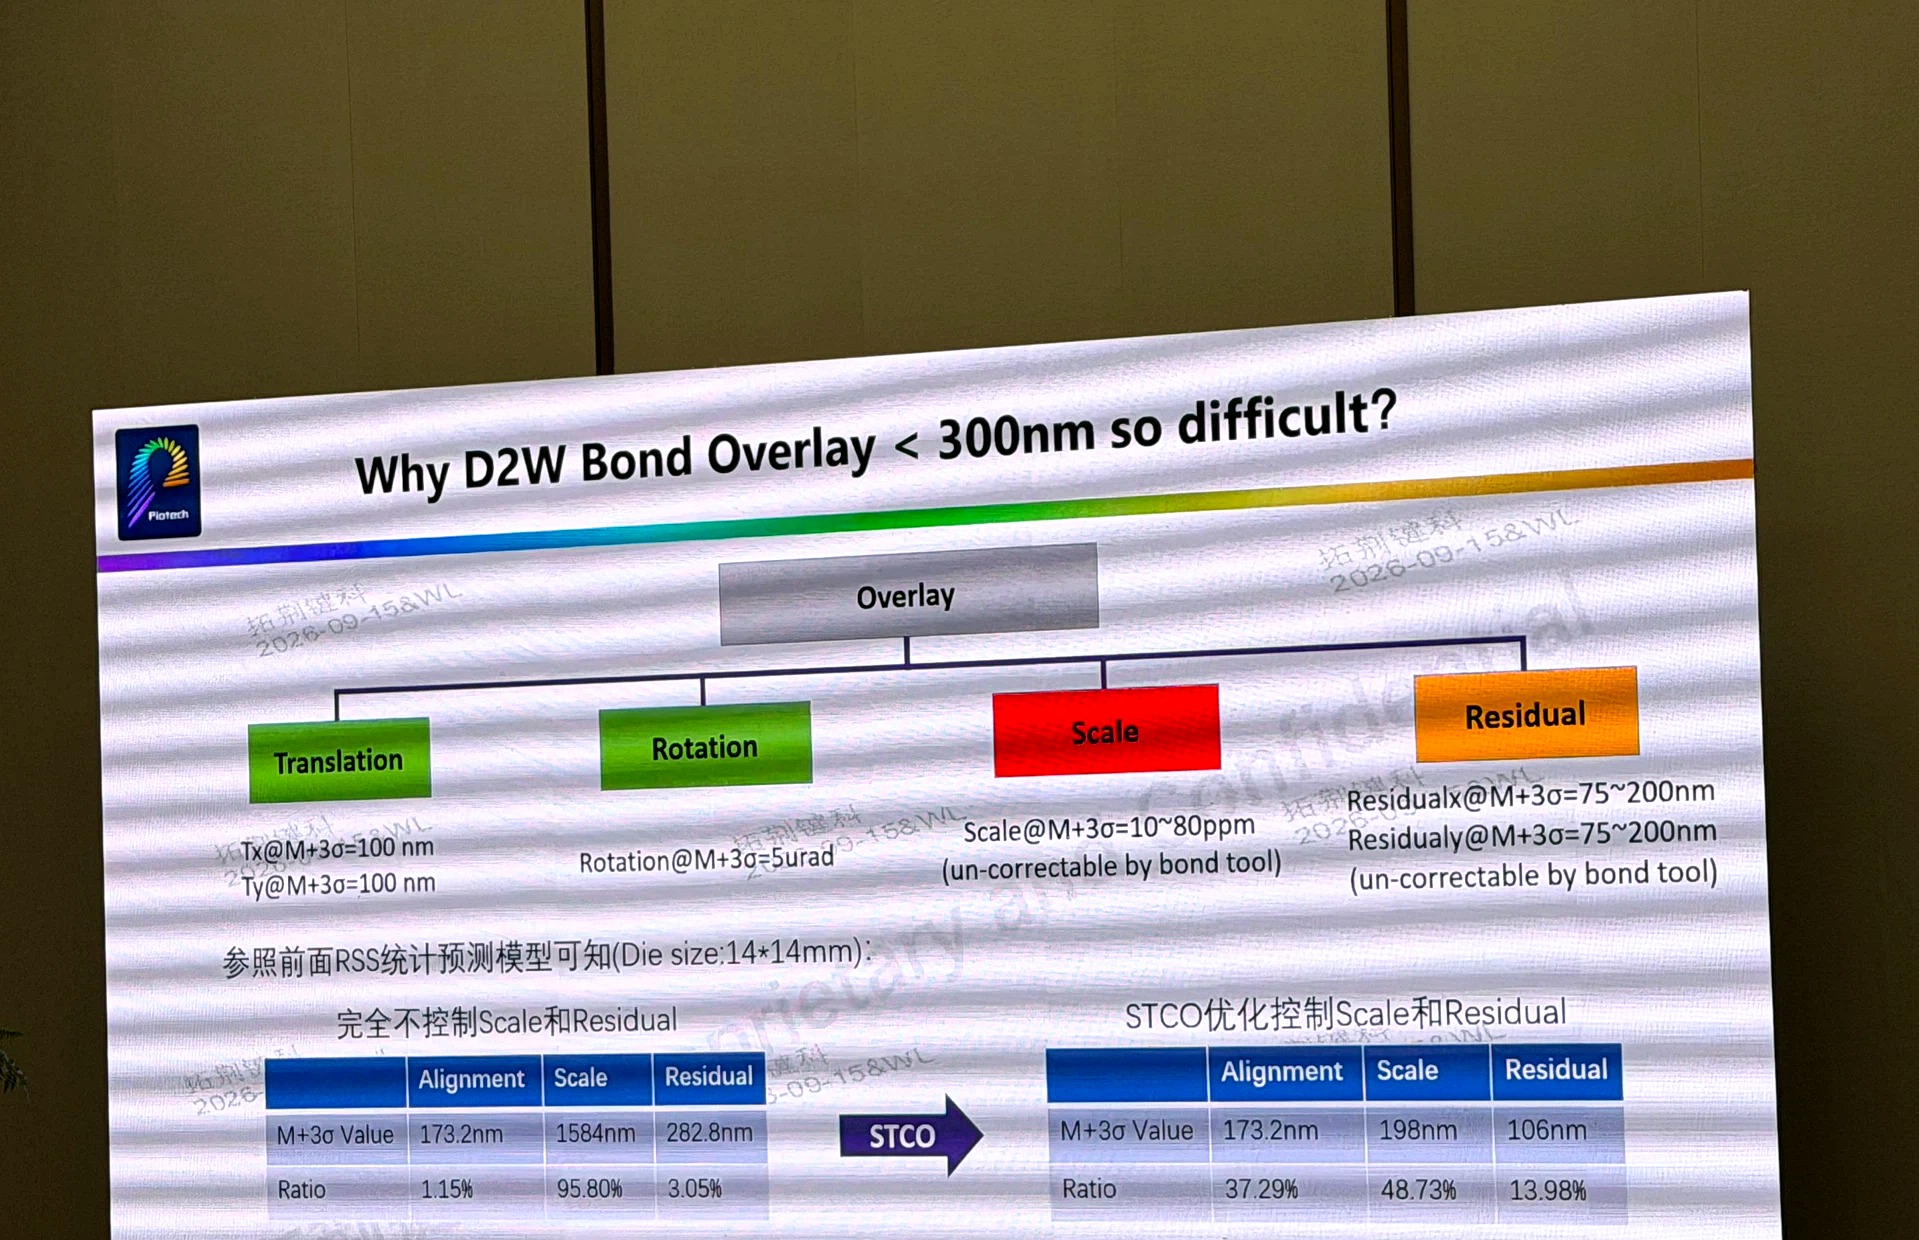
D2W套刻放大
拓荆键科
D2W 套刻 <300nm 难在哪:误差四分解
Scale 误差占 95.8% 且机台不可校正——必须 STCO 协同(1635→283nm)。
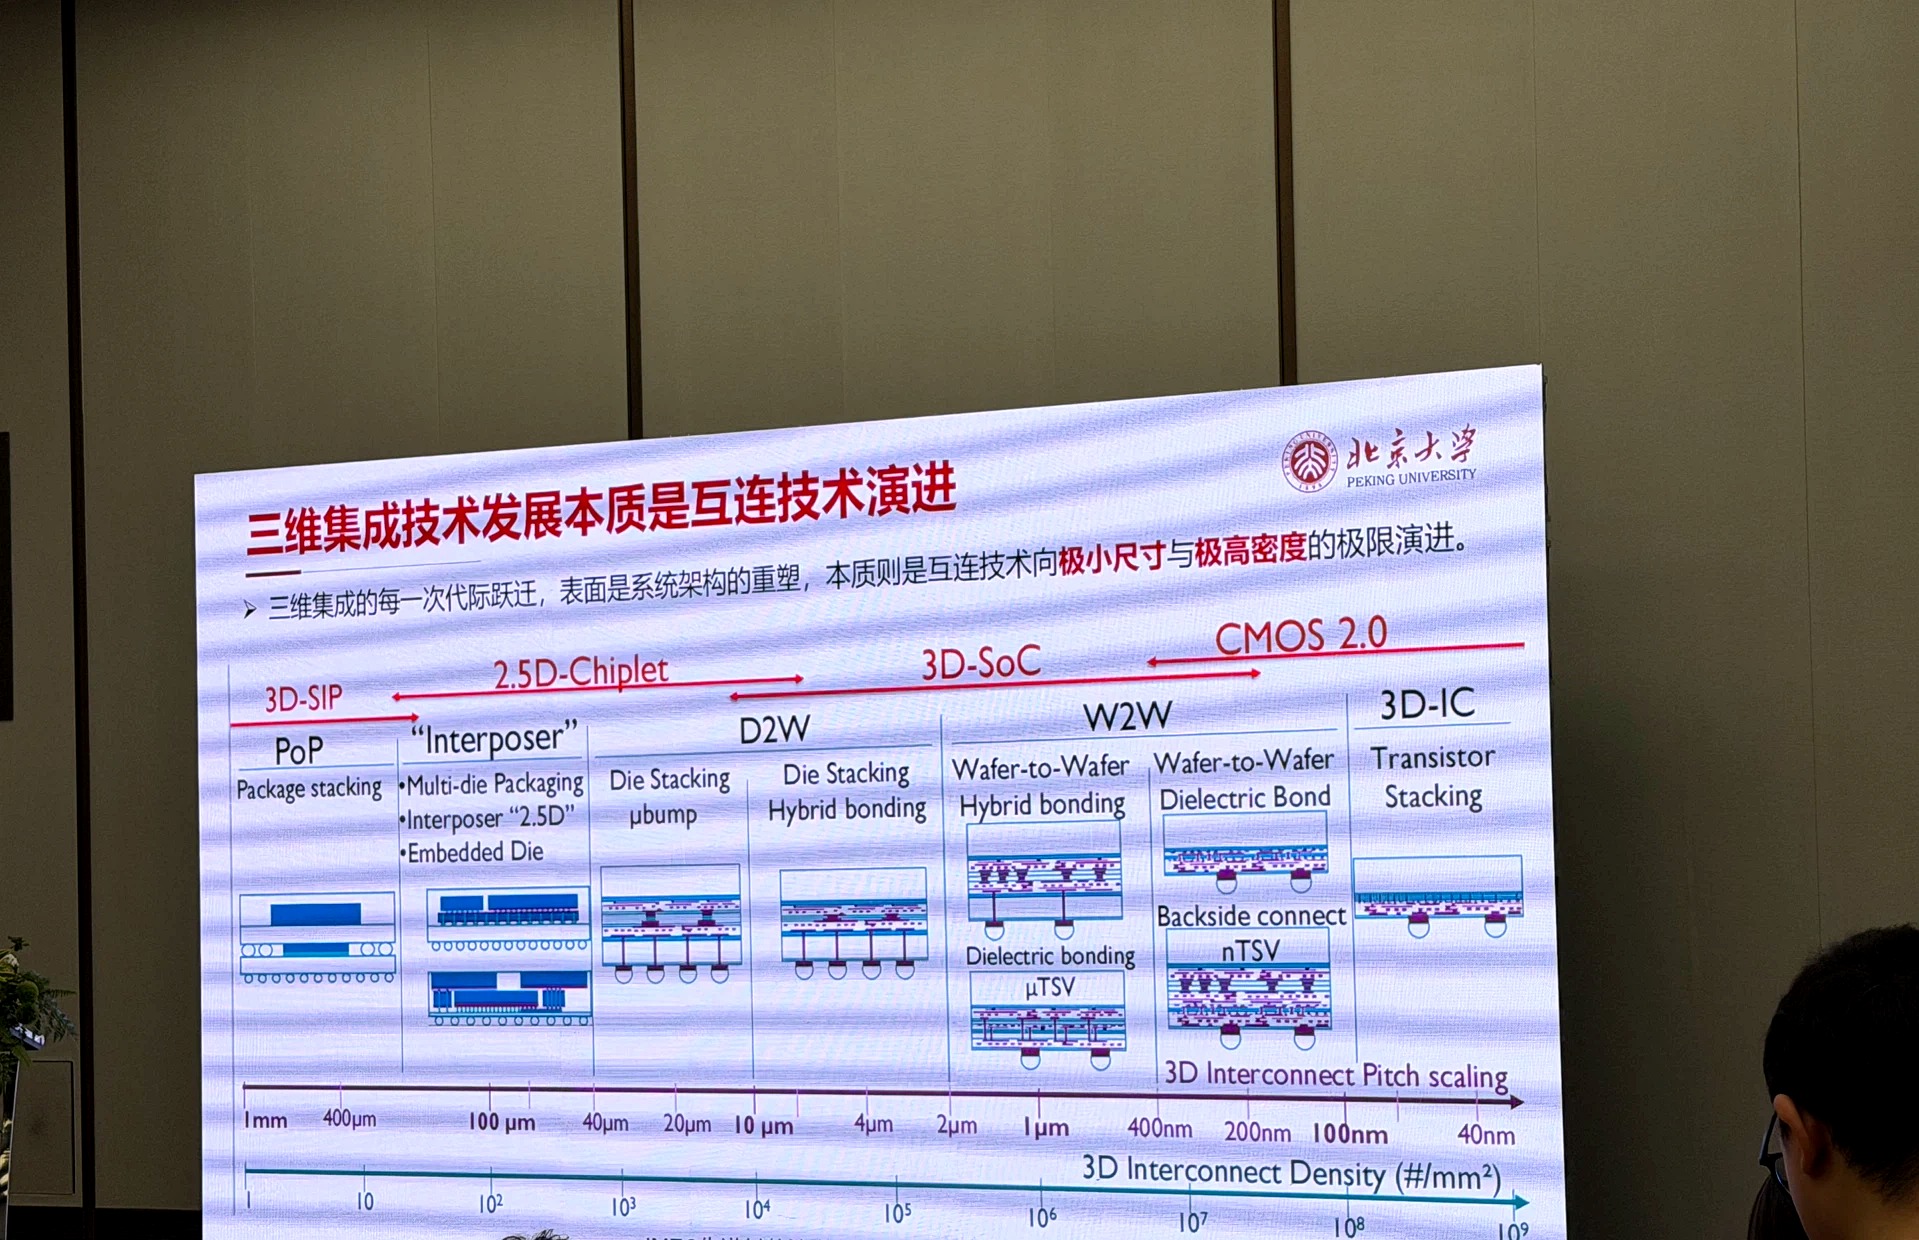
互连演进放大
拓荆键科 / 北京大学
互连密度 9 个数量级
三维集成的本质是互连演进。
6.4 AI FAB 与 AI EDA
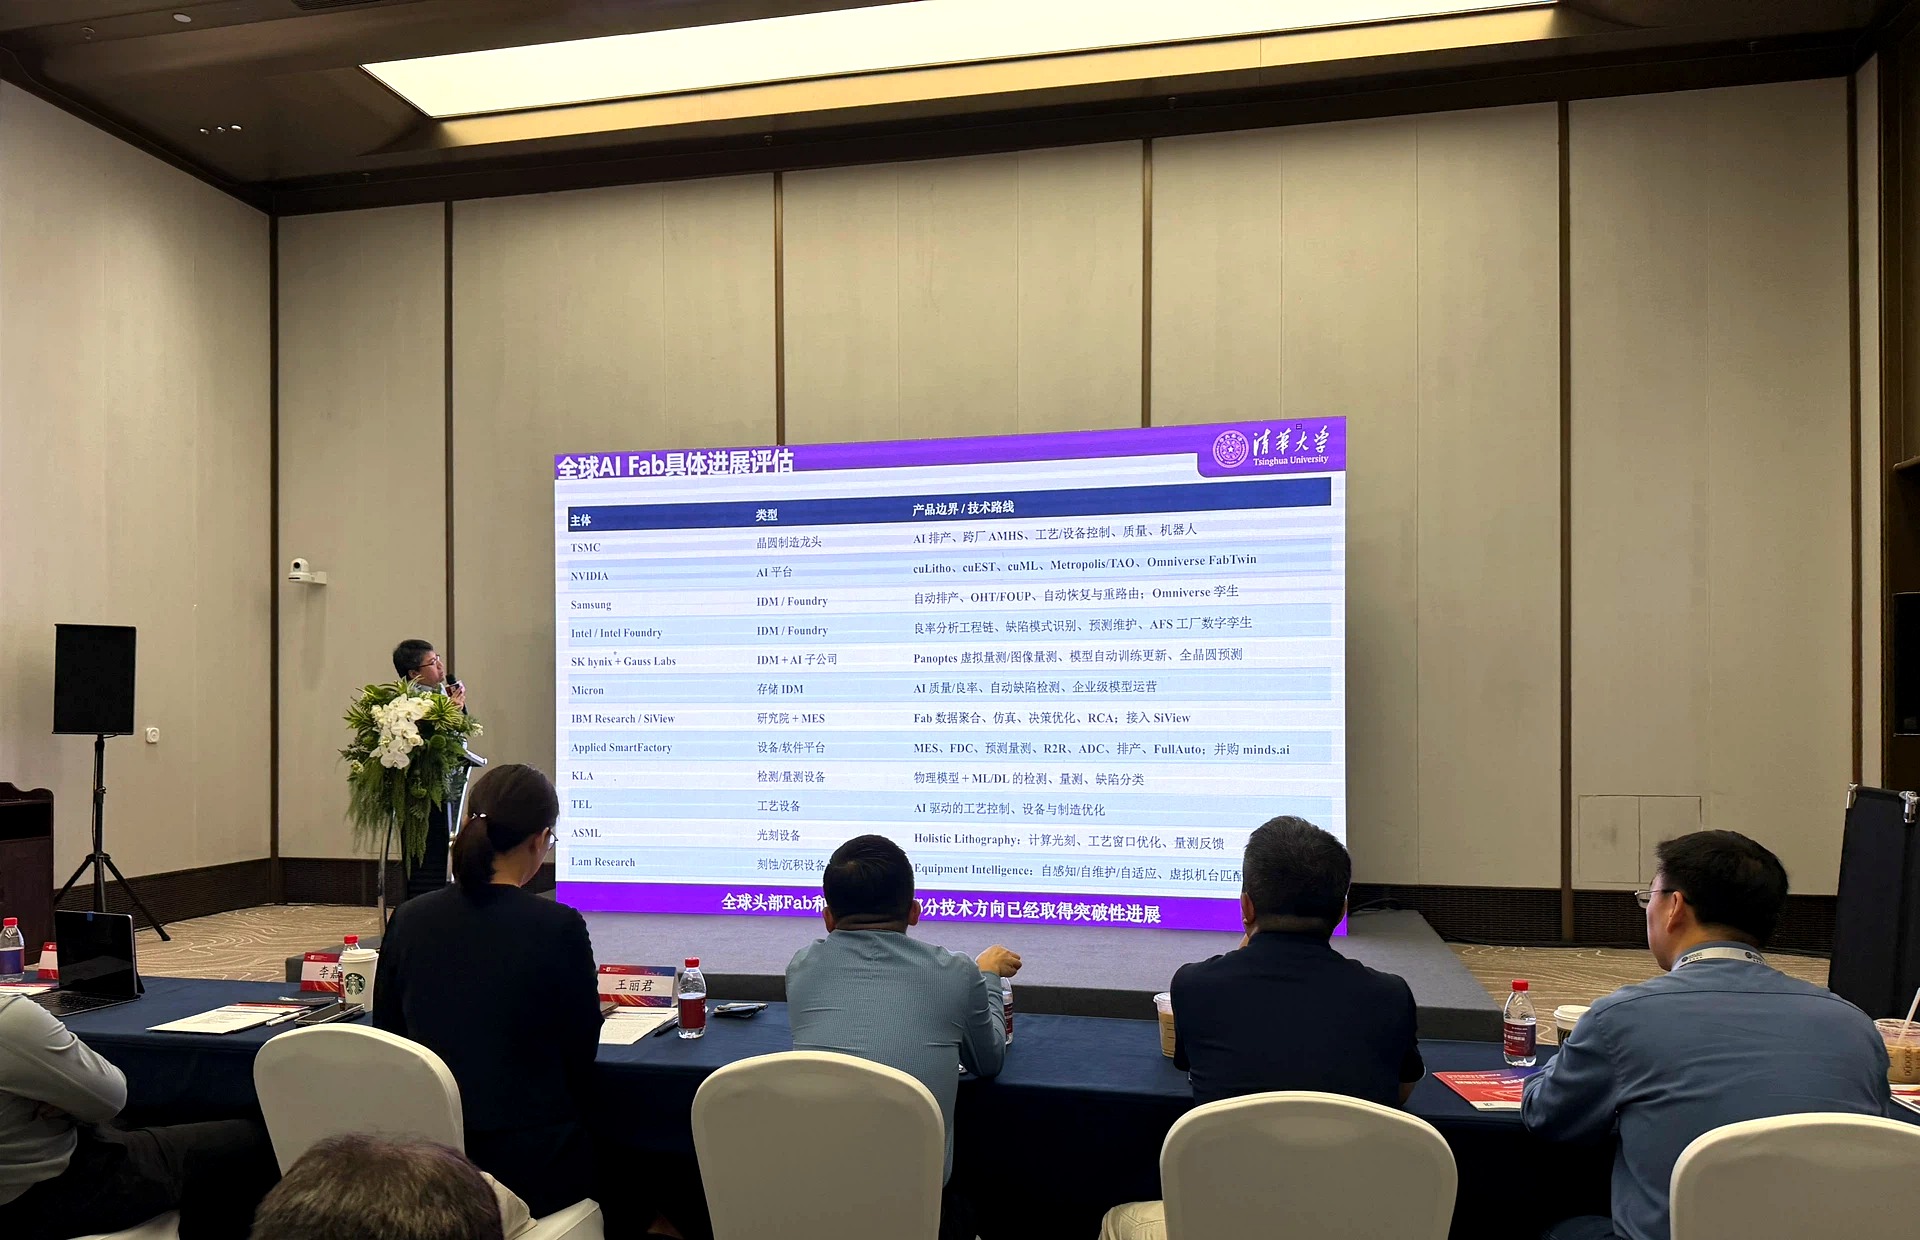
AI Fab全景放大
清华大学
AI 深入 Fab 全流程
国际大厂普遍采用,部分场景已授予 AI 实际决策权。
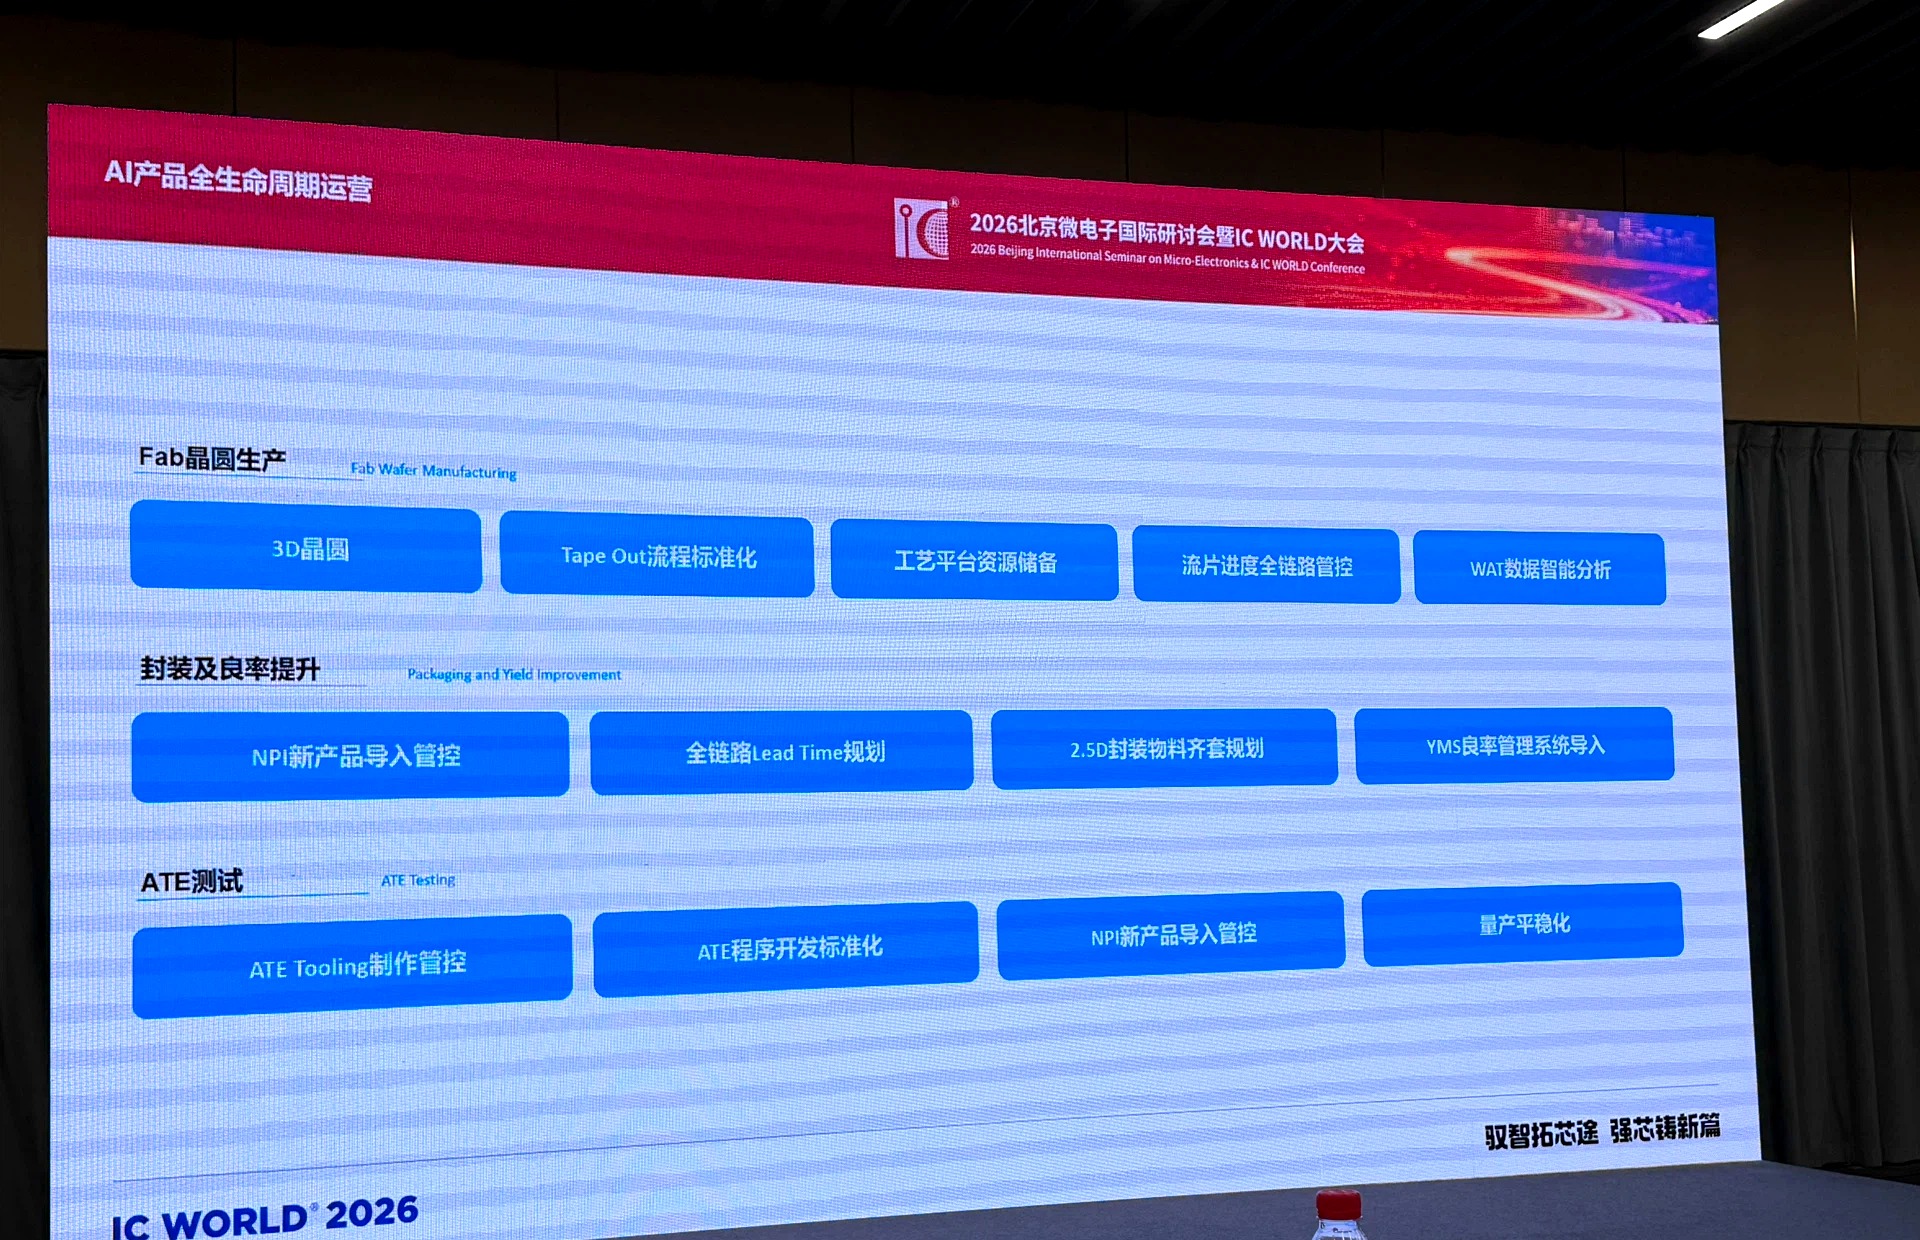
AI全生命周期放大
清华大学
AI 产品全生命周期运营
晶圆 → 封装 → 测试的 AI 闭环。
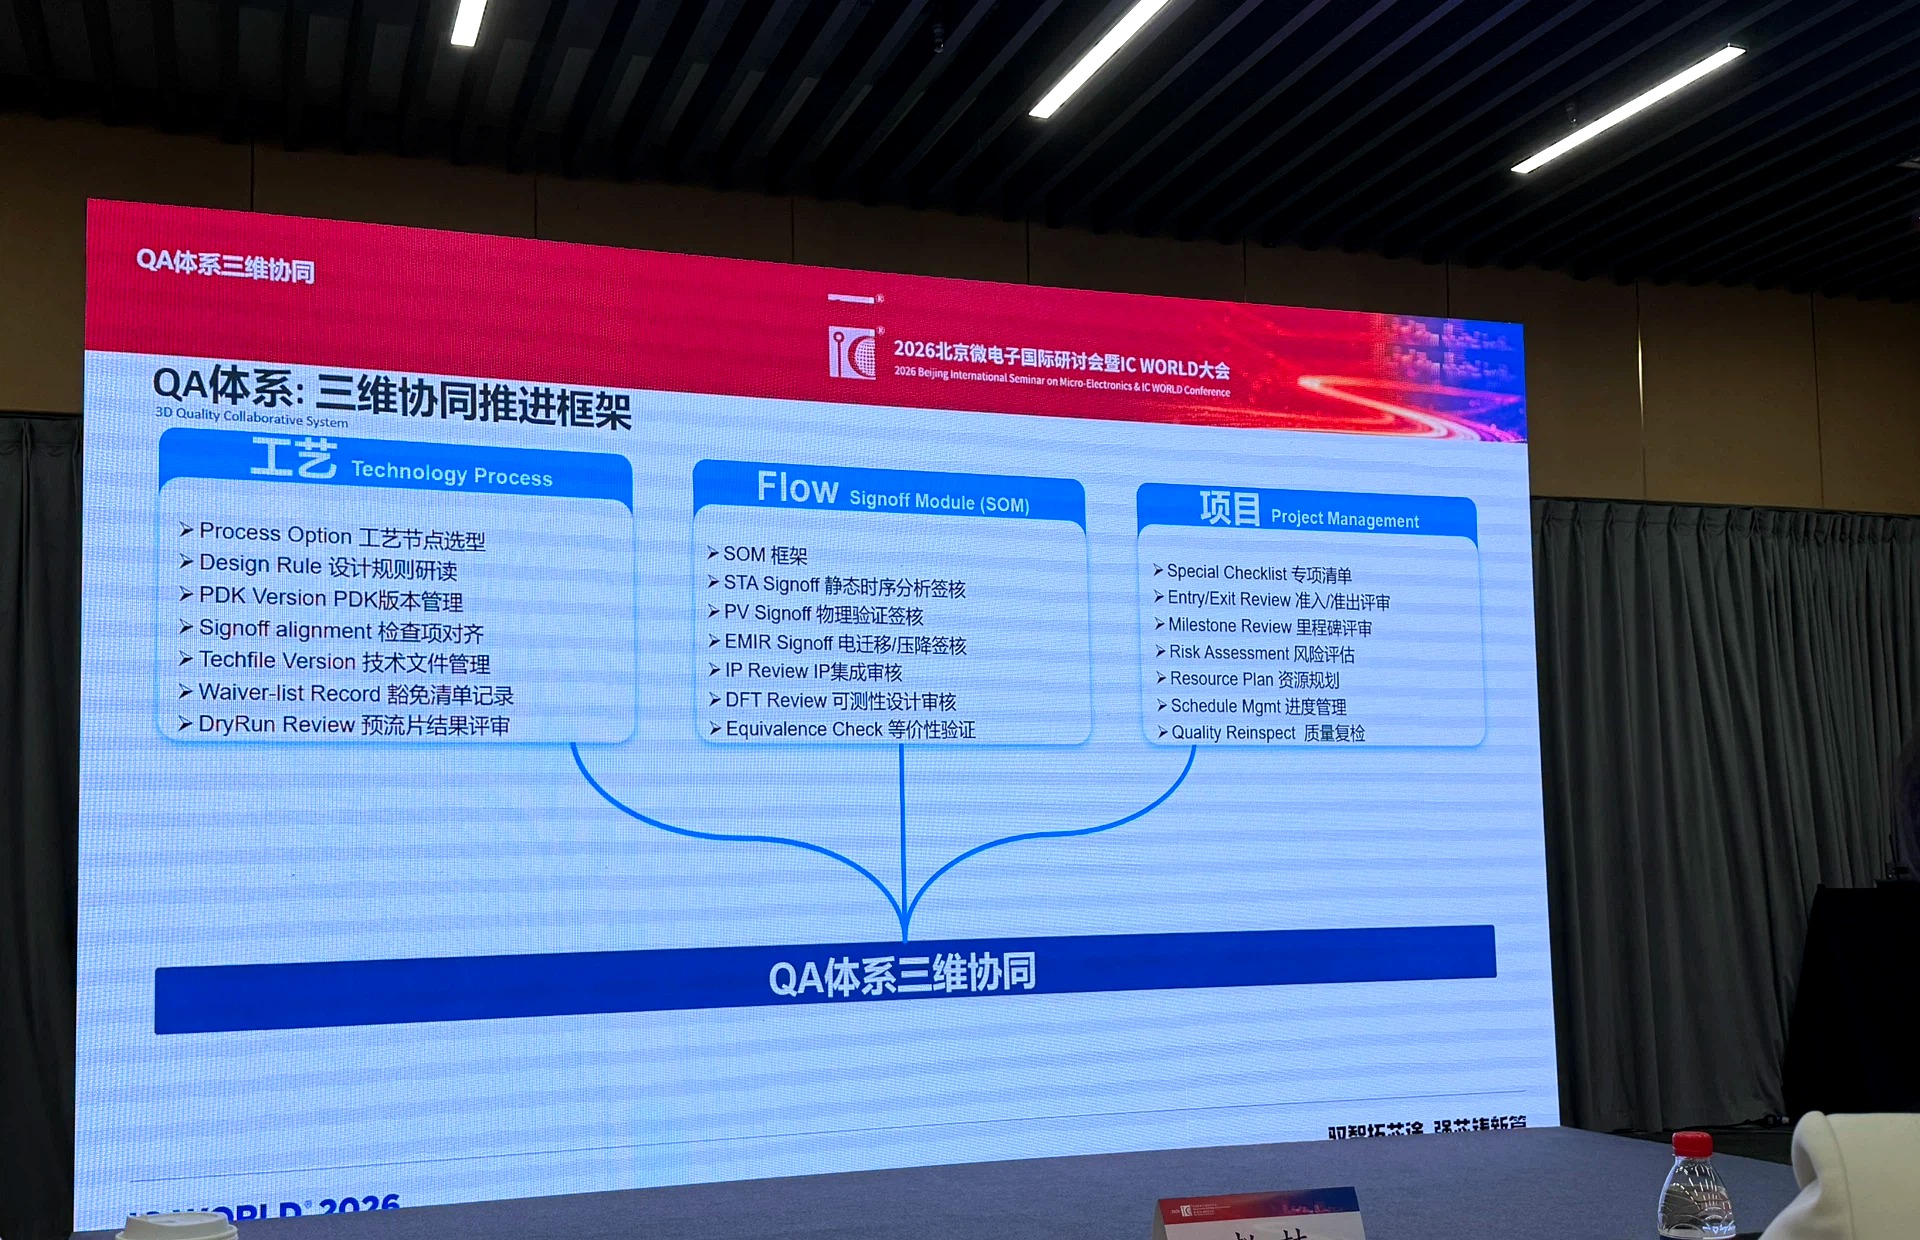
QA三维协同放大
北方华创等
QA 体系三维协同
国产装备智能化体系化实践。
AI EDA放大
大会 EDA 专题
AI × EDA 八厂商实效:全流程数量级跃升
国际三巨头 + 国产四家的实绩矩阵——效率证据从单点案例变为行业常态。
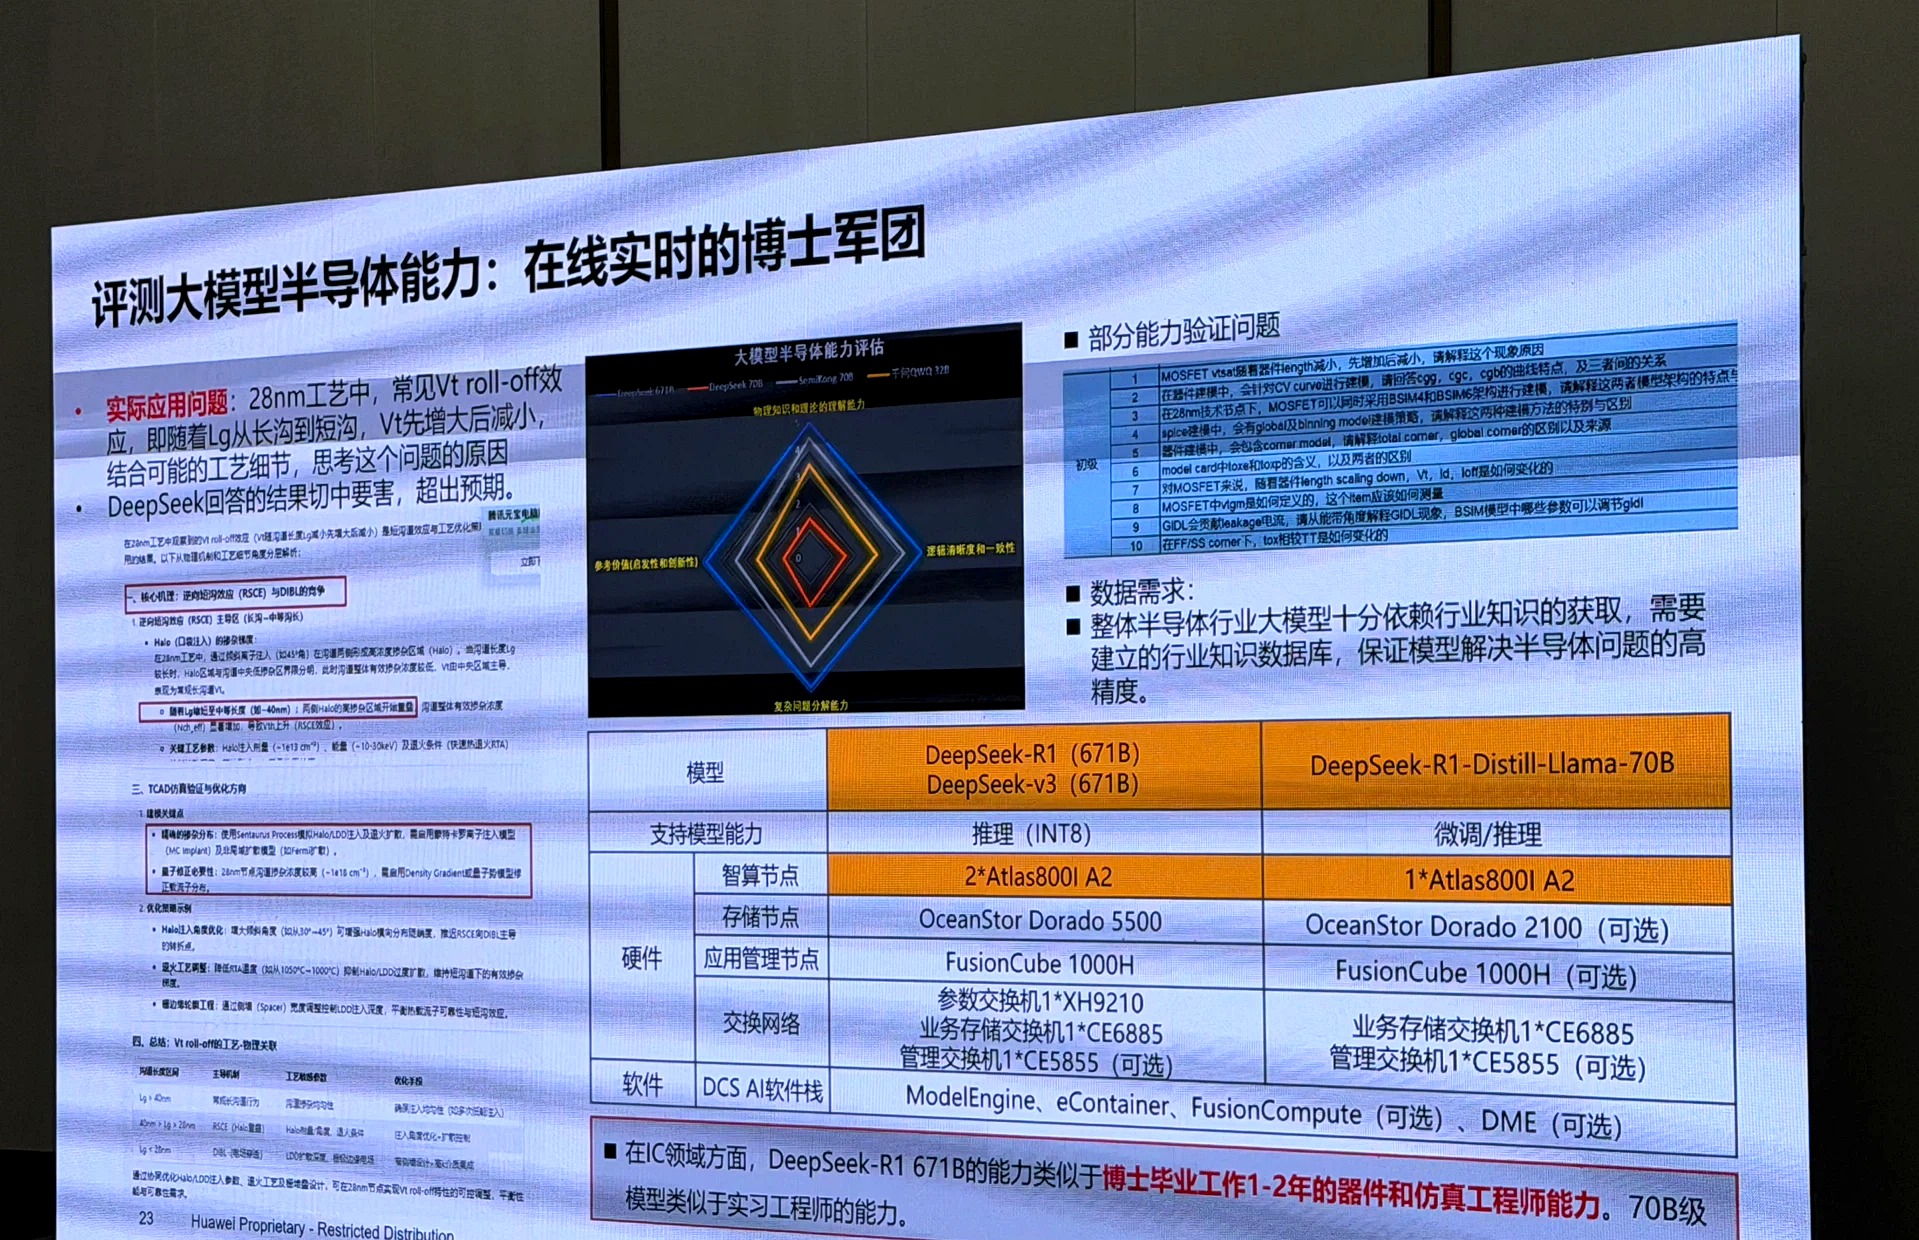
大模型评测放大
华为
通用大模型 ≈ 1–2 年器件工程师
行业知识库决定垂类上限。
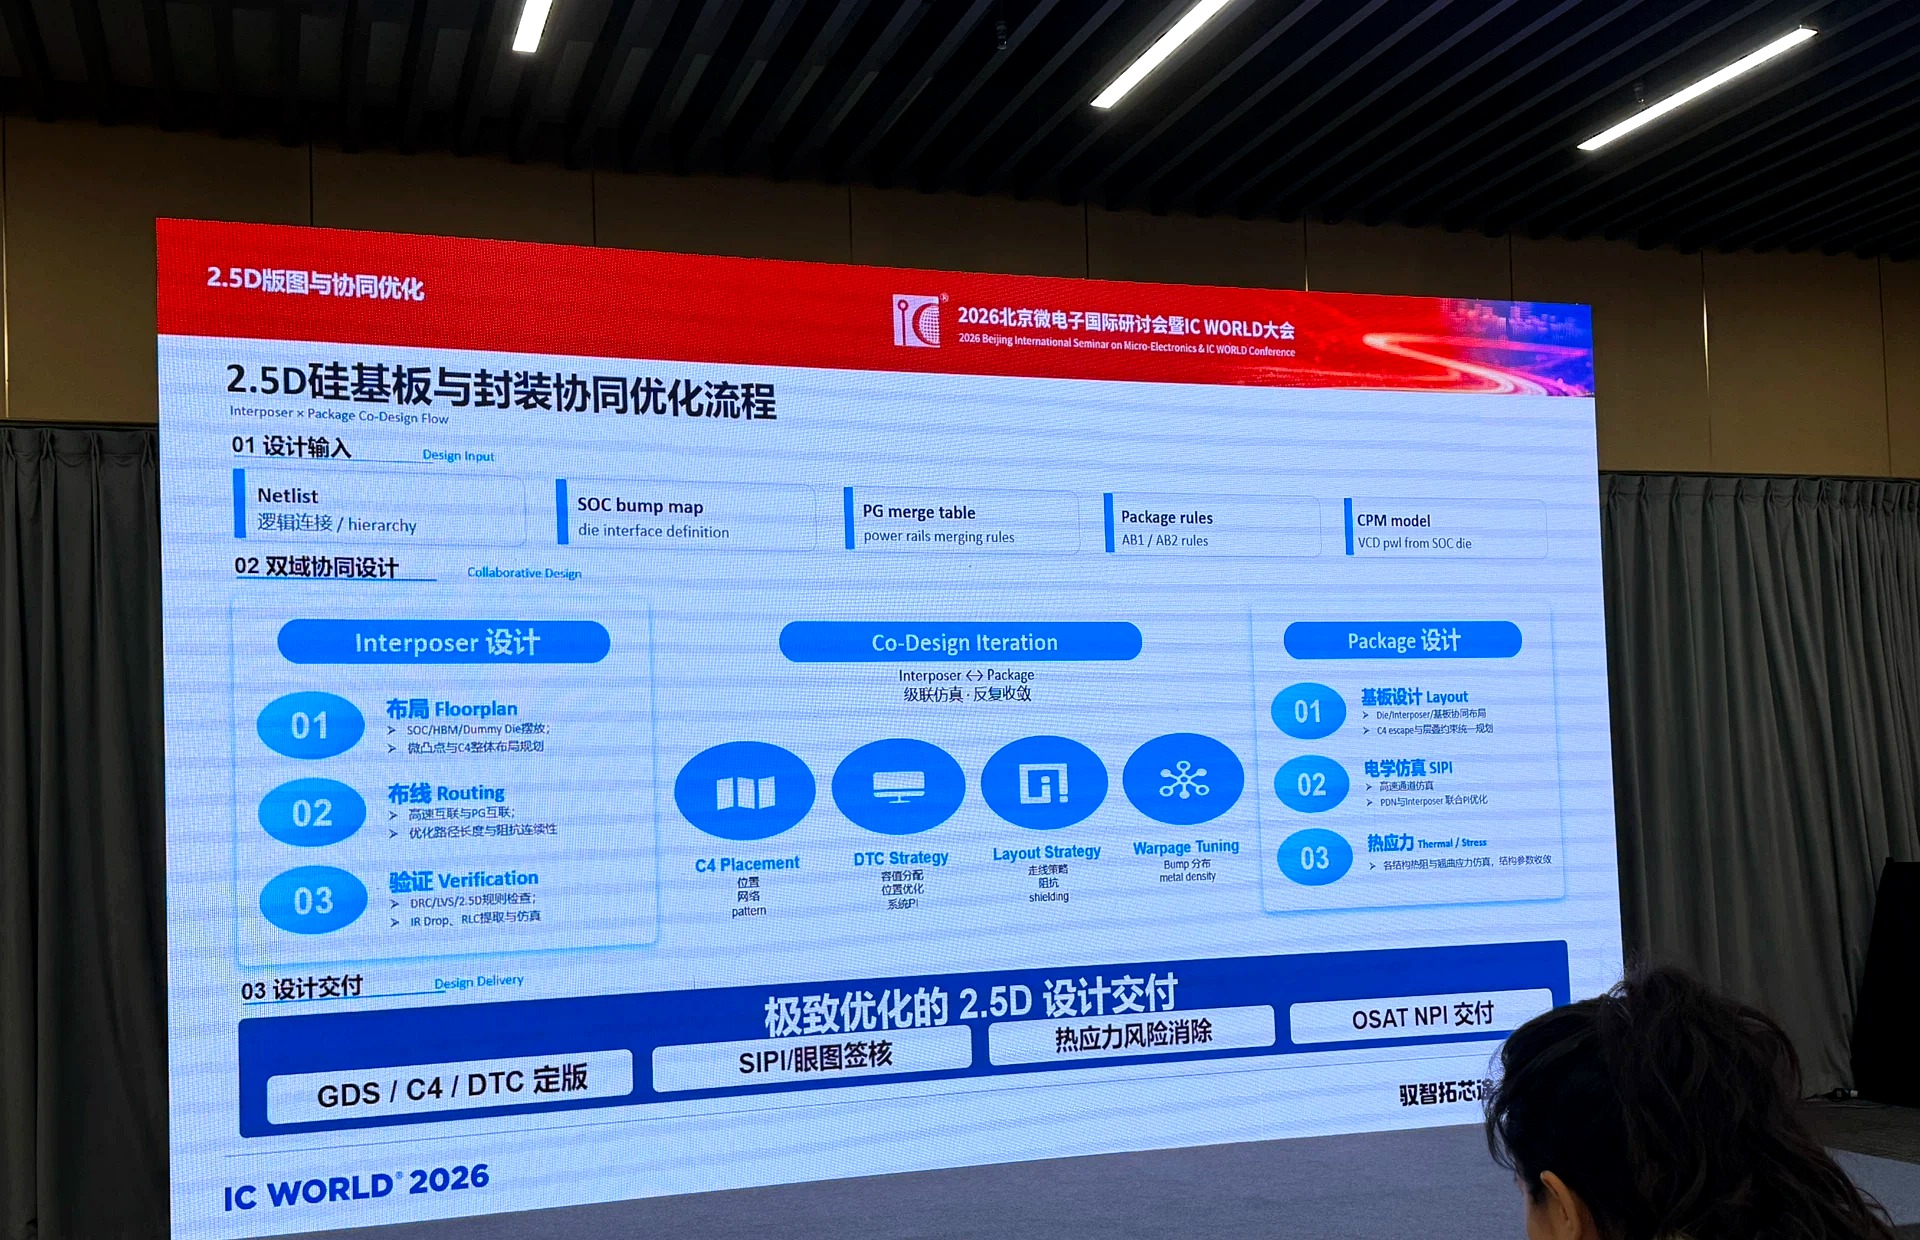
2.5D协同放大
合见工软
2.5D 版图协同优化
Interposer × Package Co-Design。
6.5 测试、新器件与 PINN 实证
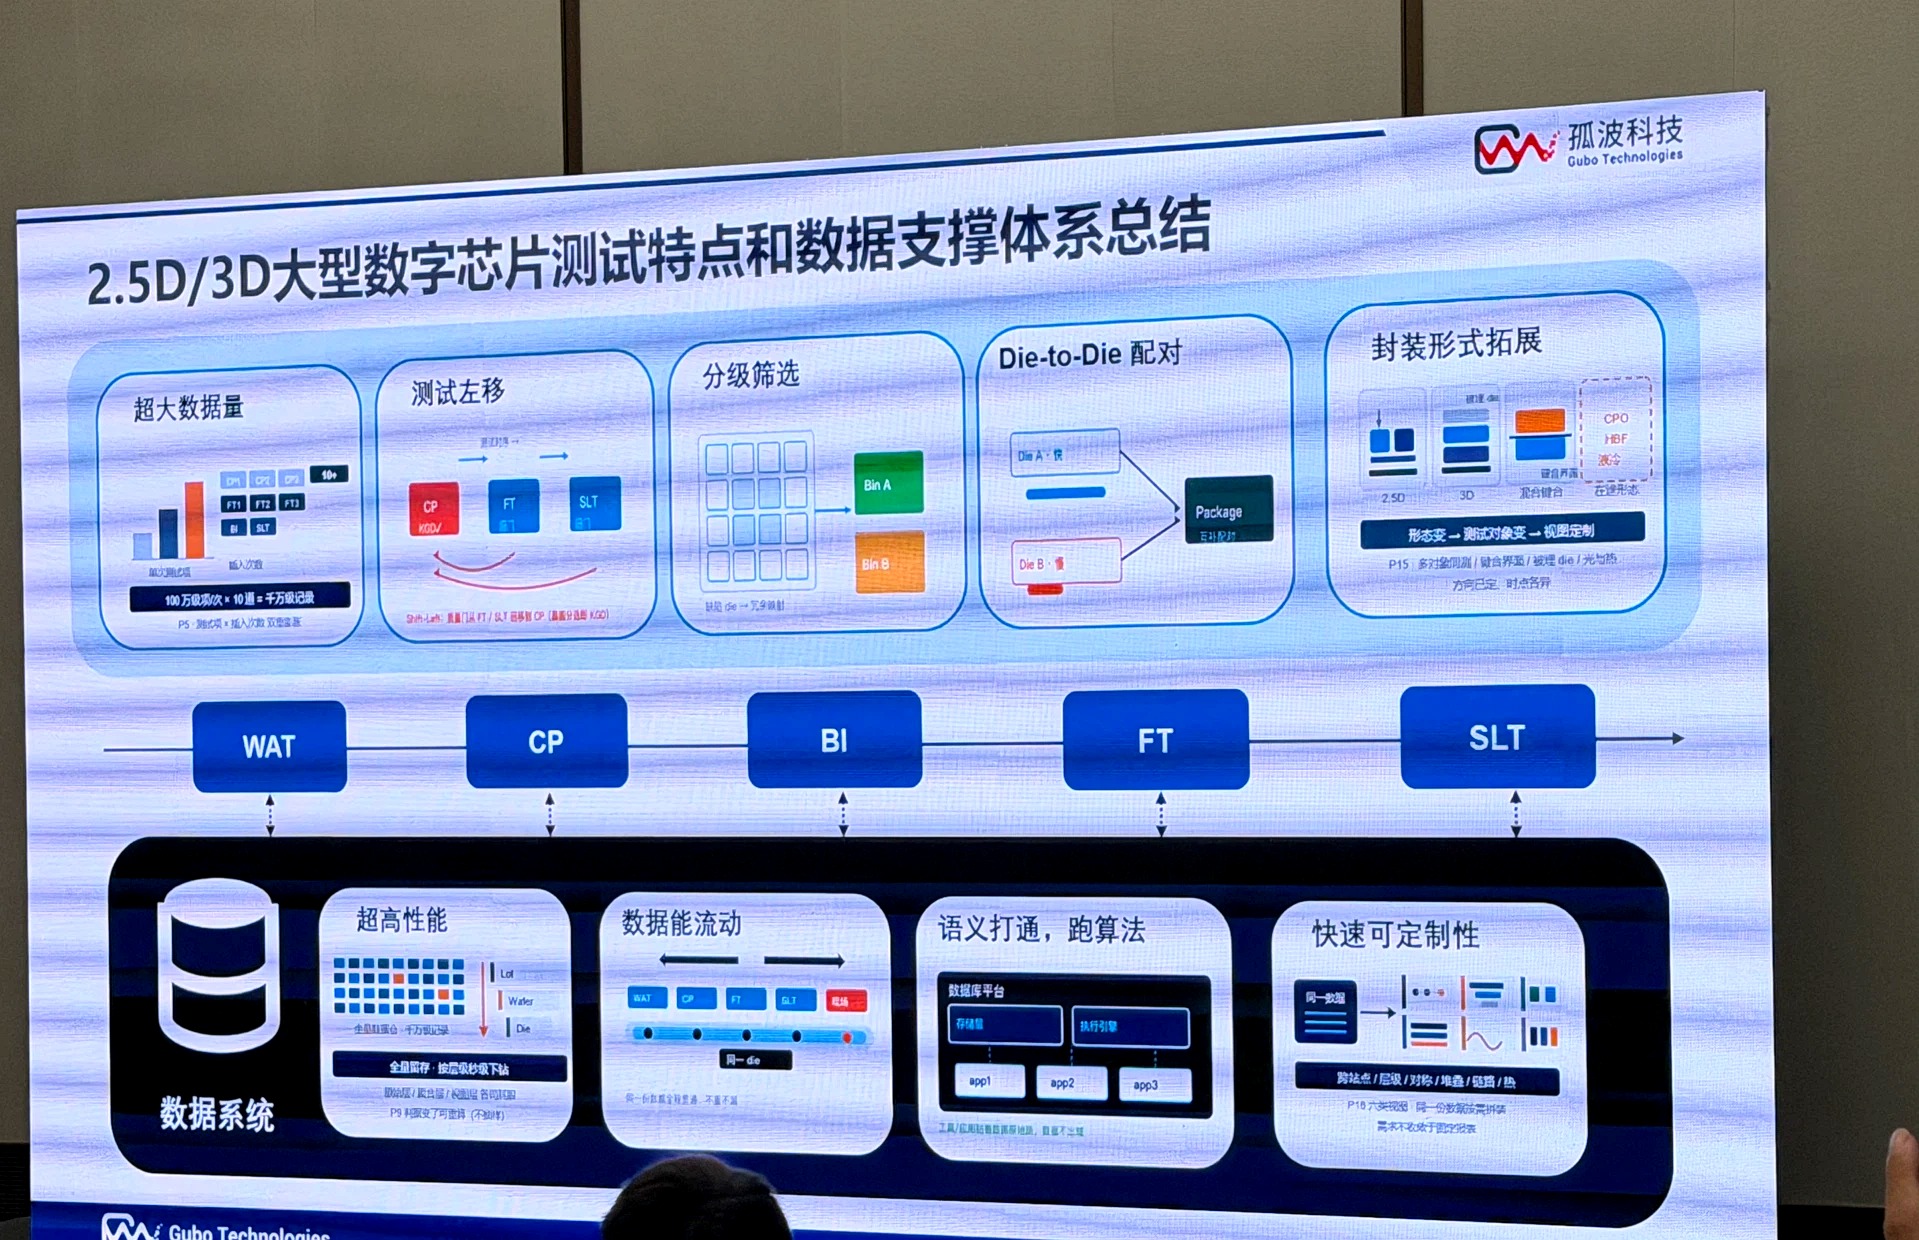
3D测试放大
孤波科技 / STIC
2.5D/3D 测试:超大数据量 × 测试左移
分级筛选与芯粒配对成新常态。
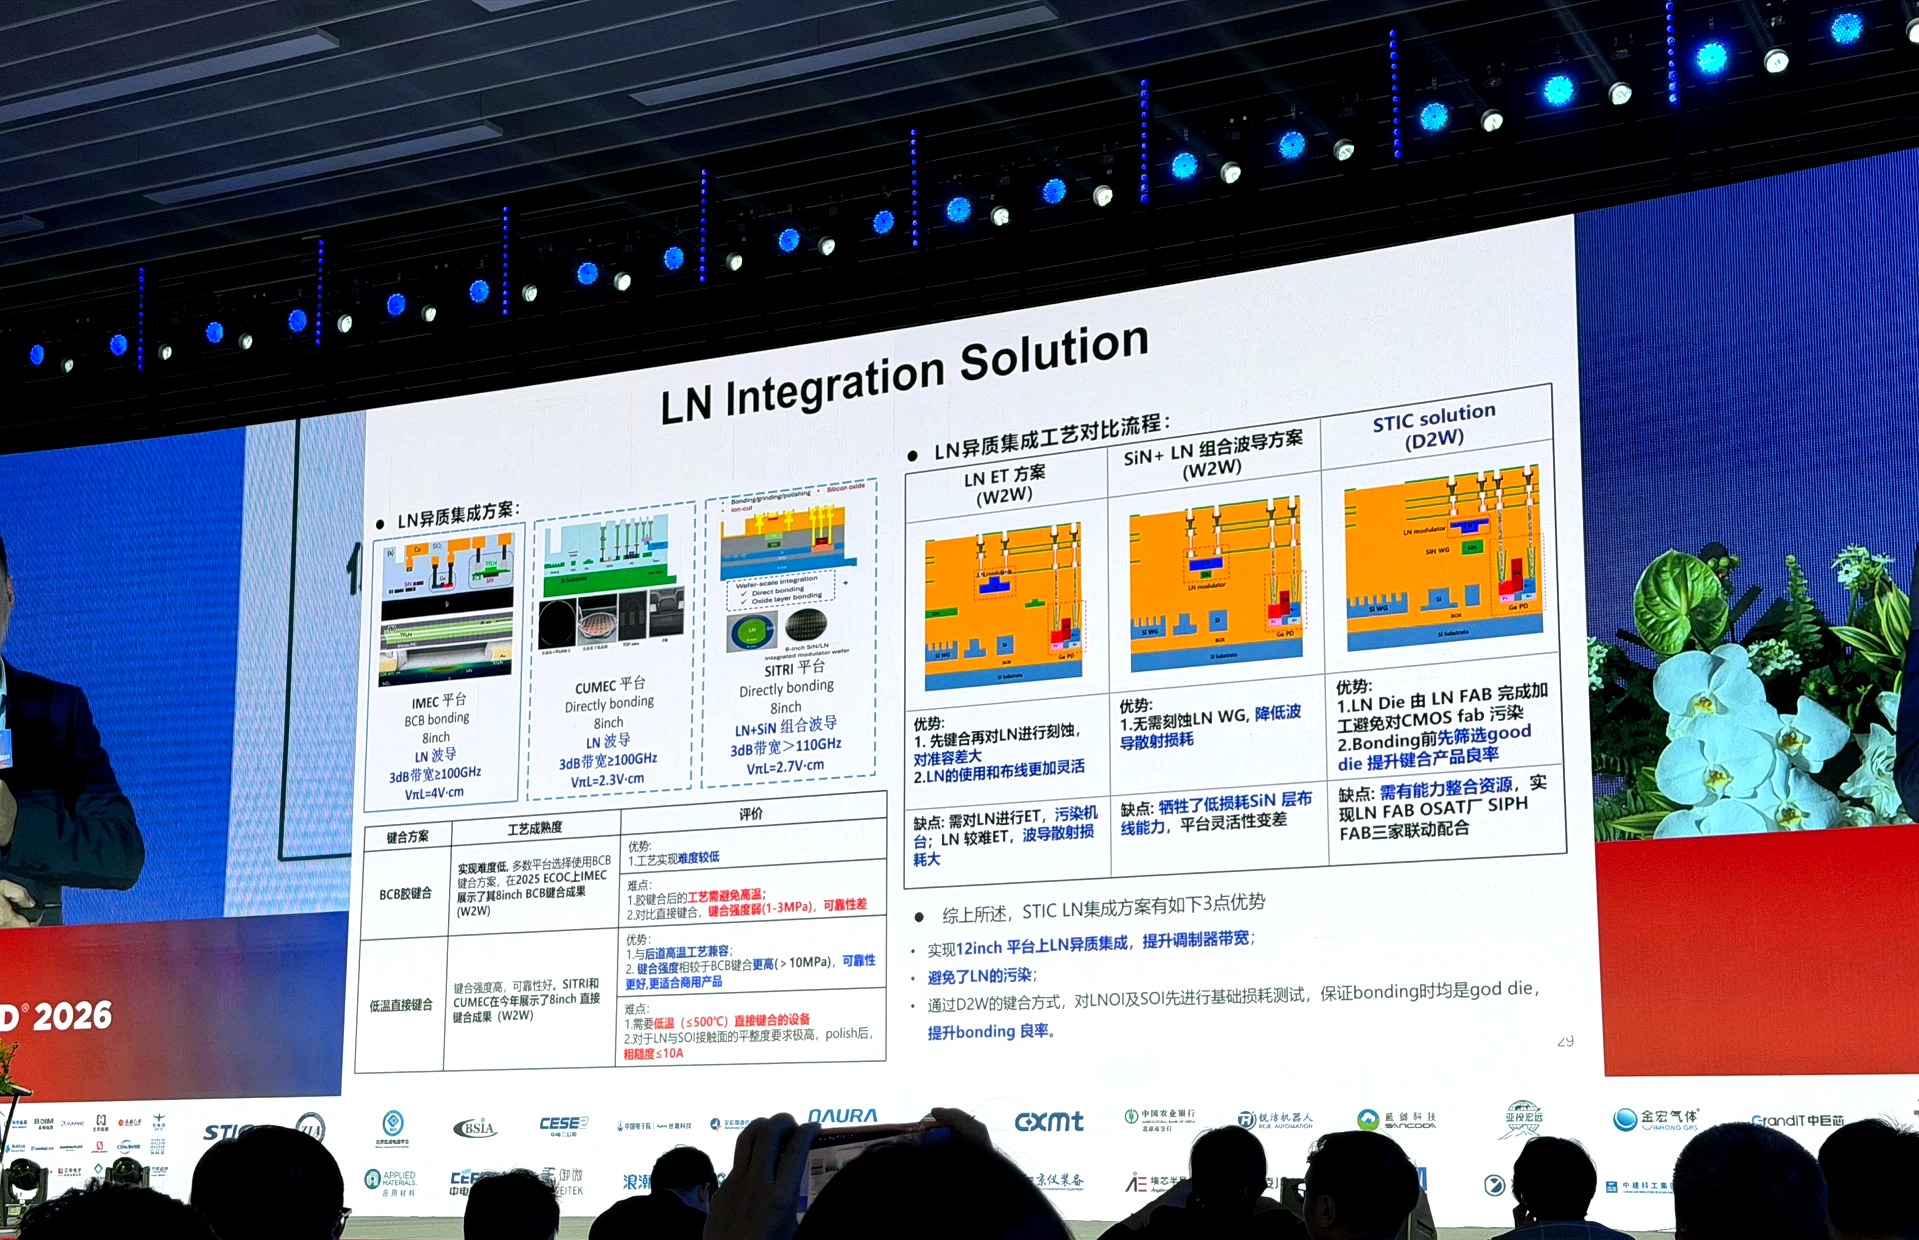
LN异质集成放大
SITRI 上海工研院
LN 异质集成:12 吋 D2W + SiN/LN 组合波导 >110GHz
直接键合 >10MPa、先筛 good die——异质材料集成的工程化样本。
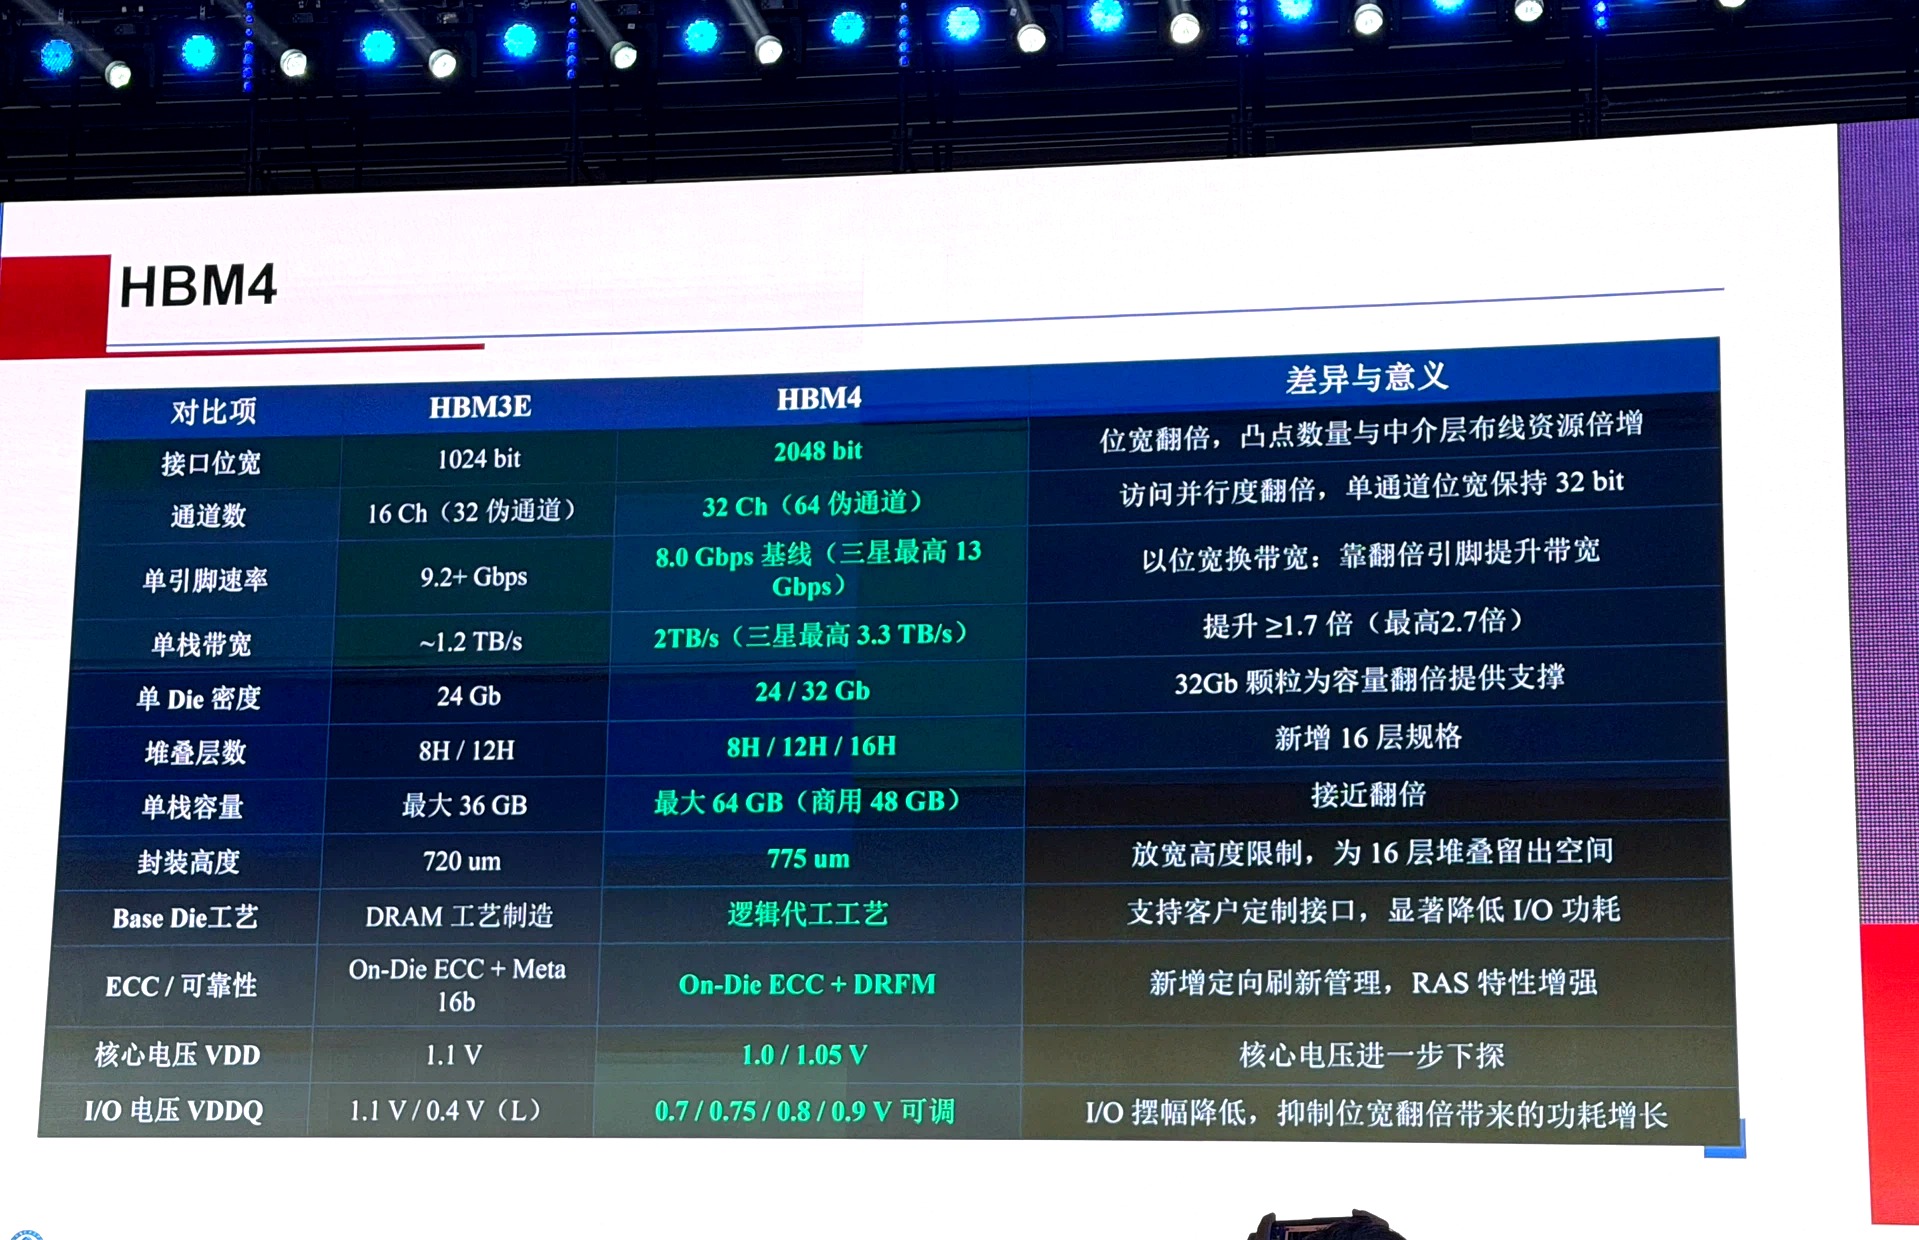
HBM4详解放大
STIC
HBM4 vs HBM3E 全参数对照
位宽翻倍、以位宽换带宽;I/O 摆幅下探抑制功耗增长。
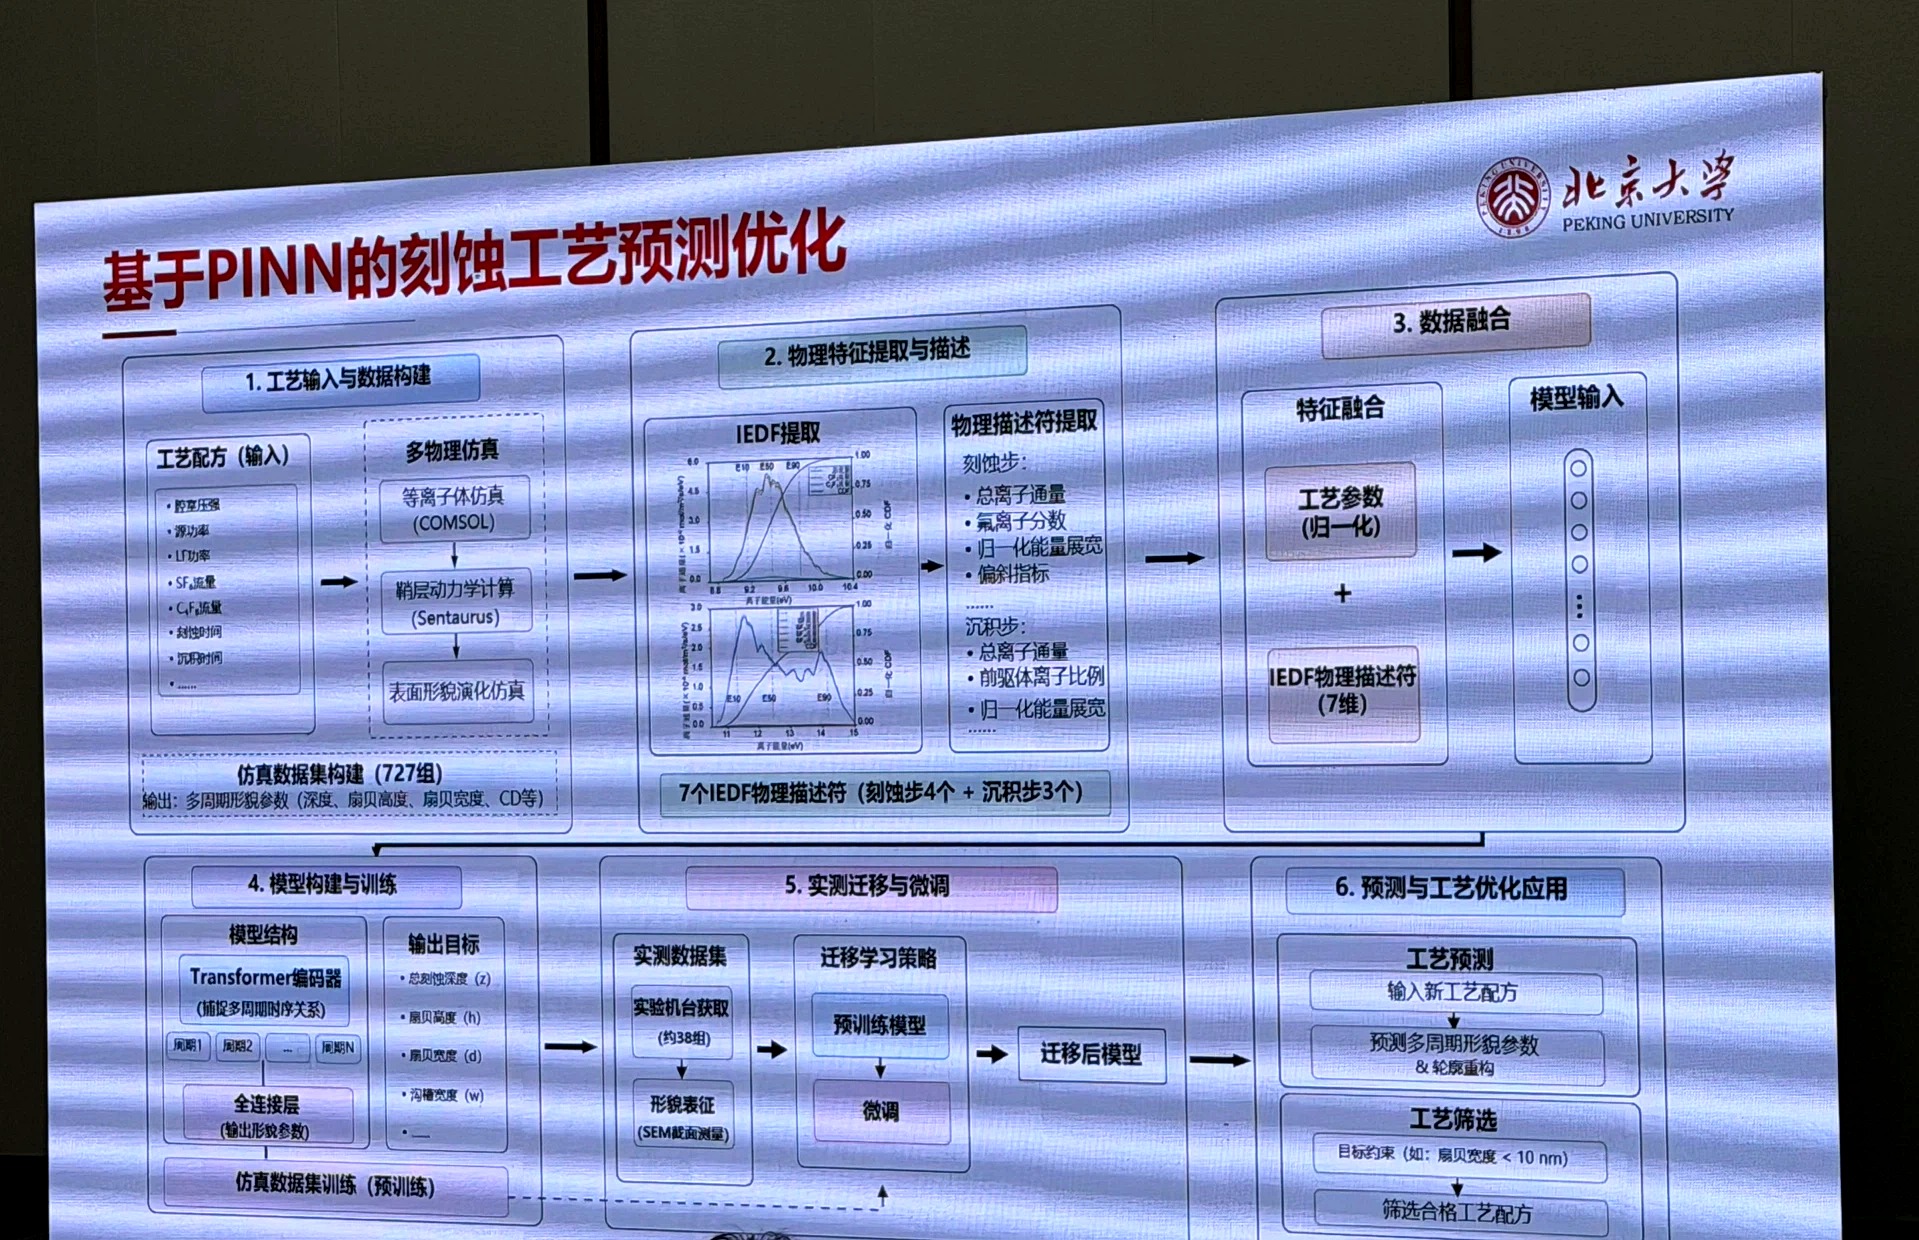
PINN刻蚀放大
北京大学
IEDF-PINN 刻蚀预测:仿真→物理描述符→实测迁移→工艺筛选
727 组仿真 + 38 组实测、7 维 IEDF 描述符、Transformer 时序编码——「物理特征融合 + 小样本迁移」的完整范本。
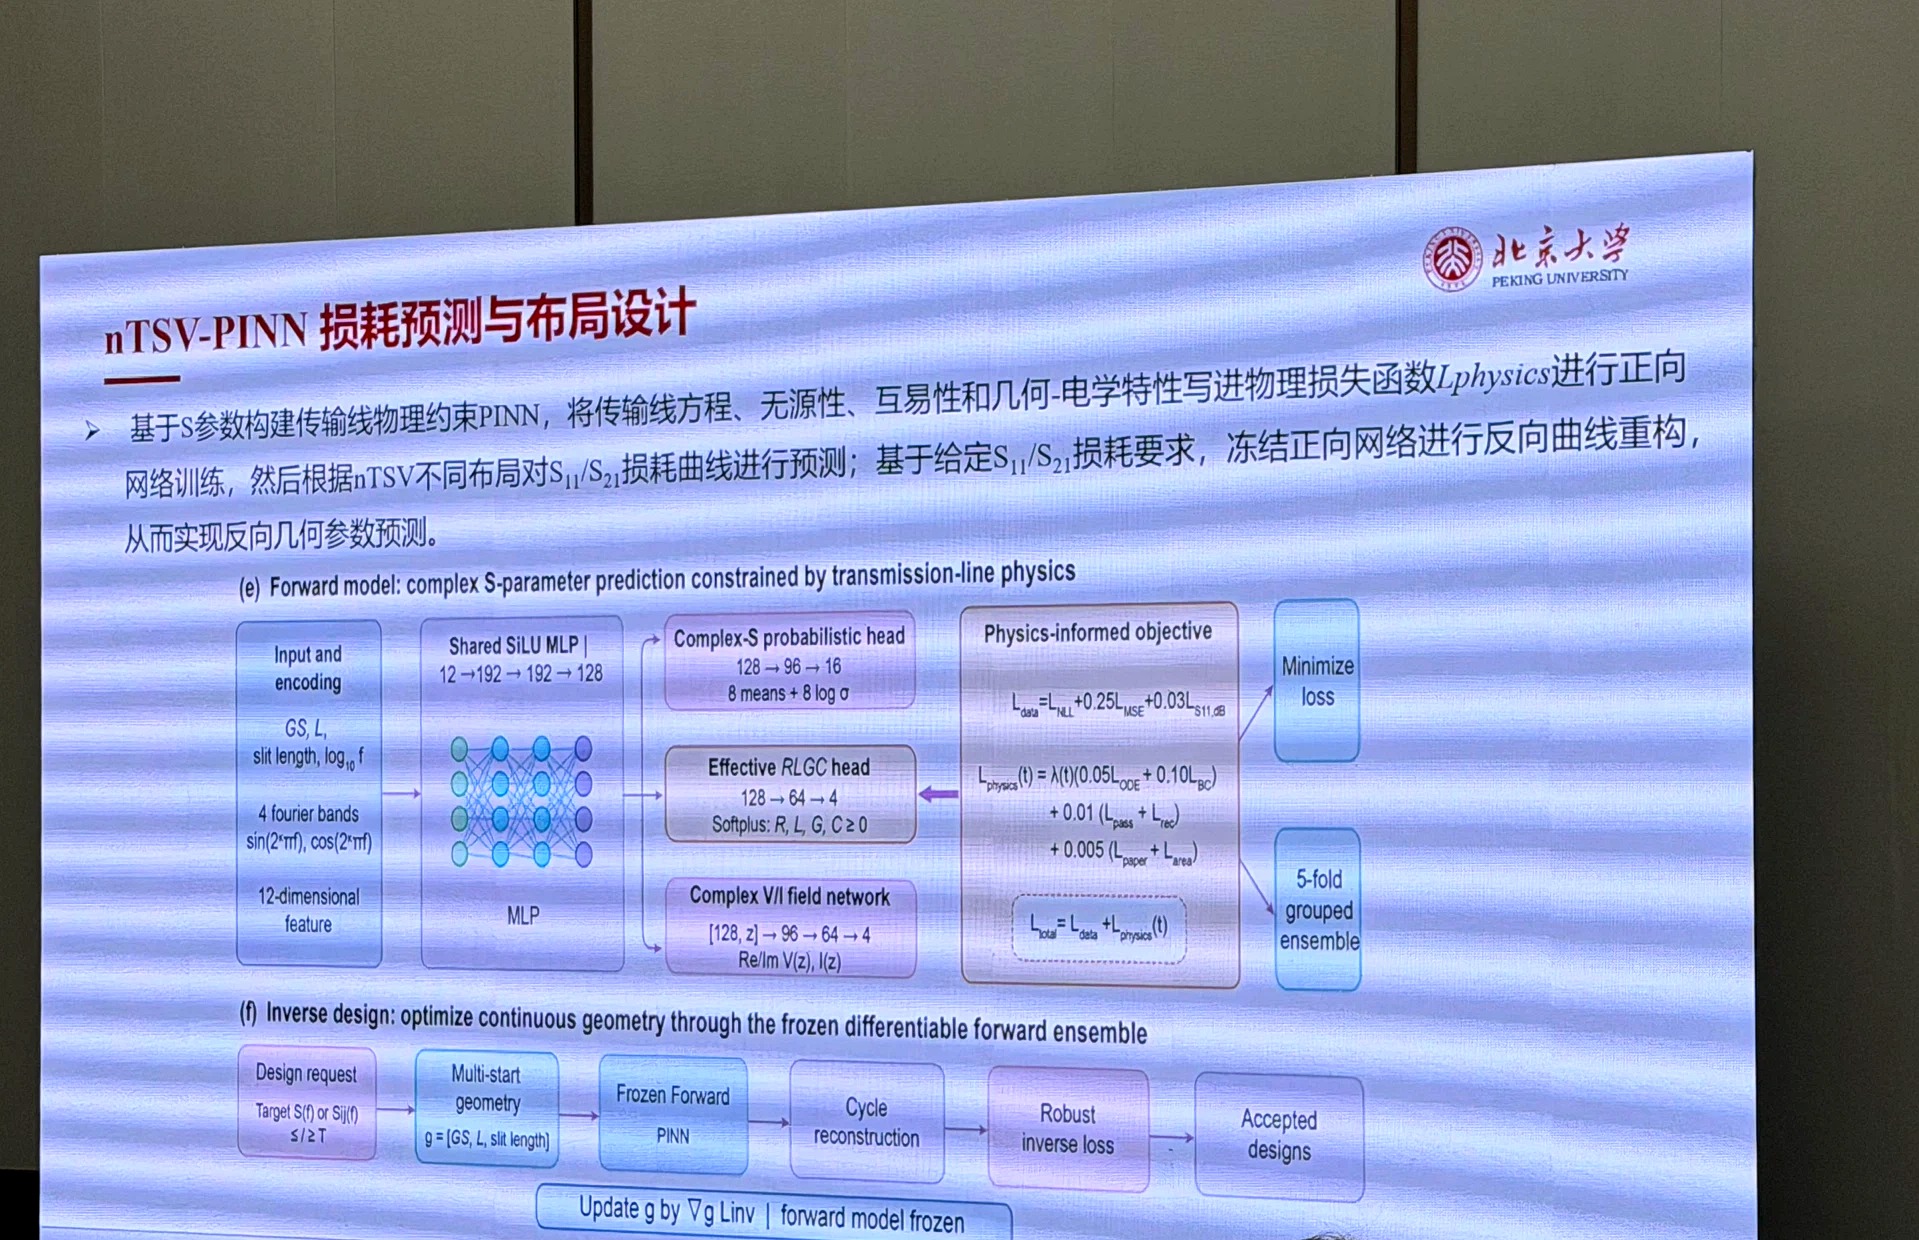
nTSV-PINN放大
北京大学
nTSV-PINN:物理约束写入损失函数的正逆两用模型
前向 S 参数预测(ODE/BC/无源性/互易性入损失)→ 冻结网络反向解几何——「仿真器即设计器」的实证。
6.6 附 · 华为《智能世界 2035》框架图(7 幅)

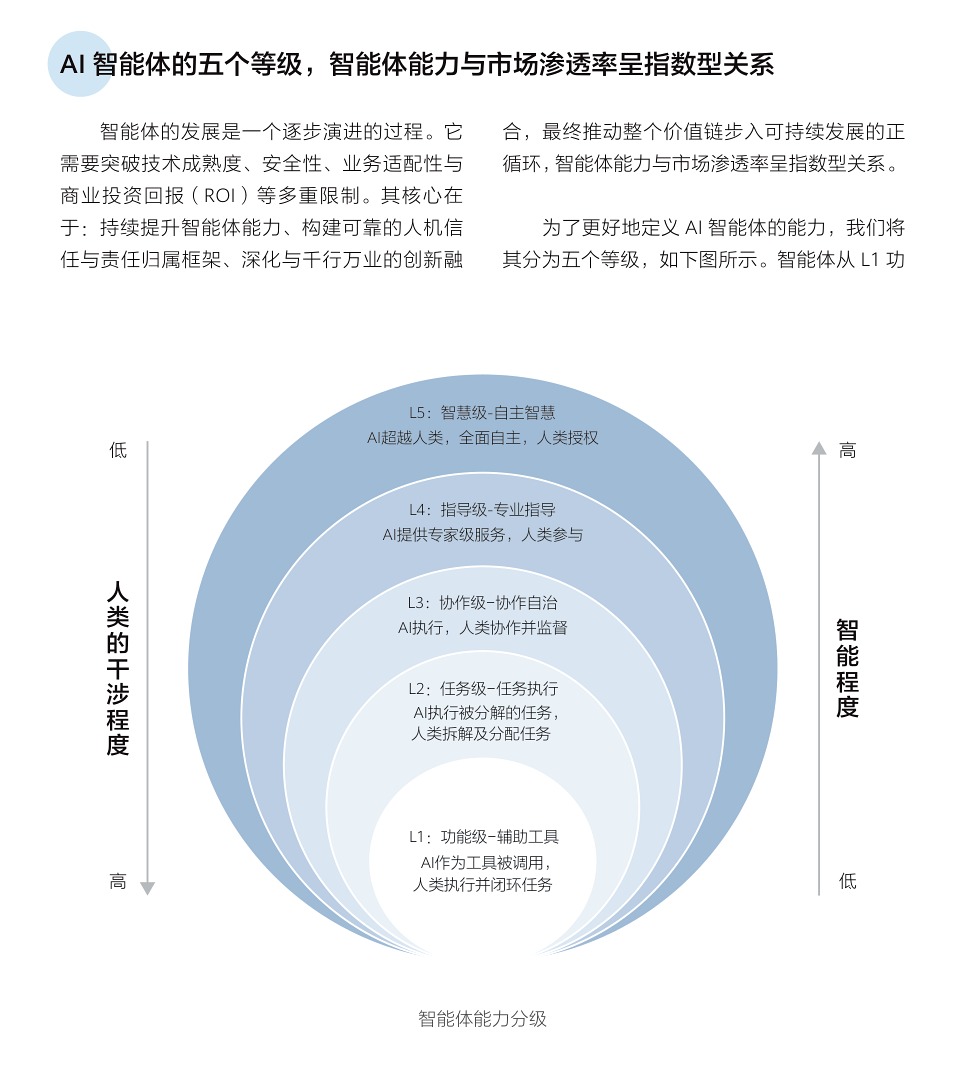
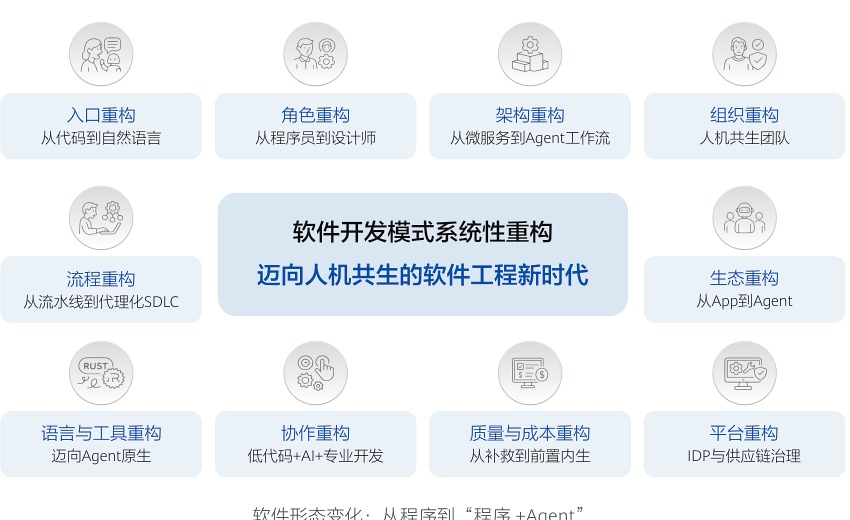
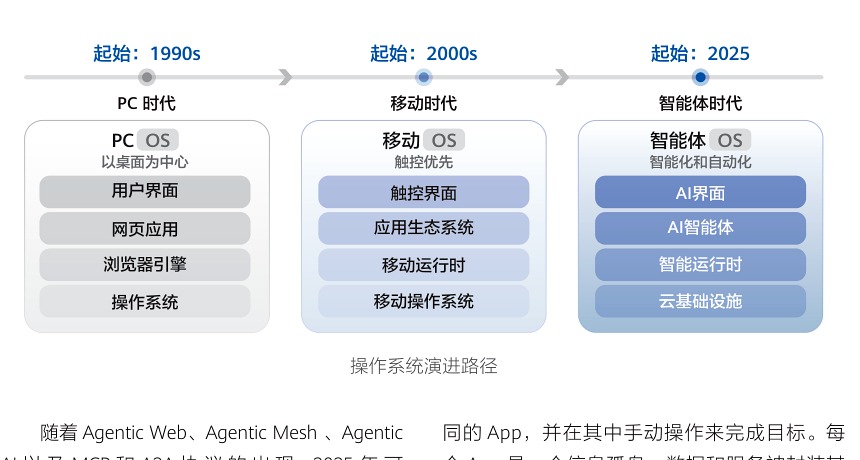
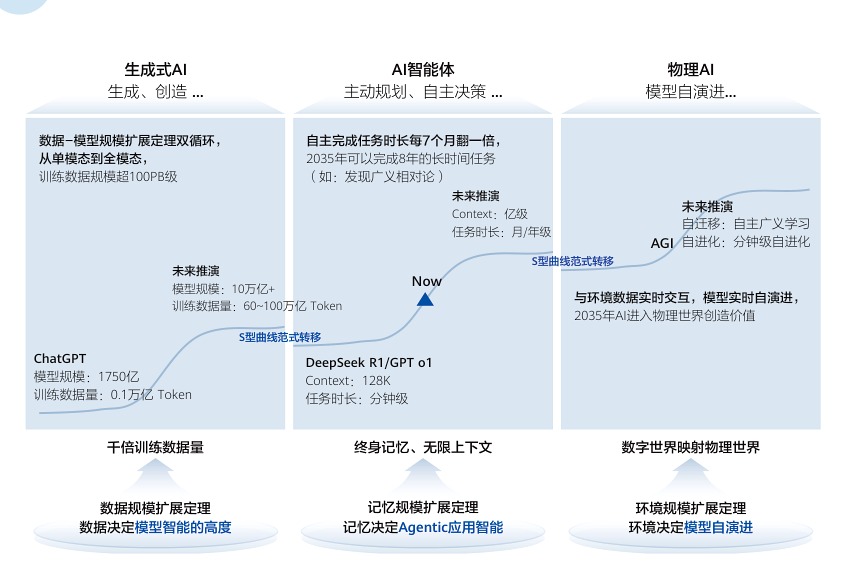
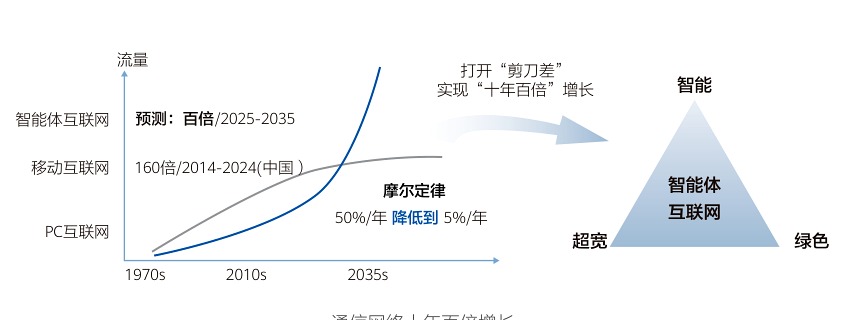
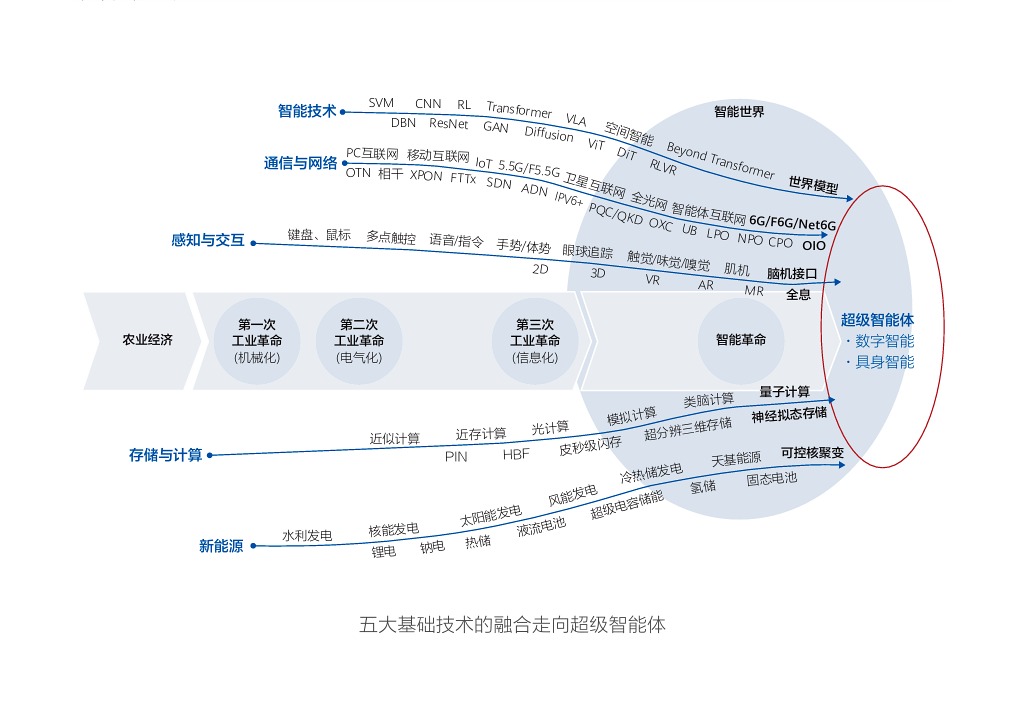
大会专题解读的华为报告原图:十大技术跃迁、智能体五级(L1→L5)、三扩展定理、计算范式四重跃迁、UB·LPO·NPO·CPO·OIO 光互联路线。配套预测:Token 消耗 10 万×、智能体流量占比 >90%。
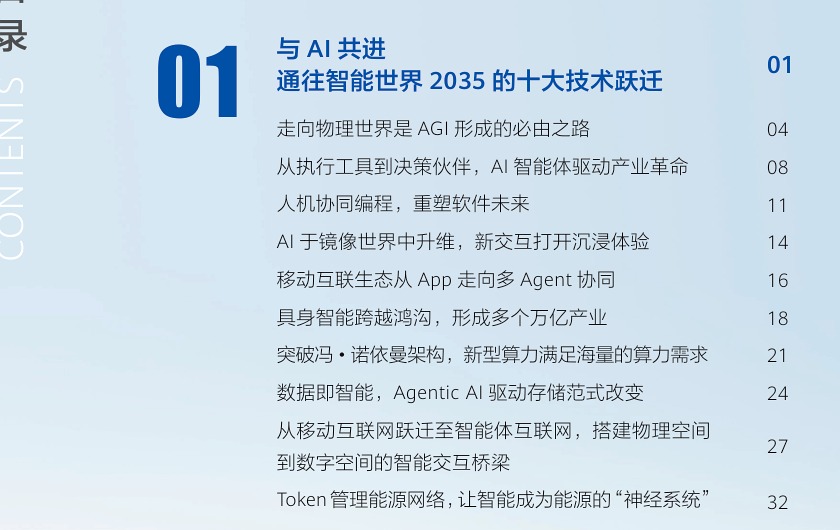
十大技术跃迁放大
框架图 01
十大技术跃迁 · 智能体五级
智能体五级放大
框架图 01b
AI 智能体五级:L1 工具 → L5 自主智慧
软件十大重构放大
框架图 02
软件十大重构 · OS 演进
交互演进放大
框架图 02b
CLI → GUI → NUI → SMUI
三扩展定理放大
框架图 03
三扩展定理 · 新 S 曲线
网络百倍放大
框架图 03b
网络十年百倍 · 参数竞争→数据竞争
五大技术融合放大
框架图 04
五大基础技术融合 → 超级智能体
结语 · KEY TAKEAWAYS

收束:五个可以带走的判断

01
周期:全球半导体 2026 达 $1.65 万亿(+108%)、存储 +305%——AI 是核心驱动力,但红利集中于 AI 链条,非普惠。
02
范式:互连密度取代晶体管密度成为第一变量——混合键合量产 6µm、路线至 3–4.5µm,异质异构集成是后摩尔主战场,也是中国绕开制程封锁的系统级路径。
03
方法:AI 重构设计/制造/EDA/测试/DTCO 全链,2026 年进入「自主等级」时代(L4 编排 / L5 超级智能体已演示);壁垒是方法学与数据闭环,不是模型。
04
蓝海:AI×可靠性是两大主线交汇处——失效升维(多物理场/跨芯粒)× 代理模型 10³–10⁶× 加速 × 测试左移/在线 RUL;全球尚无成熟方案,且与国产验证链数据入口重合。
05
终局:差距在单点、机会在系统;从「follow」到「define」——定义技术路线与标准者,定义未来。

定义技术路线者,定义未来

术语索引 · GLOSSARY

全部术语 · 检索即解

40 个核心概念按五类归档:器件工艺 / 封装互连 / AI 方法 / 可靠测试 / 产业标准。点击词条展开详解,词条注明正文章节可回跳;与图 3 可点击条形、图 5 层级筛选联动查阅。

附2
论文精读 · AI × IC / PINN × TCAD

学术证据链:代理模型如何吃掉物理仿真

把大会脉络与近两年公开论文对齐后,可以清楚看到同一条技术主线:把 PDE/物理方程写进损失函数,用神经网络替代 TCAD/FEM 求解——加速比从 10² 到 10⁶ 量级,精度损失控制在亚百分点。下图为通用范式,其后按论文逐篇拆解。

图 P1 PINN/算子代理通用范式与论文落位归纳自 R1–R8 及大会实拍
三条路线殊途同归:PDE 残差进损失 → 黑箱变物理自洽代理;输出端接 LUT/SPICE/EDA,才算进入工程链路。北大 nTSV-PINN 损失权重为大会投屏实拍
论文 / 出处
任务
方法核心
加速比 · 精度
EPG-TDDB PINN
ASP-DAC 2024 · 上海交大
Cu/Low-k BEOL 的 TDDB 寿命(离子扩散 PDE)
EPG 1-D 扩散方程 + PINN 硬约束优化
~100× vs FEM · MSE<0.1%
PINO Fe-VNAND
arXiv 2603.06881 · GaTech
铁电 V-NAND 保持特性(退极化+电荷退俘获)
物理信息神经算子 → ΔVth(t)→LUT/SPICE
>10⁴× vs TCAD · 天级→秒级
RelGAT
arXiv 2025
电路级 NBTI 老化预测
netlist→图注意力网络,节点级退化映射
1.7×10⁴× · 误差 1.27%
nTSV-PINN
北大 · 大会实拍
TSV 电热-应力场分布
多场 PDE 进损失,权重 λ_data:λ_PDE:λ_BC≈1:0.1:0.01
~10⁷× · R²>0.92
IEDF 刻蚀 PINN
大会实拍
等离子刻蚀速率/轮廓预测
离子能量分布函数→描述符→PINN 六步流水线
工艺替代级精度 · 大会口径
Mesh-Native PI Graph
R2 · TCAD-in-the-loop
TCAD 全场解的设计空间探索
网格原生图算子,直接吃 TCAD mesh
DSE 数量级加速
PEM RUL 代理
Microrel 2026
任务剖面→剩余寿命分布
退化方程代理 + 剖面序列化
~10⁶× · 在线预测可行
参考文献 · REFERENCES

可溯源清单:论文 · 标准 · 产业数据

本报告数据分三级:大会一手(IC World 2026 现场)、文献实证(DOI/arXiv 可溯)、产业口径(WSTS/Yole/公司发布)。引用时已就地标注来源。

A · AI × 可靠性与器件建模(第四章文献实证)
R1
Accelerating NBTI Aging Evaluation via Physics-Aware Graph Attention Networks. arXiv:2605.31092. RelGAT:网格→图、45 维物理编码、均误差 1.27%、~17,000× TCAD。
R2
Mesh-Native Physics-Informed Graph Surrogates for TCAD-in-the-Loop Design Space Exploration. arXiv:2609.02988. 四面体网格 + 有限体积电流连续残差。
R3
Neural network approach to NBTI/HCD coupled failure analysis of MOS ICs. Microelectronics Reliability, 2025. PINN-LSTM 联合失效模型,ΔVth 均误差 11.92%。
R4
A Physics-Related Parameter Decoupling and Self-Attention-Based Framework for NBTI Aging Prediction (APPD-Net). IEEE Trans. Electron Devices, 2026. 20% 数据、SPICE 紧凑老化模型。
R5
Physics-Informed Learning for EPG-Based TDDB Assessment. ASP-DAC 2024. PINN 解扩散 PDE,较 FEM ~100×、MSE<0.1%。
R6
Physics-informed AI Accelerated Retention Analysis of Ferroelectric Vertical NAND (PINO). arXiv:2603.06881. >10,000× TCAD,产出紧凑模型/LUT。
R7
AI surrogate models for lifetime prediction in power electronic modules. Microelectronics Reliability, 2026. 任务剖面 RUL,代理模型 10⁶×。
R8
EMaper: Cross-level Electromigration Aware Placement and Routing EDA Workflow. DATE 2026. 消除 92.1–100% EM 违规、代价 4.5–16.3%。
R9
On-chip aging sensors: Karimpour et al., HCI 在线监测传感器(ITC 2025);Tamakloe et al., BTI 紧凑在片传感器(MWSCAS 2025);另见 GNN4REL(IEEE TCAD 2022)、GridNetOpt(全芯片 EM 感知电网优化)。
R10
JEDEC JEP122H《Failure Mechanisms and Models for Semiconductor Devices》(失效机理与模型族、Ea/加速因子);JESD47I(硅器件鉴定)、JESD94(知识驱动应用鉴定)、JESD91(加速模型)、JESD85(FIT);TI SPRABX4《Calculating Useful Lifetimes of Embedded Processors》(任务剖面 EM 寿命方法)。
B · AI 设计与 AI EDA(第三章文献实证)
P1
A graph placement methodology for fast chip design (AlphaChip). Nature 594:207–212, 2021;Addendum 2024。Google 开源 circuit_training。
P2
VerilogCoder(NVIDIA, AAAI):AST 波形追踪 + 图规划多智能体,VerilogEval-Human v2 94.2%;MAGE(arXiv:2412.07822):开源多智能体 RTL 引擎 95.7%。
P3
ChatEDA / AutoMage(CUHK Bei Yu 组,IEEE TCAD):LLM 驱动 RTL→GDSII 自主代理;EDAid(NAACL 2025)多智能体发散思维协作。
P4
PAICORE: A 1.9-Million-Neuron 5.181-TSOPS/W Digital Neuromorphic Processor. IEEE JSSC 60(2):651–671, 2025(北京大学,1024 核/47.73 亿突触/GALS)。
C · 3D IC / 异质异构集成标准与产业口径(第二章实证)
S1
IEEE EPS Heterogeneous Integration Roadmap (HIR) 2025 Edition. 异质集成定义、六大市场驱动、面向 2034 的技术需求图谱(SiP / 材料与界面 / CPO 章节)。
S2
UCIe 3.0 Specification(UCIe Consortium, 2025.8):48/64 GT/s、sideband 100mm、MTP、Fast Throttle、运行时重校准。
S3
UALink 200G Rev 1.0(UALink Consortium, 2025.4):200G/lane、≤1024 加速器/域、<1µs 往返。
S4
OCP HBF 首份技术规范(Sandisk × SK hynix, FMS 2026.8):8/16Hi、≤512GB、0.4–3.0TB/s、UCIe;Google/Tenstorrent 入盟。
S5
混合键合路线:TSMC SoIC 9µm(2023)→6µm(2025 HVM)→4.5µm(2029E),二代 F2F;Intel Foveros Direct 9µm→3µm Gen2、18A-PT、EMIB 3.5D(Intel Foundry 技术简报 2025.11);JEDEC 放宽 HBM 堆高 → HB 存储延至 HBM4E/HBM5(Tom's Hardware 2026)。
S6
先进封装市场:Yole《Status of the Advanced Packaging Industry 2026》$55B(2025)→$120B+(2031);Sigmaintell 2026 $58.7B(+97%)、2.5D/3D 缺口 23%、产能 CAGR 77%(2025–27);Chiplet $15.8B(2025)→$43.9B(2032,QYResearch)。
S7
玻璃基板:京东方 ¥9.93 亿板级中试线全自动通线、20 层原型交付、康宁三年 MoU;Intel×蓝思 TGV;三星 GlaSSEM 延至 2028+;TSMC CoPoS 310×310mm 面板 2026 验证/2028H2 量产(TrendForce 2026.7-8)。
D · 市场与政策(第一、五章实证)
M1
WSTS Spring 2026 Forecast:2026 $1.51T(+90%)、存储 +250%/$800B+、逻辑 +37%;Q2 2026 修正:H1 $702B(+102%)、存储 +305%、全年 $1.655T(+108%)、2027 ~$2.1T。
M2
NVIDIA × TSMC:cuLitho 投产(GTC 2024,40–60×、350 H100 替代 4 万 CPU、生成式 AI 再 +2×);GTC Taipei 2026 CUDA-X/Metropolis/TAO 全栈入厂。
M3
Synopsys AgentEngineer:Converge 2026 演示业界首个 L4 编排式多智能体工作流;DAC 2026 自主验证 agent 50×、debug 闭环 -25~40%(Microsoft Discovery / AMD)。Cadence ChipStack L5(Computex 2026):RTL 验证 40×、5 周→<1 天、NVIDIA OpenShell。
M4
端侧 AI:Frost & Sullivan——全球 2025 ¥3219 亿→2029 ¥1.22 万亿(CAGR ~40%);AI PC 2026 出货 1.43 亿台、渗透率 55%。光模块:高盛 2026 $67.7B→2028 $148.5B;800G+ $11.8B→$129.6B(CAGR 69%)。
M5
华为《智能世界 2035:从愿景到行动》(2026.9):十大关键命题、Token 全链路基础设施、韬定律(时间缩微)、智能体五级、GDII 2026(AI 五年 $27 万亿)。
M6
政策:2026 政府工作报告(新兴支柱产业);电子信息制造业「十五五」规划;北京经开区 AI4Chip 20 条(≥30 亿基金/5000P 智算/2028 培育 3–5 家领军企业)。